

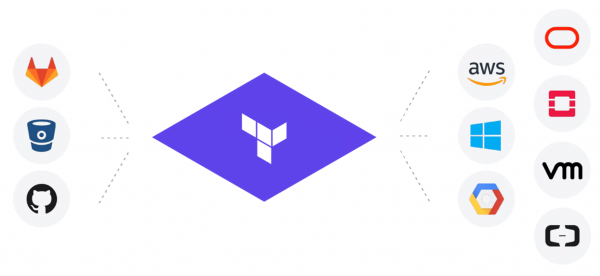
Je voudrais parler d'un nouvel outil CLI que j'ai développé pour résoudre un ancien problème.
Le problème
Terraform est déjà devenu une norme dans la communauté DevOps/Cloud/IT. C'est un outil très pratique et utile pour gérer l'infrastructure en tant que code. Il y a beaucoup d'avantages à utiliser Terraform, mais aussi de nombreux pièges, couteaux aiguisés et obstacles.
Avec Terraform, il est très facile de créer de nouvelles choses, puis de les gérer, les modifier ou les supprimer. Mais que faire si l'on dispose d'une grande infrastructure dans le cloud qui n'a pas été créée avec Terraform ? Réécrire et recréer tout le cloud peut être coûteux et risqué.
J'ai rencontré ce problème dans deux emplois, le plus simple étant de vouloir que tout soit sous git sous forme de fichiers Terraform, alors qu'il y a plus de 250 buckets et qu'écrire manuellement des fichiers Terraform pour tous cela représente beaucoup de travail.
Oui Depuis 2014, avec Terraform qui a été fermé en 2016, en espérant qu'il serait possible d'importer.
En gros, tout est comme sur l'image, mais de droite à gauche.
Avertissement : L'auteur vit depuis longtemps hors de Russie et écrit peu en russe. Faites attention aux fautes d'orthographe.
Solutions
1. Il existe des solutions existantes et anciennes pour AWS. . Lorsque j'ai essayé de récupérer mes 250+ buckets avec cela, j'ai compris que c'était en mauvais état. AWS a depuis longtemps ajouté de nombreuses nouvelles options dont terraforming n'est pas au courant, et de plus, il utilise Ruby. . Après avoir envoyé un email le soir à deux heures, pour ajouter plus de fonctionnalités là-dedans, j'ai compris que ce type de solution ne convenait pas du tout.
Comment fonctionne terraforming ? Il prend des données de l'API SDK AWS et génère des fichiers tf et tfstate à partir de templates.
Il y a trois problèmes :
1. Il y aura toujours un retard dans les mises à jour.
2. Les fichiers tf sont parfois corrompus.
3. Le tfstate est généré séparément du tf et ne correspond pas toujours.
En général, il est difficile d'obtenir un résultat où `terraform plan` affiche qu'il n'y a pas de changements.
2. `terraform import` est une commande intégrée à Terraform. Comment ça fonctionne ?
Vous écrivez un fichier TF vide avec le nom et le type de la ressource, puis vous exécutez `terraform import` et transmettez l'ID de la ressource. Terraform interroge le fournisseur, récupère les données et crée un fichier tfstate.
Il y a trois problèmes :
1. Vous obtenez seulement le fichier tfstate, le tf est vide et doit être écrit manuellement ou converti depuis le tfstate.
2. Cela ne fonctionne qu'avec une seule ressource à la fois et ne prend pas en charge toutes les ressources. Et que dois-je faire de mes 250+ buckets ?
3. Vous devez connaître les ID des ressources, c'est-à-dire que vous devez envelopper cela dans du code qui récupère la liste des ressources.
En général, le résultat est partiel et n'est pas facilement évolutif.
Ma solution
Exigences :
1. Possibilité de créer des fichiers tf et tfstate à partir des ressources. Par exemple, télécharger tous les buckets/groupe de sécurité/équilibreur de charge et ce que `terraform plan` a renvoyé qu'il n'y a pas de modifications
2. Deux clouds GCP + AWS
3. Solution globale facile à mettre à jour à chaque fois, sans passer trois jours de travail sur chaque ressource
4. Faire en open source — c'est un problème que tout le monde rencontre
Langage Go — c'est pourquoi je l'aime, et il existe une bibliothèque pour créer des fichiers HCL qui sont utilisés dans terraform + beaucoup de code dans terraform qui peut être utile
Chemin
Première tentative
J'ai commencé par une version simple. Appels au cloud via SDK pour obtenir la ressource nécessaire et la convertir en champs pour terraform. La tentative a échoué immédiatement sur le groupe de sécurité car je n'ai pas aimé convertir seulement le groupe de sécurité pendant 1,5 jour (et il y a beaucoup de ressources). C'est long et ensuite les champs peuvent changer/être ajoutés
Deuxième tentative
Basée sur l'idée décrite . Il suffit de prendre et de convertir tfstate en tf. Toutes les données sont là et les champs sont les mêmes. Comment obtenir un tfstate complet pour plusieurs ressources ? Ici, la commande `terraform refresh` est venue à mon aide. Terraform prend toutes les ressources dans tfstate et extrait les données par ID, puis écrit tout dans tfstate. C'est-à-dire créer un tfstate vide uniquement avec des noms et IDs, lancer `terraform refresh` et nous obtenons des tfstate complets. Hourra !
Nous allons maintenant écrire un convertisseur pour tfstate vers tf de manière récursive. Pour ceux qui n'ont jamais lu tfstate, c'est JSON, mais particulier.
Voici sa partie importante attributes
 "attributes": {
                            "id": "default/backend-logging-load-deployment",
                            "metadata.#": "1",
                            "metadata.0.annotations.%": "0",
                            "metadata.0.generate_name": "",
                            "metadata.0.generation": "24",
                            "metadata.0.labels.%": "1",
                            "metadata.0.labels.app": "backend-logging",
                            "metadata.0.name": "backend-logging-load-deployment",
                            "metadata.0.namespace": "default",
                            "metadata.0.resource_version": "109317427",
                            "metadata.0.self_link": "\/apis\/apps\/v1\/namespaces\/default\/deployments\/backend-logging-load-deployment",
                            "metadata.0.uid": "300ecda1-4138-11e9-9d5d-42010a8400b5",
                            "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
Ici, nous avons :
1. id — chaîne
2. metadata — tableau de taille 1 contenant un objet avec les champs décrits ci-dessous
3. spec — hachage de taille 1 avec key,value
En gros, un format amusant, tout peut également être imbriqué sur plusieurs niveaux
                   "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
                            "spec.0.selector.0.match_expressions.#": "0",
                            "spec.0.selector.0.match_labels.%": "1",
                            "spec.0.selector.0.match_labels.app": "backend-logging-load",
                            "spec.0.strategy.#": "0",
                            "spec.0.template.#": "1",
                            "spec.0.template.0.metadata.#": "1",
                            "spec.0.template.0.metadata.0.annotations.%": "0",
                            "spec.0.template.0.metadata.0.generate_name": "",
                            "spec.0.template.0.metadata.0.generation": "0",
                            "spec.0.template.0.metadata.0.labels.%": "1",
                            "spec.0.template.0.metadata.0.labels.app": "backend-logging-load",
                            "spec.0.template.0.metadata.0.name": "",
                            "spec.0.template.0.metadata.0.namespace": "",
                            "spec.0.template.0.metadata.0.resource_version": "",
                            "spec.0.template.0.metadata.0.self_link": "",
                            "spec.0.template.0.metadata.0.uid": "",
                            "spec.0.template.0.spec.#": "1",
                            "spec.0.template.0.spec.0.active_deadline_seconds": "0",
                            "spec.0.template.0.spec.0.container.#": "1",
                            "spec.0.template.0.spec.0.container.0.args.#": "3",
En gros, si quelqu'un veut un exercice de programmation pour un entretien, il suffit de demander d'écrire un parseur pour cela 🙂
Après de nombreuses tentatives pour écrire un parseur sans bugs, j'ai trouvé une partie de celui-ci dans le code Terraform, d'ailleurs la partie la plus importante. Et tout semblait fonctionner correctement.
Tentative trois
Le fournisseur Terraform est un binaire qui contient le code avec toutes les ressources et la logique pour travailler avec les API des fournisseurs de cloud. Chaque fournisseur de cloud a son propre provider, et Terraform ne les appelle que via son protocole RPC entre deux processus.
Maintenant, j'ai décidé de m'adresser directement aux providers Terraform via des appels RPC. Ça s'est très bien passé et cela a permis de mettre à jour les providers Terraform pour en obtenir de nouvelles fonctionnalités sans modifier le code. Il s'est également avéré que tous les champs du tfstate ne doivent pas nécessairement être présents dans le tf, mais comment le savoir ? Il fallait simplement demander au provider. Ensuite, une autre pornographie récursive a commencé avec la compilation de chaînes de recherche de champs à l'intérieur du tfstate à tous les niveaux.
À la fin, j'ai créé un outil CLI utile qui a une infrastructure commune pour tous les providers Terraform et il est facile d'ajouter un nouveau. De plus, l'ajout de ressources nécessite peu de code. Il y a aussi plein de fonctionnalités comme les connexions entre les ressources. Bien sûr, il y a eu de nombreux problèmes différents qui ne peuvent pas tous être décrits.
J'ai nommé la créature Terrafomer.
Final
Avec Terraformer, nous avons généré 500 à 700 000 lignes de code tf + tfstate à partir de deux clouds. Nous avons pu prendre des choses legacy et commencer à les toucher uniquement via Terraform, comme dans les meilleures idées d'infrastructure as code. C'est tout simplement magique de prendre un immense cloud et de l'obtenir via une commande sous forme de fichiers Terraform fonctionnels. Ensuite, grep/replace/git et ainsi de suite.
J'ai trié et mis en ordre, obtenu les autorisations. J'ai publié sur GitHub pour tout le monde jeudi (02.05.19).
J'ai déjà reçu 600 étoiles, 2 pull requests ajoutant le support de OpenStack et Kubernetes. De bons retours. C'est vraiment un projet utile pour les gens.
Je le recommande à tous ceux qui souhaitent commencer à travailler avec Terraform sans tout réécrire pour cela.
Je serais ravi des pull requests, des problèmes, des étoiles.
Démo
Source : habr.com
