

Bonjour à tous, je m'appelle Alexandre, et je suis ingénieur en qualité des données, spécialisé dans la vérification de la qualité des données. Dans cet article, je vais vous expliquer comment je suis arrivé là et pourquoi, en 2020, ce domaine du test est devenu très en vogue.
Tendance mondiale
Le monde d'aujourd'hui traverse une nouvelle révolution technologique, dont l'un des aspects est l'utilisation par diverses entreprises des données accumulées pour faire avancer leur propre moteur de vente, de profits et de communication. Il semble que la possession de bonnes (qualitatives) données, ainsi que des esprits capables de les transformer en argent (traitement adéquat, visualisation, construction de modèles d'apprentissage automatique, etc.), soit la clé du succès pour beaucoup aujourd'hui. Il y a 15 à 20 ans, la gestion des données accumulées et leur monétisation étaient principalement l'apanage des grandes entreprises, alors qu'aujourd'hui, c'est devenu le lot de presque toutes les entreprises sensées.
De ce fait, il y a quelques années, tous les portails de recherche d'emploi à travers le monde ont été inondés d'offres d'emploi pour des Data Scientists, car tout le monde était convaincu qu'en engageant un tel spécialiste, on pourrait construire un super modèle d'apprentissage automatique, prédire l'avenir et réaliser un « bond quantique » pour l'entreprise. Avec le temps, les gens ont compris que cette approche ne fonctionne que dans de rares cas, car toutes les données qui parviennent à ces spécialistes ne sont pas forcément adaptées à l'entraînement de modèles.
Et les demandes de Data Scientists ont commencé : « Achetons encore des données chez ceux-ci et ceux-là.… », « Il nous manque des données… », « Nous avons encore besoin de données et de préférence de qualité… ». En se basant sur ces demandes, de nombreuses interactions ont vu le jour entre les entreprises possédant divers ensembles de données. Naturellement, cela a nécessité une organisation technique de ce processus — se connecter à la source de données, les extraire, vérifier qu'elles sont chargées en intégralité, etc. Le nombre de ces processus a commencé à croître, et aujourd'hui nous faisons face à un immense besoin d'un autre type de spécialistes — des ingénieurs en qualité des données — ceux qui surveilleraient le flux de données dans le système (data pipelines), la qualité des données à l'entrée et à la sortie, et tireraient des conclusions sur leur suffisance, intégrité et d'autres caractéristiques.
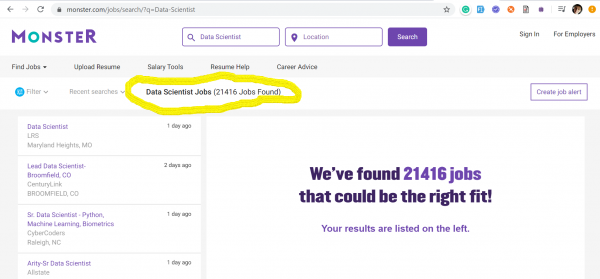
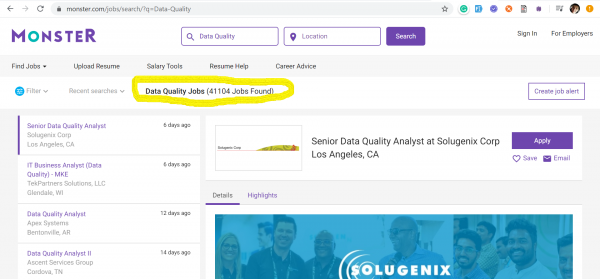
La tendance des ingénieurs en Data Quality nous vient des États-Unis, où, dans la pleine ère capitaliste, personne n'est prêt à perdre la bataille des données. Voici des captures d'écran de deux des sites d'emploi les plus populaires aux États-Unis : et — qui montrent des données en date du 17 mars 2020 concernant le nombre d'offres d'emploi obtenues, par mots-clés : Data Quality et Data Scientist.
Data Scientists – 21416 offres
Data Quality – 41104 offres
Data Scientists – 404 offres
Data Quality – 2020 offres
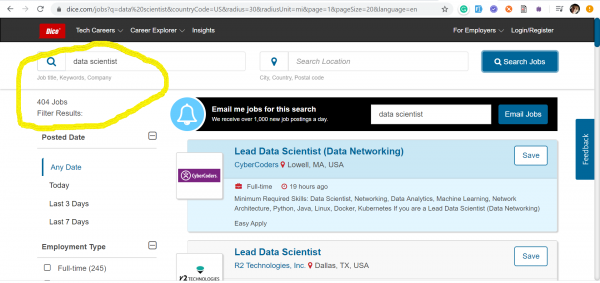
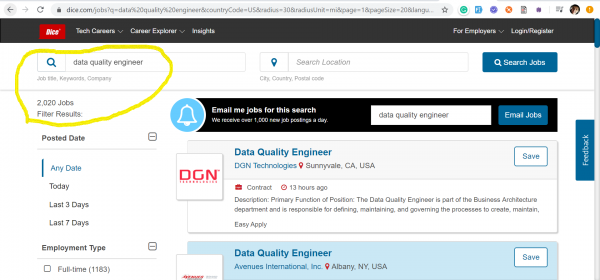
Il est évident que ces professions ne sont en aucun cas en concurrence l'une avec l'autre. Avec ces captures d'écran, je voulais simplement illustrer la situation actuelle du marché du travail en ce qui concerne la demande d'ingénieurs en Data Quality, qui sont actuellement beaucoup plus recherchés que les Data Scientists.
En juin 2019, EPAM, réagissant aux besoins du marché IT moderne, a séparé la direction Data Quality en une pratique distincte. Les ingénieurs en Data Quality, dans le cadre de leur travail quotidien, gèrent les données, vérifient leur comportement dans de nouvelles conditions et systèmes, contrôlent la pertinence, la suffisance et l'actualité des données. Pourtant, dans un sens pratique, les ingénieurs en Data Quality consacrent réellement un peu de temps aux tests fonctionnels classiques, MAIS cela dépend fortement du projet (je donnerai un exemple plus loin).
Les responsabilités des ingénieurs en Data Quality ne se limitent pas seulement aux vérifications manuelles/automatisées routinières sur les « nulls, count et sums » dans les tables de bases de données, mais nécessitent une compréhension approfondie des besoins commerciaux du client et, par conséquent, la capacité de transformer les données existantes en informations commerciales exploitables.
La théorie de la Data Quality
Pour mieux comprendre le rôle d'un tel ingénieur, examinons ce qu'est la Data Quality en théorie.
Data Quality — l'une des étapes de la gestion des données (un monde entier que nous vous laisserons explorer par vous-même) et est responsable de l'analyse des données selon les critères suivants :
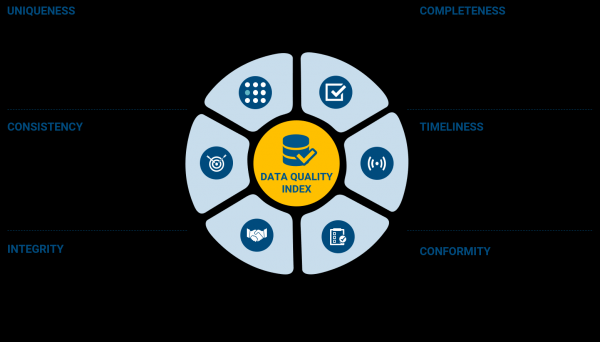
Je pense qu'il n'est pas nécessaire d'expliquer chacun des points (appelés en théorie «data dimensions»), ils sont déjà bien décrits sur l'image. Mais le processus de test ne nécessite pas de copier strictement ces caractéristiques dans des tests et de les vérifier. Dans la qualité des données, comme dans tout autre type de test, il faut d'abord s'appuyer sur les exigences de qualité des données, convenues avec les participants du projet qui prennent des décisions commerciales.
Selon le projet, un ingénieur en qualité des données peut remplir différentes fonctions : d'un simple testeur automatisé avec une évaluation superficielle de la qualité des données, à une personne réalisant un profilage approfondi selon les caractéristiques mentionnées ci-dessus.
Une description très détaillée des processus de gestion des données, de la qualité des données et des domaines connexes est bien présentée dans le livre intitulé «DAMA-DMBOK: Data Management Body of Knowledge: 2ème Édition». Je recommande vivement ce livre comme introduction à ce sujet (le lien vers celui-ci se trouve à la fin de l'article).
Mon histoire
Dans l'industrie informatique, je suis passé de Junior testeur dans des entreprises de produits à Lead Data Quality Engineer chez EPAM. Après environ deux ans de travail en tant que testeur, j'étais convaincu que je réalisais tous les types de test : régression, fonctionnel, stress, stabilité, sécurité, UI, etc. — et j'ai essayé un grand nombre d'outils de test tout en travaillant sur trois langages de programmation : Java, Scala, Python.
En réfléchissant au passé, je comprends pourquoi l'ensemble de mes compétences professionnelles est si varié — j'ai participé à des projets liés au travail avec des données, grandes et petites. C'est exactement cela qui m'a conduit dans un monde rempli d'outils et de possibilités de croissance.
Pour apprécier la variété des outils et des possibilités d'acquérir de nouvelles connaissances et compétences, il suffit de jeter un œil à l'image ci-dessous qui montre les plus populaires dans le monde de la «Data & AI».
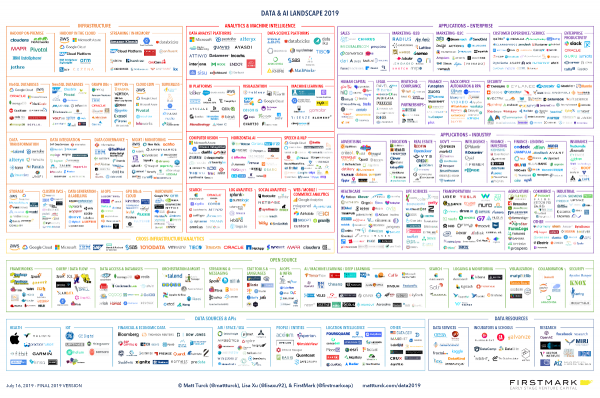
Ce type d'illustrations est réalisé chaque année par l'un des célèbres capital-risqueurs Matt Turck, issu du développement logiciel. Voici son blog et , où il travaille en tant que partenaire.
J'ai particulièrement beaucoup progressé professionnellement lorsque j'étais le seul testeur du projet, ou du moins au début du projet. À ce moment-là, il faut être responsable de l'ensemble du processus de test, et il n'y a pas de retour en arrière, seulement en avant. Au début, cela faisait peur, mais maintenant je vois clairement tous les avantages de cette épreuve :
- Tu commences à communiquer avec toute l'équipe comme jamais auparavant, car il n'y a pas de proxy pour la communication : ni de test-manager, ni de collègues testeurs.
- L'immersion dans le projet devient incroyablement profonde, et tu maîtrises l'information sur tous les composants tant au niveau général que dans les détails.
- Les développeurs ne te regardent pas comme « ce gars du test qui ne fait pas vraiment grand-chose », mais plutôt comme un égal, apportant une valeur incroyable à l'équipe avec tes tests automatisés et ta capacité à anticiper l'apparition de bugs dans un certain module du produit.
- En conséquence, tu es plus efficace, plus qualifié, plus en demande.
Au fur et à mesure que le projet grandissait, dans 100% des cas, je devenais mentor pour les nouveaux testeurs arrivant sur le projet, les formant et partageant les connaissances que j'avais acquises. Selon le projet, je ne recevais pas toujours les spécialistes en automatisation de haut niveau, et il y avait un besoin soit de les former à l'automatisation (pour ceux qui le voulaient), soit de créer des outils pour les aider dans leurs activités quotidiennes (outils de génération de données et de chargement dans le système, outils pour des tests de charge/test de stabilité « rapides », etc.).
Exemple d'un projet concret
Malheureusement, en raison des obligations de non-divulgation, je ne peux pas parler en détail des projets sur lesquels j'ai travaillé, mais je vais donner des exemples des tâches typiques d'un ingénieur en qualité des données sur l'un des projets.
L'objectif du projet était de mettre en œuvre une plateforme pour préparer des données afin d'entraîner des modèles d'apprentissage automatique. Le client était une grande entreprise pharmaceutique des États-Unis. Techniquement, c'était un cluster , s'élevant sur instances, avec plusieurs microservices et reposant sur le projet open source de l'entreprise EPAM - , adapté aux besoins spécifiques du client (le projet a maintenant été rebaptisé en ). Les processus ETL ont été organisés à l'aide de et a déplacé les données de du système du client vers Buckets. Ensuite, une image Docker du modèle d'apprentissage automatique a été déployée sur la plateforme, qui s'est entraînée sur des données récentes et a fourni des prédictions via l'interface REST API, répondant aux besoins de l'entreprise et résolvant des problèmes spécifiques.
Visuellement, cela ressemblait à peu près à ceci :
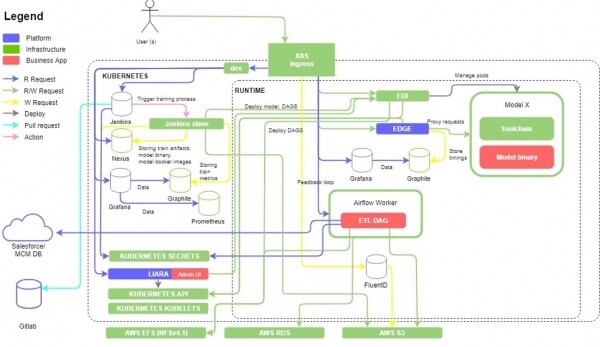
Il y avait suffisamment de tests fonctionnels sur ce projet, et étant donné la rapidité de développement des fonctionnalités et la nécessité de maintenir un rythme de cycle de publication (sprints de deux semaines), il était nécessaire de réfléchir immédiatement à l'automatisation des tests des nœuds critiques du système. La majorité de la plateforme, basée sur Kubernetes, était couverte par des tests automatisés réalisés avec + Python, mais il était également nécessaire de les maintenir et de les étendre. De plus, pour le confort du client, une interface graphique a été créée pour gérer les modèles d'apprentissage automatique déployés sur le cluster, ainsi que la possibilité d'indiquer d'où et vers où les données devaient être transférées pour entraîner les modèles. Cet ajout vaste a entraîné une extension des vérifications fonctionnelles automatisées, qui étaient majoritairement effectuées par des appels REST API et un petit nombre de tests UI end-to-end. Environ à mi-parcours de tout ce mouvement, un testeur manuel nous a rejoint, qui s'est très bien occupé de l'acceptation des tests des versions du produit et de la communication avec le client concernant l'acceptation de la prochaine version. De plus, grâce à l'arrivée de ce nouveau spécialiste, nous avons pu documenter notre travail et ajouter quelques vérifications manuelles très importantes qui étaient difficiles à automatiser immédiatement.
Et enfin, après avoir atteint la stabilité de la plateforme et de l'interface graphique qui la surplombe, nous avons commencé à construire des pipelines ETL à l'aide des DAGs d'Apache Airflow. La vérification automatisée de la qualité des données a été effectuée en écrivant des DAGs Airflow spécifiques qui validaient les données en fonction des résultats du processus ETL. Dans le cadre de ce projet, nous avons eu la chance que le client nous ait fourni un accès à des ensembles de données anonymisées, sur lesquels nous avons fait nos tests. Nous avons vérifié les données ligne par ligne pour leur conformité aux types, la présence de données corrompues, le nombre total d'enregistrements avant et après, et nous avons comparé les transformations effectuées par le processus ETL au niveau de l'agrégation, du changement de noms de colonnes, etc. De plus, ces vérifications ont été étendues à différentes sources de données, par exemple, en plus de SalesForce, également sur MySQL.
Les vérifications de la qualité finale des données ont été réalisées au niveau de S3, où elles étaient stockées et prêtes à l'emploi pour l'entraînement de modèles d'apprentissage automatique. Pour extraire les données du fichier CSV final situé dans le bucket S3 et les valider, un code a été écrit en utilisant .
De plus, le client a exigé que certaines données soient stockées dans un bucket S3, et d'autres dans un autre. Cela a également nécessité l'écriture de vérifications supplémentaires pour contrôler la véracité de cette classification.
Expérience généralisée sur d'autres projets
Un exemple de la liste la plus générale des activités d'un ingénieur en qualité des données :
- Préparer des données de test (valides, non valides, grandes, petites) via un outil automatisé.
- Charger l'ensemble de données préparé dans la source d'origine et vérifier sa disponibilité pour utilisation.
- Lancer les processus ETL pour traiter l'ensemble de données provenant de la source d'origine vers la destination finale ou intermédiaire en appliquant un certain ensemble de configurations (dans le cas où il est possible de définir des paramètres configurables pour la tâche ETL).
- Vérifier les données traitées par le processus ETL pour leur qualité et leur conformité aux exigences commerciales.
L'accent principal des vérifications ne doit pas seulement porter sur le fait que le flux de données dans le système a été correctement exécuté et est arrivé à la fin (ce qui fait partie des tests fonctionnels), mais majoritairement sur la vérification et la validation des données pour s'assurer qu'elles répondent aux exigences attendues, qu'elles identifient des anomalies, etc.
Outils
Une des techniques de contrôle des données peut consister à organiser des vérifications en chaîne à chaque étape du traitement des données, ce que la littérature appelle la « data chain » — le contrôle des données depuis leur source jusqu'au point d'utilisation finale. Ce type de vérification est souvent mis en œuvre en écrivant des requêtes SQL de vérification. Il va sans dire que ces requêtes doivent être aussi légères que possible et vérifier des morceaux spécifiques de la qualité des données (métadonnées des tables, lignes vides, NULLs, erreurs de syntaxe — d'autres attributs de vérification requis).
Dans le cas des tests de régression, où des ensembles de données déjà préparés (inévitablement peu modifiables) sont utilisés, les codes des tests automatisés peuvent contenir des modèles de vérification des données concernant la qualité (descriptions des métadonnées des tables; objets échantillonnés qui peuvent être sélectionnés au hasard lors du test, etc.).
Lors des tests, il est également nécessaire d'écrire des processus ETL de test, en utilisant des cadres tels que Apache Airflow, ou même des outils cloud en boîte noire comme , et d'autres. Cela oblige l'ingénieur de test à s'immerger dans les principes de fonctionnement des outils mentionnés ci-dessus, et à réaliser plus efficacement à la fois les tests fonctionnels (par exemple, des processus ETL existants dans le projet) et à les utiliser pour vérifier les données. En particulier, pour Apache Airflow, des opérateurs prêts à l'emploi existent pour travailler avec des bases de données analytiques populaires, comme . Le plus basique des exemples de son utilisation a déjà été exposé , donc je ne vais pas répéter.
En plus des solutions prêtes à l'emploi, rien ne vous empêche de mettre en œuvre vos propres techniques et outils. Cela sera non seulement bénéfique pour le projet, mais également pour l'ingénieur en qualité des données, qui ainsi élargira ses compétences techniques et ses capacités de codage.
Comment cela fonctionne-t-il dans un projet réel
Une bonne illustration des derniers paragraphes sur la « chaîne de données », l'ETL et les vérifications omniprésentes est le processus suivant d'un des projets réels :
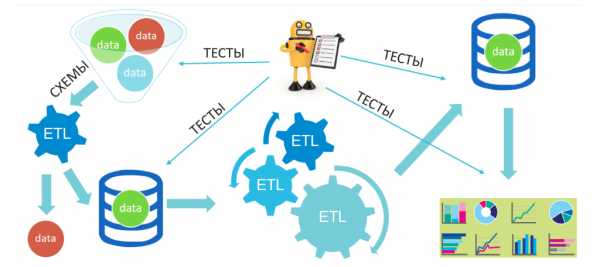
Ici, différentes données (évidemment préparées par nous) entrent dans l'« entonnoir » de notre système : valides, invalides, mélangées, etc., puis elles sont filtrées et passent dans un stockage intermédiaire, ensuite elles subissent à nouveau une série de transformations et sont placées dans le stockage final, à partir duquel l'analyse, la construction de vitrines de données et la recherche d'insights commerciaux seront réalisées. Dans ce type de système, sans vérifier fonctionnellement le fonctionnement des processus ETL, nous nous concentrons sur la qualité des données avant et après les transformations, ainsi que sur la sortie vers l'analyse.
Pour résumer ce qui précède, peu importe les lieux où j'ai travaillé, j'étais toujours impliqué dans des projets Data qui partageaient les caractéristiques suivantes :
- C'est uniquement grâce à l'automatisation que l'on peut vérifier certains cas et atteindre un cycle de publication acceptable pour les entreprises.
- Le testeur dans tel projet est l'un des membres les plus respectés de l'équipe, car il apporte une immense valeur à chacun des participants (accélération des tests, bonnes données pour les Data Scientists, identification des défauts à un stade précoce).
- Peu importe si vous travaillez sur votre propre matériel ou dans le cloud — toutes les ressources sont abstraites dans un cluster de type Hortonworks, Cloudera, Mesos, Kubernetes, etc.
- Les projets sont basés sur une approche de microservices, avec des calculs distribués et parallèles prédominants.
Je souligne que, dans le cadre de tests sur la qualité des données, le spécialiste des tests déplace son focus professionnel sur le code du produit et les outils utilisés.
Caractéristiques distinctives des tests de qualité des données
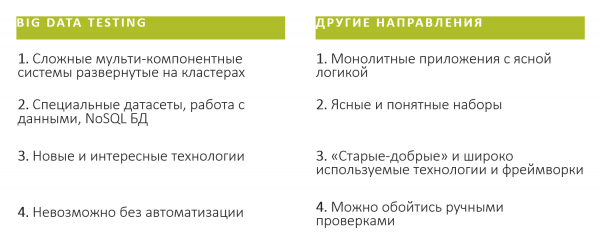
De plus, j'ai identifié les caractéristiques suivantes (je précise qu'elles sont TRÈS générales et uniquement subjectives) qui distinguent les tests dans les projets de données (Big Data) et d'autres domaines :
Liens utiles
- Théorie : .
- EPAM
- Matériaux recommandés pour un ingénieur Data Quality débutant :
- Cours gratuit sur Stepik : .
- Cours sur LinkedIn Learning : .
- Articles :
- ;
- ;
- ;
- Vidéo :
- ;
- ;
Conclusion
Data Quality — c'est un domaine très jeune et prometteur, faire partie de celui-ci signifie faire partie d'une sorte de startup. En entrant dans la Quality Data, vous serez immergé dans un grand nombre de technologies modernes et demandées, mais surtout, d'énormes opportunités s'offriront à vous pour générer et réaliser vos idées. Vous pourrez appliquer une approche d'amélioration continue non seulement dans le projet, mais aussi pour vous-même, en vous développant constamment en tant que spécialiste.
Source : habr.com
