

La traduction de l'article a été préparée spécialement pour les étudiants du cours .
— développeur de logiciels, passionné par Go et amateur de résoudre des défis complexes. Il est également mainteneur de Prometheus et cofondateur du SIG instrumentation de Kubernetes. Auparavant, il était ingénieur de production chez SoundCloud et a dirigé l'équipe de surveillance chez CoreOS. Il travaille actuellement chez Google.
— ingénieur d'infrastructure chez Improbable. Il s'intéresse aux nouvelles technologies et aux défis des systèmes distribués. Il a de l'expérience en programmation bas niveau chez Intel, en tant que contributeur à Mesos et en tant qu'ingénieur SRE mondial chez Improbable. Il travaille à améliorer le monde des microservices. Ses trois passions : Golang, open source et volleyball.
En regardant notre produit phare SpatialOS, on peut deviner qu'Improbable a besoin d'une infrastructure cloud hautement dynamique à l'échelle mondiale avec des dizaines de clusters Kubernetes. Nous avons été parmi les premiers à commencer à utiliser le système de surveillance . Prometheus peut suivre des millions de métriques en temps réel et est livré avec un langage de requête puissant qui permet d'extraire les informations nécessaires.
La simplicité et la fiabilité de Prometheus sont l'un de ses principaux atouts. Cependant, après avoir atteint une certaine échelle, nous avons rencontré plusieurs inconvénients. Pour résoudre ces problèmes, nous avons développé — un projet open source créé par Improbable, pour transformer sans couture les clusters Prometheus existants en un système de surveillance unique avec un stockage illimité des données historiques. Thanos est disponible sur Github .
Nos objectifs avec Thanos
À une certaine échelle, des problèmes émergent qui dépassent les capacités de Prometheus vanilla. Comment stocker de manière fiable et économique des pétaoctets de données historiques ? Est-il possible de le faire sans compromettre le temps de réponse des requêtes ? Peut-on accéder à toutes les métriques situées sur différents serveurs Prometheus via une seule requête API ? Est-il possible de regrouper d'une manière ou d'une autre les données répliquées collectées via Prometheus HA ?
Pour répondre à ces questions, nous avons créé Thanos. Dans les sections suivantes, nous décrivons comment nous avons abordé ces problèmes et expliquons les objectifs que nous avons poursuivis.
Requête de données à partir de plusieurs instances Prometheus (requête globale)
Prometheus propose une approche fonctionnelle pour le sharding. Même un serveur Prometheus fournit une échelle suffisante pour libérer les utilisateurs des complexités du sharding horizontal dans presque tous les cas d'utilisation.
Bien que ce soit un excellent modèle de déploiement, il est souvent nécessaire d'accéder aux données sur différents serveurs Prometheus via une seule API ou une interface utilisateur — une vue globale. Bien sûr, il est possible d'afficher plusieurs requêtes dans un même tableau de bord Grafana, mais chaque requête ne peut être effectuée que sur un seul serveur Prometheus. D'autre part, grâce à Thanos, vous pouvez interroger et agréger des données de plusieurs serveurs Prometheus, puisque tous sont accessibles à partir d'un seul point de terminaison.
Auparavant, pour obtenir une vue globale chez Improbable, nous organisions nos instances Prometheus en une architecture multicouche. . Cela nécessitait la création d'un serveur Prometheus méta qui collecte une partie des métriques de chaque serveur "feuille".
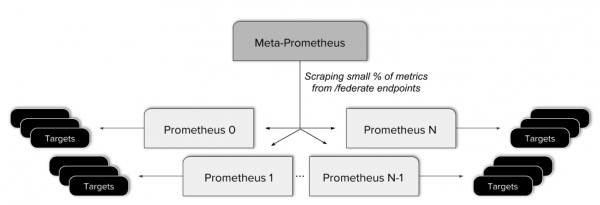
Cette approche s'est révélée problématique. Elle a entraîné une complexité accrue de la configuration, l'ajout d'un point de défaillance potentiel supplémentaire et l'application de règles complexes pour fournir à la fin des requêtes fédérées uniquement les données nécessaires. De plus, une fédération de ce type n'offre pas de véritable vue globale, car toutes les données ne sont pas accessibles par une seule requête API.
Cela est étroitement lié à une vue unifiée des données collectées sur des serveurs Prometheus à haute disponibilité (high-availability, HA). Le modèle HA de Prometheus collecte indépendamment les données deux fois, ce qui est si simple que cela ne peut pas être plus facile. Cependant, utiliser une vue combinée et dédupliquée des deux flux serait beaucoup plus pratique.
Bien sûr, il y a un besoin pour des serveurs Prometheus à haute disponibilité. Chez Improbable, nous prenons très au sérieux la surveillance des données minute par minute, mais avoir une seule instance de Prometheus dans un cluster constitue un point de défaillance unique. Toute erreur de configuration ou panne matérielle peut potentiellement entraîner la perte de données importantes. Même un simple déploiement peut provoquer de légers échecs dans la collecte des métriques, car un redémarrage peut être considérablement plus long que l'intervalle de scraping.
Stockage fiable des données historiques
Un stockage de métriques bon marché, rapide et à long terme est notre rêve (partagé par la plupart des utilisateurs de Prometheus). Chez Improbable, nous avons été contraints de configurer la durée de stockage des métriques à neuf jours (pour Prometheus 1.8). Cela impose des limites claires à la rétroactivité de nos analyses.
Prometheus 2.0 s'est amélioré à cet égard, car le nombre de séries temporelles n'influence plus la performance globale du serveur (voir ). Cependant, Prometheus stocke les données sur un disque local. Bien qu'une compression des données très efficace puisse considérablement réduire l'utilisation d'un SSD local, il existe quand même une limite sur la quantité de données historiques pouvant être conservée.
De plus, chez Improbable, nous nous soucions de la fiabilité, de la simplicité et des coûts. Les grands disques locaux sont plus difficiles à gérer et à sauvegarder. Ils sont plus coûteux et nécessitent plus d'outils de sauvegarde, ce qui entraîne une complexité excessive.
Réduction d'échantillonnage
Dès que nous avons commencé à travailler avec des données historiques, nous avons réalisé qu'il existait des complexités fondamentales en O-grand, qui ralentissent de plus en plus les requêtes lorsque nous travaillons avec des données sur des semaines, mois et années.
La solution standard à ce problème est (downsampling) — réduire la fréquence d'échantillonnage d'un signal. En abaissant la fréquence d'échantillonnage, nous pouvons "redimensionner" sur une plus grande plage temporelle tout en maintenant le même nombre d'échantillons, ce qui permet de garder les requêtes réactives.
La réduction d'échantillonnage des anciennes données est un besoin inévitable de toute solution de stockage à long terme et dépasse les capacités de Prometheus vanille.
Objectifs supplémentaires
L'un des objectifs initiaux du projet Thanos était une intégration sans faille avec toutes les installations existantes de Prometheus. Le deuxième objectif était une exploitation simple avec une barrière d'entrée minimale. Toutes les dépendances doivent être facilement satisfaites tant pour les petits que pour les grands utilisateurs, ce qui implique également un coût de base faible.
Architecture de Thanos
Après avoir énuméré nos objectifs dans la section précédente, travaillons à leur réalisation et voyons comment Thanos résout ces problèmes.
Vue globale
Pour obtenir une vue globale au-dessus des instances existantes de Prometheus, nous devons relier un point d'entrée unique pour toutes les requêtes vers les serveurs. C'est exactement ce que fait le composant Thanos. . Il est déployé à côté de chaque serveur Prometheus et fonctionne comme un proxy, servant les données locales de Prometheus via l'interface gRPC du Store API, permettant de sélectionner des données de séries temporelles par labels et plage temporelle.
D'autre part, il y a le composant Querier, qui est évolutif horizontalement et sans état, et qui fait un peu plus que répondre aux requêtes PromQL via l'API HTTP standard de Prometheus. Les composants Querier, Sidecar et d'autres de Thanos interagissent via le .
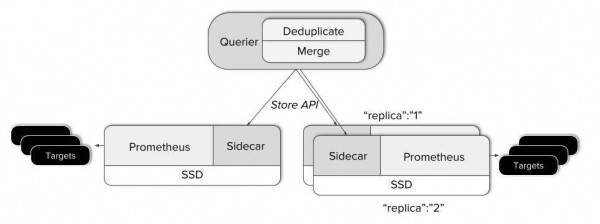
- Lorsqu'il reçoit une requête, le Querier se connecte au serveur Store API correspondant, c'est-à-dire à nos Sidecar, et récupère les données de séries temporelles des serveurs Prometheus appropriés.
- Ensuite, il fusionne les réponses et exécute la requête PromQL. Le Querier peut fusionner des données non chevauchantes ainsi que des données dupliquées provenant des serveurs HA de Prometheus.
Cela résout la plupart de notre casse-tête : la fusion des données de serveurs Prometheus isolés en une seule représentation. En fait, Thanos peut être utilisé uniquement pour cette fonctionnalité. Il n'est pas nécessaire d'apporter des modifications aux serveurs Prometheus existants !
Durée de conservation illimitée !
Cependant, tôt ou tard, nous voudrons conserver des données qui dépassent la durée de conservation normale de Prometheus. Pour le stockage des données historiques, nous avons choisi un stockage d'objets. Il est largement disponible dans n'importe quel cloud, ainsi que dans les centres de données locaux, et est très économique. De plus, presque n'importe quel stockage d'objets est accessible via le bien connu API S3.
Prometheus écrit les données de la mémoire vive sur le disque environ toutes les deux heures. Un bloc de données conservées contient toutes les données d'une période fixe et est immuable. C'est très pratique, car Thanos Sidecar peut simplement consulter le répertoire des données de Prometheus et, à mesure que de nouveaux blocs apparaissent, les charger dans les buckets de stockage d'objets.
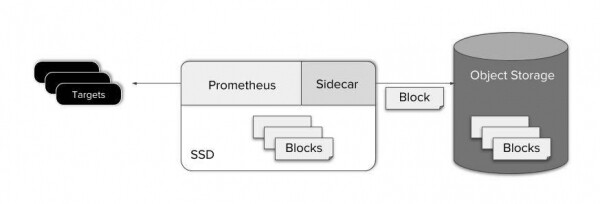
Le chargement vers le stockage d'objets immédiatement après l'écriture sur le disque permet également de maintenir la simplicité du « scrapeur » (Prometheus et Thanos Sidecar). Ce qui simplifie la maintenance, le coût et la conception du système.
Comme vous pouvez le voir, la sauvegarde des données est mise en œuvre très simplement. Mais qu'en est-il de la requête des données dans le stockage d'objets ?
Le composant Thanos Store agit comme un proxy pour obtenir des données depuis le stockage d'objets. Comme le Thanos Sidecar, il participe au cluster de gossip et implémente l'API Store. Ainsi, les Querier existants peuvent le considérer comme un Sidecar, comme une source supplémentaire de données de séries temporelles – aucune configuration spéciale n'est requise.
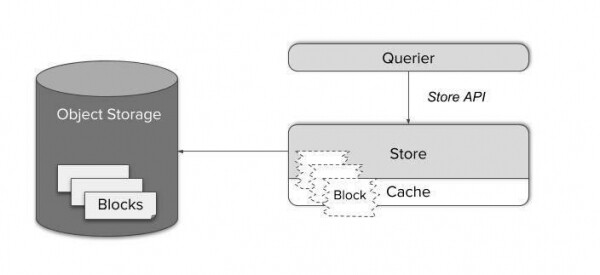
Les blocs de données de séries temporelles se composent de plusieurs gros fichiers. Les charger à la demande serait assez inefficace, et la mise en cache locale nécessiterait une énorme mémoire et un grand espace disque.
Au lieu de cela, le Store Gateway sait comment gérer le format de stockage de Prometheus. Grâce à un planificateur de requêtes intelligent et à la mise en cache uniquement des parties d'index nécessaires des blocs, il est possible de réduire les requêtes complexes à un minimum de requêtes HTTP vers les fichiers de stockage d'objets. Ainsi, le nombre de requêtes peut être réduit de quatre à six ordres de grandeur et atteindre des temps de réponse qui sont généralement difficiles à distinguer de ceux des requêtes de données sur SSD locaux.
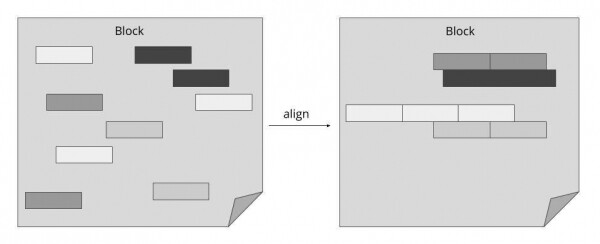
Comme l'illustre le diagramme ci-dessus, le Thanos Querier réduit considérablement les coûts d'une requête de données dans le stockage d'objets en utilisant le format de stockage de Prometheus et en plaçant les données connexes près les unes des autres. En utilisant cette approche, nous pouvons combiner de nombreuses requêtes individuelles en un minimum d'opérations en masse.
Consolidation et échantillonnage descendant
Une fois qu'un nouveau bloc de données de séries temporelles est chargé avec succès dans le stockage d'objets, nous le considérons comme des données « historiques » qui deviennent immédiatement accessibles via le Store Gateway.
Cependant, après un certain temps, les blocs d'une seule source (Prometheus avec Sidecar) s'accumulent et n'exploitent plus pleinement le potentiel d'indexation. Pour résoudre ce problème, nous avons introduit un autre composant appelé Compactor. Il applique simplement le mécanisme de consolidation local de Prometheus aux données historiques dans le stockage d'objets et peut être exécuté comme une simple tâche par lots périodiques.
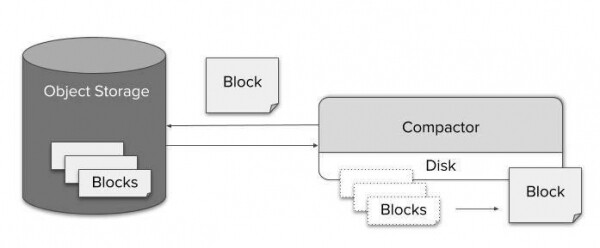
Grâce à une compression efficace, les requêtes de stockage à long terme ne posent pas de problème en termes de taille des données. Cependant, le coût potentiel de décompression d'un milliard de valeurs et de leur passage à travers le processeur de requêtes entraînera inévitablement une augmentation rapide du temps d'exécution de la requête. D'autre part, étant donné que chaque pixel à l'écran correspond à des centaines de points de données, il devient impossible même de visualiser les données en pleine résolution. Ainsi, le downsampling est non seulement possible, mais ne conduira pas à une perte de précision significative.
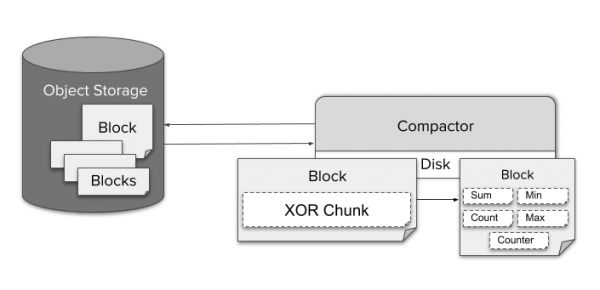
Pour le downsampling des données, le Compactor agrège en continu les données avec une résolution de cinq minutes et une heure. Pour chaque fragment brut, codé à l'aide de la compression TSDB XOR, différents types de données agrégées sont stockés, comme min, max ou sum pour un bloc donné. Cela permet au Querier de choisir automatiquement l'agrégat qui convient pour une requête PromQL donnée.
Pour utiliser des données avec une précision réduite, l'utilisateur n'a besoin d'aucune configuration spéciale. Le Querier change automatiquement entre différentes résolutions et données brutes à mesure que l'utilisateur zoom ou dézoom. Si désiré, l'utilisateur peut gérer cela directement via le paramètre “step” de la requête.
Étant donné que le coût de stockage d'un Go est faible, Thanos par défaut conserve les données brutes, ainsi que les données avec une résolution de cinq minutes et d'une heure. Il n'est pas nécessaire de supprimer les données brutes.
Règles d'enregistrement
Même avec Thanos, les règles d'enregistrement sont une partie essentielle de la pile de surveillance. Elles réduisent la complexité, la latence et le coût des requêtes. Elles sont également pratiques pour les utilisateurs souhaitant obtenir des données agrégées sur les métriques. Thanos est basé sur des instances vanilla de Prometheus, donc il est tout à fait acceptable de stocker des règles d'enregistrement et des règles d'alerte sur un serveur Prometheus existant. Cependant, dans certains cas, cela peut ne pas suffire :
- Alerte et règle globales (par exemple, alerte lorsque le service ne fonctionne pas sur plus de deux des trois clusters).
- Règle pour les données hors du stockage local.
- Volonté de conserver toutes les règles et alertes en un seul endroit.
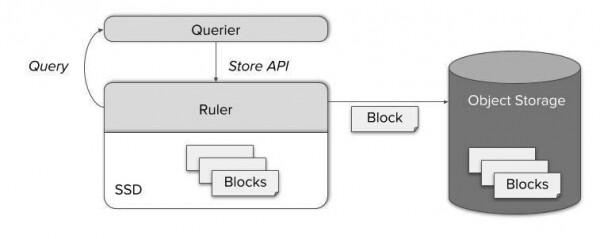
Pour tous ces cas, Thanos inclut un composant distinct appelé Ruler, qui calcule les règles et les alertes via les requêtes Thanos. En fournissant une API Store bien connue, le nœud de requête peut accéder à des métriques fraîchement calculées. Plus tard, elles sont également stockées dans un stockage d'objets et deviennent accessibles via le Store Gateway.
La puissance de Thanos
Thanos est suffisamment flexible pour être adapté à vos besoins. Cela est particulièrement utile lors de la migration depuis un Prometheus classique. Revenons rapidement, à travers un petit exemple, sur ce que nous avons appris concernant les composants de Thanos. Voici comment transférer votre Prometheus classique vers le monde du stockage illimité des métriques:
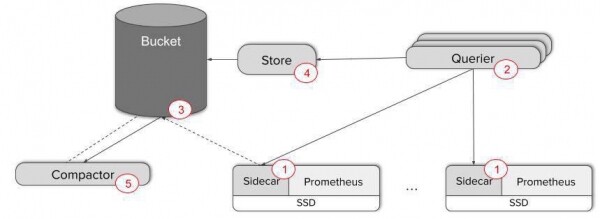
- Ajoutez Thanos Sidecar à vos serveurs Prometheus — par exemple, comme un conteneur voisin dans un pod Kubernetes.
- Déployez plusieurs répliques de Thanos Querier pour la visualisation des données. À ce stade, il est facile de configurer le gossip entre le Scraper et le Querier. Pour vérifier l'interaction des composants, utilisez la métrique 'thanos_cluster_members'.
Ces deux étapes suffisent pour garantir une vue globale et une déduplication fluide des données provenant de répliques HA potentielles de Prometheus ! Connectez simplement vos tableaux de bord au point de terminaison HTTP du Querier ou utilisez directement l'interface Thanos UI.
Cependant, si vous avez besoin d'une sauvegarde des métriques et d'un stockage à long terme, trois étapes supplémentaires seront nécessaires :
- Créez un bucket AWS S3 ou GCS. Configurez le Sidecar pour copier les données dans ces buckets. Vous pouvez alors minimiser le stockage local des données.
- Déployez le Store Gateway et connectez-le à votre cluster gossip existant. Vous pouvez maintenant interroger les données dans les sauvegardes !
- Déployez le Compactor pour améliorer l'efficacité des requêtes sur de longues périodes, en utilisant la compression et le downsampling.
Si vous souhaitez en savoir plus, n'hésitez pas à consulter nos et !
En seulement cinq étapes, nous avons transformé Prometheus en un système de surveillance fiable avec une vue globale, un temps de stockage illimité et une accessibilité potentiellement élevée des métriques.
Pull request : vous avez besoin de nous !
a toujours été un projet open source. L'intégration fluide avec Prometheus et la capacité d'utiliser uniquement une partie de Thanos font de lui un excellent choix pour faire évoluer le système de surveillance sans effort supplémentaire.
Nous sommes toujours heureux de recevoir des Pull Requests et des Issues sur GitHub. En attendant, n'hésitez pas à nous contacter via les Issues de GitHub ou Slack., si vous avez des questions ou des commentaires, ou si vous souhaitez partager votre expérience d'utilisation ! Si vous aimez ce que nous faisons chez Improbable, n'hésitez pas à nous contacter — !
Source : habr.com
