

Je m'appelle Yuri, je suis le responsable de l'équipe d'administration système chez Ситимобил. Aujourd'hui, je vais partager mon expérience avec la technologie de provisionnement léger (thin provisioning) des systèmes de fichiers Linux et expliquer comment l'appliquer dans les processus CI/CD de l'entreprise. Nous allons examiner la situation où, pour le test automatique du code lors de sa livraison en production, nous avons besoin aussi rapidement que possible de copies de la base de données MySQL, aussi proches que possible de la version « opérationnelle », disponibles en lecture et en écriture.
Introduction : pourquoi donner de mauvais conseils ?
Une question logique, car il existe des mécanismes éprouvés de migration de schémas de base de données dans des environnements de test. Pourquoi pousser la base de données principale non sharding à de tels volumes ? De plus, toutes les données ne sont pas nécessaires pour les tests. J'essaierai d'expliquer.
Il y a environ un an, face à la croissance active de notre agrégateur de taxis (en 2018, nous avons augmenté d'environ 15 fois en termes de courses complètes), les volumes de données, la charge sur les serveurs et la fréquence des déploiements ont augmenté. Nous nous sommes retrouvés dans la situation suivante :
- La base de données MySQL principale a augmenté à environ 1000 tables pour un volume total de 2,5 To, et elle continuait de croître.
- Il n'était pas possible de se sharder rapidement et de répartir la base. L'ancienne approche « j'écris dans la base ce que je veux et comme je veux », avec une multitude de JOINs et de dépendances internes entre les tables, ne le permettait pas.
- Il n'y avait pas de mécanisme de migration de schéma de base de données vers les environnements de test.
- Il n'y avait pas de tests automatiques du code lors du déploiement en production.
Le dernier problème devait être résolu aussi vite que possible. Des tests Postman avaient déjà été écrits pour vérifier le principal monolithe PHP, mais il manquait une base de données à jour. De plus, nous ne pouvions pas créer la nuit une réplique, la rendre maître et l'exposer durant la journée : un trop grand nombre de déploiements et de modifications, notamment dans les données et le schéma de la base de données, rendraient l'environnement non fonctionnel dès le milieu de la journée. Limiter les déploiements uniquement pendant les heures de travail ne serait pas efficace.
Néanmoins, la tâche a été accomplie : nous avons obtenu notre premier environnement de travail après deux semaines. Au cours de l'année écoulée, il a subi de nombreuses modifications et continue d'être utilisé.
Je vais maintenant décrire en détail toutes les étapes et les phases du développement de notre solution. Vous verrez que cette méthode mérite d'exister.
Qu'est-ce que le « provisionnement léger » ?
Il s'agit d'une technologie matérielle ou logicielle (également appelée volumes épars) permettant d'attribuer une quantité de ressources requise supérieure à celle disponible. Le volume attribué doit répondre aux critères de just-enough (juste ce qu'il faut) et de just-in-time (au bon moment). La réservation fine est principalement utilisée dans divers systèmes de stockage, afin de fournir l'espace disque nécessaire en quantités dépassant celles réellement disponibles. Cette technologie est supportée par divers systèmes de fichiers, tels que LVM2, ZFS, BTRFS. Elle est largement utilisée dans les hyperviseurs de virtualisation. Grâce à la réservation fine, nous avons pu rapidement créer à partir des instantanés de la partition principale de données autant de copies de cette partition que nécessaire (répertoire de données de la base de données MySQL).
Premier banc d'essai, technologie Thin LVM
Ce chapitre peut également être appelé « Comment créer des instantanés rapides de grandes quantités de données grâce à , tout en réduisant la stabilité du système de fichiers et de la base de données MySQL à des niveaux inacceptables ».
Étant donné que nous avions déjà utilisé LVM pour construire les partitions principales du système d'exploitation, nous avons décidé de commencer par elle. Pour commencer, nous avions besoin d'une machine physique distincte - une réplique de notre base de données MySQL principale, sur laquelle nous pourrions créer à la demande un instantané de la réplique et le faire tourner à côté en tant qu'instance distincte de MySQL. Pendant la période de test, nous avons autorisé les opérations modifiant de s'appliquer à cette instance, et à la fin des tests, nous l'avons supprimée avec succès. La configuration du serveur était la suivante :
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 Go DDR4
- 8 x 1920 Go Intel SSD sur contrôleur RAID Adaptec en RAID-10
Le choix entre contrôleur RAID et RAID logiciel MD pourrait faire l'objet d'un article à part. Je dirai simplement que notre choix a été influencé par deux facteurs :
- Au moment de la mise en place de la tâche, nous installions tous les systèmes de bases de données sur des contrôleurs RAID, donc on peut dire que c'est une question d'historique.
- La différence de performance lors des tests synthétiques de systèmes de fichiers et des tests avec diverses opérations dans MySQL était minimale.
Nous avons divisé le RAID-10 obtenu : nous avons créé un groupe de volumes (VG) pour l'ensemble de l'espace (avec une surcharge d'environ 6,7 Go) et créé une partition logique (Logical Volume, LV) de 50 Go pour le système. Dans une situation normale, tout l'espace restant serait attribué à la partition pour MySQL. Cependant, nous avions besoin d'un stockage fin, donc nous avons d'abord créé ce que l'on appelle un pool, à l'intérieur duquel nous avons créé une partition pour /var/lib/mysql de 3,5 To (en fonction des volumes de base de données prévus) :
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Nous avons formaté la partition en ext4, l'avons montée, écrit une réplique et obtenu notre environnement de base. Ensuite, nous avons mis en place une API qui doit créer des snapshots, démarrer une instance de MySQL sur un port donné et supprimer l'instance créée. Comme seules des appels système sont utilisés, nous avons choisi bash comme langage de script, et pour l'API HTTP → bash, nous avons déployé une solution open source. , écrite en Go.
Un jour, nous publierons nos scripts bash en open source, mais pour l'instant, je vais simplement décrire l'algorithme principal :
Création du snapshot principal snapmain :
- Nous arrêtons la réplique principale.
- Nous appliquons un verrou sur les opérations du snapshot snapmain.
- Nous créons un nouveau snapshot snapmain.
- Nous démarrons MySQL et levons le verrou.
Création d'une base de données sur un port aléatoire à partir de snapmain :
- Nous appliquons un verrou sur une instance spécifique de la base de données (port).
- Nous vérifions la présence d'un verrou sur la création du snapshot principal. S'il existe, nous attendons et vérifions à nouveau toutes les 5 secondes.
- Nous vérifions s'il existe une ancienne partition LV de l'instance.
3.1 S'il y en a une, nous arrêtons l'instance MySQL avec kill -9 et supprimons la partition LV. - Nous créons une nouvelle instance à partir de snapmain.
- Nous préparons et montons les répertoires pour cette instance.
- Nous levons les signes d'un esclave (fichiers) et démarrons l'instance MySQL.
- Nous en faisons un maître.
- Nous levons le verrou.
Suppression de la base de données sur un port aléatoire :
- Nous appliquons un verrou sur une instance spécifique de la base de données (port).
- Nous tuons l'instance MySQL avec kill -9.
- Nous démontons les répertoires.
- Nous supprimons la partition LV et levons le verrou.
Exemple de commandes pour cloner les partitions de la nouvelle instance de base de données :
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Je vais maintenant parler du principal problème auquel nous avons été confrontés lors de l'utilisation de la réservation fine. Nous avons été confrontés à la performance des disques SSD. Cela est dû aux particularités de Thin LVM : elle opère fondamentalement au niveau de l'appareil avec des blocs de taille par défaut de 4 Mo. Voici à quoi cela ressemblait :
- Nous créons un snapshot du volume principal /var/lib/mysql.
- Nous lançons la réplication pour rattraper le maître.
- Toute modification dans les tables de la réplique oblige à sauvegarder les vieux blocs de données non modifiés dans la partition du snapshot.
- Toute modification dans l'instance de test montée oblige à sauvegarder les vieux blocs de données non modifiés dans la partition du snapshot cloné pour cette instance.
- Nous atteignons une charge d'opérations d'entrée-sortie de 100 % sur le dispositif, ce qui ralentit toutes les opérations et entraîne un retard progressif de la réplique.
- À la fin de la journée de travail, nous nous retrouvons avec un stand en retard de plusieurs heures.
Comment nous avons combattu cela pour obtenir un résultat plus raisonnable (principaux points) :
Contrôleur RAID :
- Nous avons désactivé par défaut tous les types de mise en cache.
- Nous avons réglé sur writeback (lorsque les données sont mises en mémoire tampon, l'écriture se termine avant que la sauvegarde réelle sur disque ne soit effectuée).
Système de fichiers :
- Au point de montage /var/lib/mysql, nous avons spécifié noatime,nodiratime,data=writeback
- Nous avons désactivé les journaux ext4 à l'aide de tune2fs.
MySQL :
- Nous avons indiqué innodb_flush_method = O_DSYNC (nous avons augmenté la vitesse d'écriture, réduisant ainsi la fiabilité).
- Nous avons désactivé la journalisation, nous n'avons pas besoin de journaux.
- Nous avons indiqué innodb_buffer_pool_size = 4G (plus la taille du pool InnoDB est petite, plus MySQL se taira rapidement lors de l'arrêt, et plus rapidement nous créerons un snapshot).
Ce n'est pas une liste complète, surtout pour MySQL. Cependant, les autres modifications sont mineures et souvent non applicables ou pas de manière précise. Par exemple, dans une tentative de décharger les disques, nous avons même déménagé innodb_parallel_doublewrite_path dans /dev/shm, ce qui, dans certains cas, économisait jusqu'à 5 secondes lors du démarrage d'une instance incomplètement arrêtée.
Pourquoi arrêtons-nous MySQL avant de faire un snapshot? Nous pouvons bien le prendre d'une réplique en cours. C'est vrai, mais une nouvelle instance de DB sur ce snapshot sera par défaut considérée comme corrompue et nécessitera un scan complet au démarrage. Arrêter la réplique est définitivement plus rapide, même si cela reste l'opération la plus longue dans tout le processus.
Nous avons ainsi obtenu des délais plus raisonnables et une configuration prête à l'emploi. Cependant, comme le montre le graphique de la latence de réplication de la réplique principale, la situation est encore loin d'être idéale :
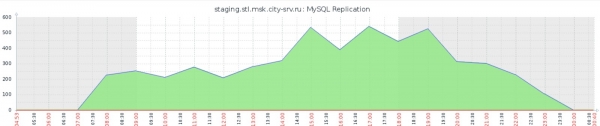
Parmi les autres inconvénients, on peut noter la quasi-impossibilité de surveiller le pool Thin LVM : à part les fonctions systèmes standards comme iostat, il est impossible de savoir quel élément du pool génère actuellement la plus grande charge sur le système de fichiers.
Il convient de mentionner un gros inconvénient lié à l'optimisation décrite ci-dessus : nous avons obtenu un stand YOLO. Environ tous les un à deux mois, le ext4 n'a pas supporté de tels abus et a échoué de manière irréversible, nécessitant un reformatage et un nouvel enregistrement de la réplique. En gagnant en vitesse, nous avons irrévocablement compromis la stabilité.
Quelles métriques surveiller lors de l'exploitation de Thin LVM :
- Pourcentage de données du pool Thin
- Pourcentage de métadonnées du pool Thin
Si notre stand survit à un manque d'espace pour les données (il suffit de nettoyer les disques), un manque d'espace pour les métadonnées entraînera l'effondrement complet du pool et nécessitera sa recréation depuis le début.
Le système de fichiers à l'intérieur du pool se fragmente beaucoup au fil du temps. Je recommande d'exécuter quotidiennement la commande suivante via cron : fstrim -v /var/lib/mysql.
Bilan intermédiaire :
- La technologie est facile à appliquer, tout comme LVM lui-même, et ne nécessite pas de qualification particulière de l'ingénieur.
- Elle conviendra bien pour des bases de données de petite taille et peu sollicitées. Plus la base de données est petite, moins de chunks se déplacent dans le système de fichiers à l'intérieur du pool, et moins la charge sur les disques est élevée.
- Pour notre tâche, nous avons commencé à chercher d'autres solutions, dont nous discuterons dans la section suivante.
Deuxième stand, technologie ZFS
Il y a longtemps, j'ai travaillé avec le système de fichiers ZFS, mais à l'époque, ZFS fonctionnait vraiment bien sur sa famille d'OS d'origine, Solaris. Il y avait une version portée sur FreeBSD avec un niveau de mise en œuvre assez bon. Il existait également un port inachevé sur Linux, qui était peu utilisé. En raison de sa structure de stockage de données en arbre B (qui est la même structure utilisée par InnoDB MySQL), ZFS se comportait mal sur les installations avec un très grand nombre de fichiers. Tout cela, combiné à la nécessité d'apprendre la théorie avant son utilisation, a longtemps rayé ce système de fichiers de ma pratique. Les systèmes ext4 et xfs ont pris le relais comme standards. Cependant, étant donné que ZFS convient parfaitement à notre tâche, et que la version Linux, d'après les avis, est devenue un produit tout à fait raisonnable (bien qu'elle ne soit pas entièrement supportée, ce qui rend l'installation de ZFS complètement depuis zéro possible uniquement avec diverses manipulations), nous avons décidé de l'essayer.
Pour des raisons évidentes, nous avons choisi un stand de configuration similaire (à l'exception du contrôleur RAID). Nous avons installé huit disques SSD de 1920 Go. Nous n'avions pas envie d'écrire notre propre image réseau pour installer le serveur sur un ZFS vierge, donc nous avons pris 50 Go de chaque disque et avons créé un RAID-10 MD pour le système. Les 1950 Go restants sur chaque disque ont été regroupés dans un ZFS similaire à RAID-10 :
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Nous avons créé des partitions pour MySQL :
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Notez que nous avons activé la compression des données par défaut gzip. Nous avons beaucoup de ressources processeur sur notre serveur et elles ne sont pas entièrement utilisées. En conséquence, 3 To de notre base de données ont été réduits à 1,6 To, et puisque le maillon faible, comme dans le cas précédent, est la performance maximale des disques, moins il y a de données, mieux c'est ; nous bénéficions donc dès le départ d'un excellent bonus de ZFS ! Aux heures de pointe, avec une charge complète, le maintien du fonctionnement de gzip utilise jusqu'à 4 cœurs, mais cela ne nous dérange pas.
Ensuite, l'implémentation s'est faite plus rapidement. Nous avons copié les paramètres de réplication MySQL de notre stand LVM. Nous avons dû passer un certain temps à réécrire les scripts en commandes ZFS, mais en gros, les algorithmes sont restés les mêmes. Voici un exemple de création de snapshot :
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
En termes d'optimisation supplémentaire : nous avons extrait en mémoire les sections ZFS contenant des métadonnées et des journaux l2arc et zil. Pour notre tâche, cela s'est avéré par la suite être excessif, mais pour l'instant, nous avons laissé cette optimisation, la changer est facile si besoin. Parmi les effets négatifs, il faut recréer les zones de mémoire correspondantes après un redémarrage du serveur. Les données ne sont pas perdues. Extrait de zpool status :
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
Dans cette configuration, nous avons commencé à tester le banc d'essai et avons obtenu d'excellents résultats : avec deux instances de base de données fonctionnant simultanément (et une réplique principale active) sur des instantanés, nous avons atteint une charge de disque de 50-60 %.
Nous avons résolu notre problème principal, comme le montre le graphique de retard de réplication (comparez-le avec le graphique précédent dans la section Thin LVM) :
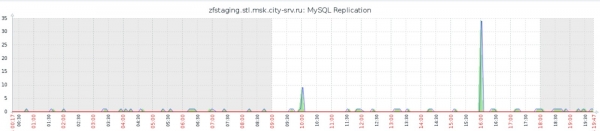
En plus et grâce à cela, nous avons considérablement accéléré toutes les opérations : la création complète d'un instantané avec arrêt et démarrage de la réplique prend jusqu'à 40 secondes, le déploiement d'un nouvel exemplaire de MySQL à partir d'un instantané prend jusqu'à 20 secondes. Ce qui satisfait à la fois nos besoins et nos tests de code.
Bilan intermédiaire :
- Les résultats ont pleinement satisfait notre besoin d'obtenir une copie de la base de données de production pour des tests de code.
- La technologie nécessite une introduction : il est nécessaire de comprendre ce qu'est ZFS et comment travailler avec.
- Nous n'avons pas vérifié le statut actuel du fonctionnement de ZFS avec un grand nombre (plus d'un million) de petits fichiers. Mais nous supposons que le problème persiste, donc je ne recommanderais pas ce système de fichiers pour des solutions de stockage quelconques.
Et après ?
Dans le cadre du stand, nous ne faisons rien de plus, le résultat nous satisfait. Il est possible qu'à l'avenir, nous ajoutions des exceptions de tables dans la configuration de la réplication du stand, qui ne sont pas nécessaires pour les tests, ce qui réduira encore le volume de la base de données. Nous n'avons pas testé le système BTRFS et son implémentation de la technologie de sauvegarde fine. Cela dit, cette tâche n'est plus d'actualité, car l'objectif principal est atteint. En général, bien sûr, nous voulons nous éloigner de l'approche décrite ci-dessus - mettre en œuvre des migrations de bases de données fonctionnelles vers l'environnement de test, créer un contour de test de base de données séparé, travailler sur le sharding de la base de données principale. Beaucoup de cela est déjà en cours, et nous en parlerons certainement dans de futurs articles.
Résultats
La tâche initiale a été résolue, même de manière inhabituelle. Dans les conclusions intermédiaires, les avantages et les inconvénients de chaque technologie utilisée ont été décrits, alors décidons quelle technologie et quand peut être utilisée :
- Thin LVM - pour les petites bases de données et lorsque l'on n'a pas envie ou pas le temps d'étudier ZFS.
- ZFS - si vous avez de l'expérience avec et la possibilité de prendre le temps de l'étudier dans toutes les situations.
À un niveau de présentation plus élevé, cet article n'est pas simplement une comparaison des technologies de deux systèmes de fichiers. L'idée principale que j'aimerais transmettre et ancrer est qu'il ne faut pas avoir peur de penser de manière non conventionnelle dans des situations critiques pour les affaires et de se limiter à des recettes toutes faites. Autrefois, nous pouvions tous secouer la tête en disant que la tâche de créer des copies de base de données de trois téraoctets en moins d'une minute était impossible, et que nous n'avions pas besoin de technologies risquées, faisons comme il se doit. Cela était possible, mais nous aurions perdu environ six mois à un an et de nombreux déplacements de clients (les déplacements étant notre principal indicateur commercial) sans tests et lors de l'implémentation. En agissant de manière non conventionnelle, nous avons perdu peu de temps sur l'implémentation, acquis de l'expérience sur de nouvelles et anciennes technologies oubliées, et fourni des tests exactement au moment où nous en avions vraiment besoin. Cela a sans aucun doute eu un impact positif sur tous nos indicateurs. Le choix reste toujours le vôtre, et de notre côté, nous continuerons à parler sur notre blog des réalisations actuelles et futures intéressantes.
Source : habr.com
