

Bonjour à tous !
Je m'appelle Nikita, je suis le chef d'équipe des ingénieurs chez Cian. L'une de mes responsabilités dans l'entreprise est de réduire le nombre d'incidents liés à l'infrastructure en production à zéro.
Ce dont nous allons parler par la suite nous a causé beaucoup de douleurs, et l'objectif de cet article est d'éviter à d'autres de répéter nos erreurs ou tout au moins de minimiser leur impact.
Préambule
Il était une fois, quand Cian n'était constitué que de monolithes, et qu'il n'y avait aucun indice sur les microservices, nous mesurions la disponibilité des ressources en vérifiant 3 à 5 pages.
S'ils répondent — tout va bien, s'ils ne répondent pas pendant un long moment — alerte. Combien de temps ils doivent être hors service pour que cela soit considéré comme un incident, cela était décidé par des personnes lors de réunions. L'équipe d'ingénieurs participait toujours à l'enquête sur l'incident. Lorsque l'enquête était terminée, un post-mortem était rédigé — un rapport adressé par email sous la forme : ce qui s'est passé, combien de temps cela a duré, ce que nous avons fait sur le moment, ce que nous ferons à l'avenir.
Les pages principales du site ou comment nous savons que nous avons atteint un point critique
Pour pouvoir comprendre la priorité des erreurs, nous avons identifié les pages du site les plus critiques pour la fonctionnalité commerciale. Nous comptons le nombre de requêtes réussies/échouées et de timeouts sur ces pages. Ainsi, nous mesurons le temps de disponibilité.
Supposons que nous avons déterminé qu'il y a plusieurs sections super importantes du site qui sont responsables du service principal — la recherche et la soumission d'annonces. Si le nombre de requêtes qui se terminent par une erreur dépasse 1 %, c'est un incident critique. Si pendant 15 minutes durant les heures de pointe, le pourcentage d'erreurs dépasse 0,1 %, cela est également considéré comme un incident critique. Ces critères couvrent la plus grande partie des incidents, les autres dépassent le cadre de cet article.
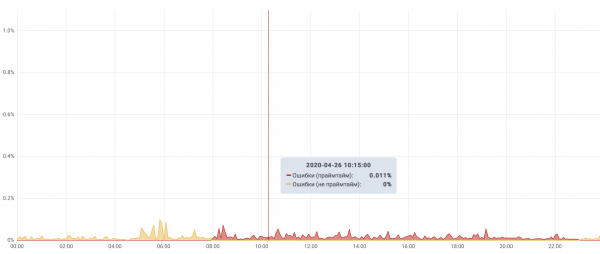
Top des incidents les plus marquants de Cian
Donc, nous avons certainement appris à définir le fait qu'un incident s'est produit.
Maintenant, chaque incident est détaillé et reflété dans une épopée Jira. À propos : pour cela, nous avons créé un projet séparé, que nous avons appelé FAIL — où l'on peut uniquement créer des épopées.
Si nous rassemblons tous les échecs des dernières années, nous constatons que les principaux sont :
- incidents liés à mssql ;
- incidents causés par des facteurs externes ;
- erreurs d'administration.
Concentrons-nous plus en détail sur les erreurs des administrateurs, ainsi que sur quelques autres échecs intéressants.
Cinquième place — « Mettre de l'ordre dans le DNS »
C'était un mardi pluvieux. Nous avons décidé de faire le ménage dans le cluster DNS.
Nous avons voulu migrer nos serveurs DNS de BIND vers PowerDNS, en allouant des serveurs entièrement dédiés à cela, où il n'y a rien d'autre que des DNS.
Nous avons installé un serveur DNS dans chaque emplacement de nos centres de données, et le moment est venu de migrer les zones de BIND vers PowerDNS et de passer notre infrastructure vers les nouveaux serveurs.
Au beau milieu de la migration, tous serveurs, qui étaient indiqués dans les caches locaux de BIND sur tous les serveurs, il ne restait qu'un seul serveur, situé dans le centre de données de Saint-Pétersbourg. Ce DC avait initialement été déclaré non critique pour nous, mais il est soudainement devenu un point de défaillance unique.
Juste à ce moment-là, le lien entre Moscou et Saint-Pétersbourg est tombé. Nous avons été sans DNS pendant cinq minutes, et nous avons récupéré quand l'hébergeur les problèmes ont été résolus.
Conclusions :
Alors qu'auparavant, nous ne tenions pas compte des facteurs externes lors de la préparation des travaux, nous avons désormais inclus ces éléments dans notre liste de préparation. Nous visons désormais à avoir tous les composants redondés en n-2, et pendant la durée des travaux, nous pouvons réduire ce niveau à n-1.
- Lors de l'élaboration du plan d'actions, notez les points où le service pourrait tomber, et planifiez des scénarios où tout pourrait aller "de mal en pis", à l'avance.
- Répartissez les serveurs DNS internes dans différentes géolocalisations / centres de données / racks / commutateurs / entrées.
- Sur chaque serveur, installez un serveur DNS de cache local qui redirige les requêtes vers les serveurs DNS principaux, et en cas d'indisponibilité, répondra à partir du cache.
Quatrième point — «Mise en ordre dans Nginx»
Un beau jour, notre équipe a décidé que "ça suffit" et le processus de refactoring des configurations Nginx a commencé. L'objectif principal était de rendre les configurations intuitivement compréhensibles. Auparavant, tout était "historique" et n'avait aucune logique. Maintenant, chaque server_name a été déplacé dans un fichier homonyme et toutes les configurations ont été réparties dans des dossiers. À propos — la configuration contient 253949 lignes ou 7836520 caractères et fait presque 7 mégaoctets. Le niveau supérieur de la structure:
Structure Nginx
├── accès
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamique
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
C'est devenu beaucoup mieux, mais au cours du renommage et de la réorganisation des configurations, certaines d'entre elles avaient une mauvaise extension et n'étaient pas incluses dans la directive include *.conf. En conséquence, certaines hôtes sont devenus inaccessibles et ont renvoyé 301 vers l'accueil. Comme le code de réponse n'était pas 5xx/4xx, cela n'a pas été remarqué immédiatement, seulement au matin. Après cela, nous avons commencé à écrire des tests pour vérifier les composants d'infrastructure.
Conclusions :
- Structurez correctement les configurations (pas seulement nginx) et pensez à la structure dès le début du projet. Cela les rendra plus compréhensibles pour l'équipe, ce qui à son tour réduira le TTM.
- Pour certains composants d'infrastructure, écrivez des tests. Par exemple : vérifiez que tous les server_name clés renvoient le bon statut, + le corps de la réponse. Avoir simplement quelques scripts sous la main qui vérifient les fonctions principales du composant suffira, afin de ne pas se rappeler frénétiquement à 3 heures du matin ce qu'il faut encore vérifier.
Troisième place — «Soudain, plus d'espace dans Cassandra»
Les données ont progressivement augmenté, et tout allait bien jusqu'au moment où les réparations de grands keyspaces dans le cluster Cassandra ont commencé à échouer, car la compaction ne pouvait pas être effectuée.
Un jour de tempête, le cluster s'est presque transformé en citrouille, à savoir :
- il restait environ 20 % en total dans le cluster ;
- il n'est pas possible d'ajouter des nœuds pleinement, car le nettoyage ne se passe pas après l'ajout d'un nœud en raison du manque d'espace sur les partitions ;
- la performance diminue lentement, car la compaction ne fonctionne pas ;
- le cluster fonctionne en mode d'urgence.
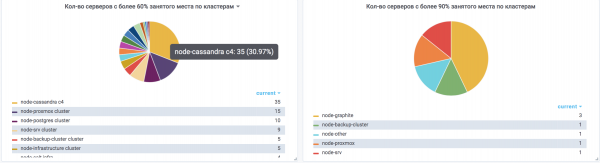
La sortie — nous avons ajouté cinq nœuds sans nettoyage, puis nous avons commencé à les retirer progressivement du cluster et à les réintroduire en tant que nœuds vides, sur lesquels l’espace était épuisé. Le temps consacré a été beaucoup plus long que prévu. Il y avait un risque d'indisponibilité partielle ou complète du cluster.
Conclusions :
- Sur tous les serveurs Cassandra, l'espace occupé ne doit pas dépasser 60 % sur chaque partition.
- Ils ne doivent pas être chargés à plus de 50 % en CPU.
- Ne négligez pas la planification de capacité et réfléchissez-y pour chaque composant, en fonction de ses spécificités.
- Plus il y a de nœuds dans le cluster, mieux c'est. Les serveurs contenant un petit volume de données se redémarrent plus rapidement, et un tel cluster est plus facile à réanimer.
Deuxième place — «Des données ont disparu du stockage clé-valeur de Consul»
Pour la découverte de services, nous utilisons, comme beaucoup, Consul. Mais notre clé-valeur est également utilisée pour la mise en production continue de notre monolithe. Elle stocke des informations sur les upstreams actifs et inactifs, qui changent de place lors du déploiement. Un service de déploiement a été écrit pour interagir avec le KV. À un moment donné, les données du KV ont disparu. Nous les avons récupérées de mémoire, mais avec quelques erreurs. En conséquence, lors de la mise en production, la charge sur les upstreams s'est répartie de manière inégale, et nous avons rencontré de nombreuses erreurs 502 en raison de la surcharge des backends en CPU. Au final, nous avons migré de Consul KV vers Postgres, d'où il n'est pas si facile de les supprimer.
Conclusions :
- Les services sans aucune autorisation ne doivent pas contenir de données critiques pour le fonctionnement du site. Par exemple, si vous n'avez pas d'autorisation dans ES, il serait préférable d'interdire l'accès au niveau réseau de partout où il n'est pas nécessaire, de ne laisser que les accès nécessaires, et de rendre action.destructive_requires_name: true.
- Testez le mécanisme de sauvegarde et de restauration à l'avance. Par exemple, créez à l'avance un script (par exemple, en Python) qui peut à la fois sauvegarder et restaurer.
Première place — «Capitaine Évidence»
À un moment donné, nous avons remarqué une répartition inégale de la charge sur les upstreams nginx lorsque le backend comptait plus de 10 serveurs. Étant donné que le round-robin envoyait les demandes du premier au dernier upstream dans l'ordre, et que chaque rechargement de nginx recommençait, les premiers upstreams recevaient toujours plus de requêtes que les autres. En conséquence, ils fonctionnaient plus lentement et l'ensemble du site en souffrait. Cela devenait de plus en plus perceptible à mesure que le trafic augmentait. Il n'a pas été suffisant de mettre à jour nginx pour activer random — il a fallu réécrire une quantité conséquente de code lua, qui ne fonctionnait pas sur la version 1.15 (à ce moment-là). Nous avons dû patcher notre nginx 1.14.2 pour y intégrer le support du random. Cela a résolu le problème. Ce bug mérite le prix du « capitaine de l'évident ».
Conclusions :
C'était très intéressant et captivant d'explorer ce bug.)
- Mettez en place un suivi afin qu'il aide à détecter rapidement de telles fluctuations. Par exemple, vous pouvez utiliser ELK pour surveiller le RPS sur chaque backend de chaque upstream et suivre leur temps de réponse du point de vue de nginx. Dans ce cas, cela nous a aidés à identifier le problème.
Une grande partie des échecs aurait pu être évitée avec une approche plus scrupuleuse de ce que vous faites. Il faut toujours garder à l'esprit la loi de Murphy : Tout ce qui peut mal tourner, tournera mal, et construire des composants en s'en inspirant.
Source : habr.com
