

Dans nos projets, nous utilisons une architecture de microservices. Lorsqu'il y a des goulets d'étranglement en termes de performance, beaucoup de temps est consacré à la surveillance et à l'analyse des journaux. Lors de la journalisation des délais des opérations individuelles dans un fichier journal, il est souvent difficile de comprendre ce qui a conduit à l'appel de ces opérations, de suivre la séquence des actions ou de comprendre le décalage temporel d'une opération par rapport à une autre dans différents services.
Pour minimiser le travail manuel, nous avons décidé d'utiliser l'un des outils de traçage. Cet article parlera de la manière dont et pour quelles raisons nous pouvons utiliser le traçage.
Quels problèmes peut-on résoudre grâce au traçage
- Identifier les goulets d'étranglement en performance, tant au sein d'un service que dans l'ensemble de l'arbre d'exécution entre tous les services impliqués. Par exemple :
- De nombreux appels consécutifs courts entre les services, par exemple, pour la géocodification ou l'accès à la base de données.
- De longs temps d'attente pour les entrées/sorties, par exemple, le transfert de données sur le réseau ou la lecture sur disque.
- Un long parsing de données.
- Des opérations longues nécessitant une CPU.
- Des segments de code qui ne sont pas nécessaires pour obtenir le résultat final et qui peuvent être supprimés ou exécutés de manière différée.
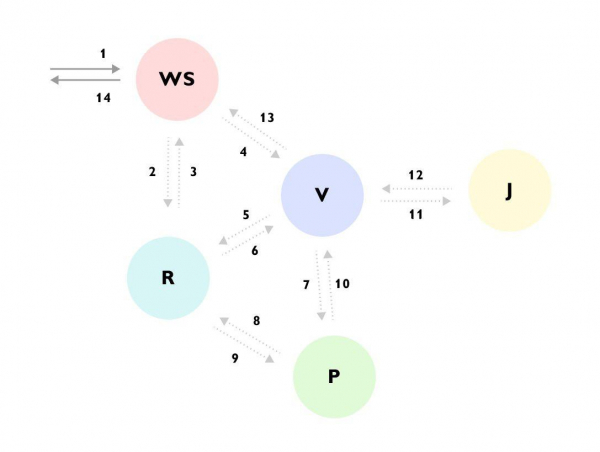
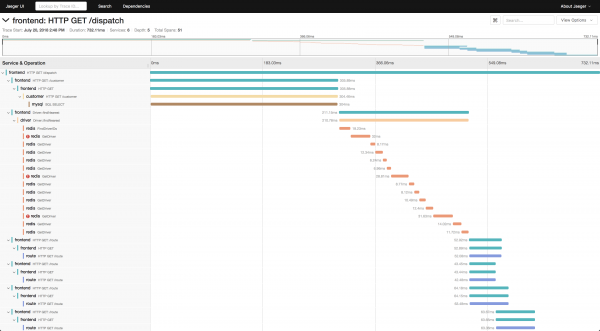
- Comprendre clairement dans quel ordre les appels sont effectués et ce qui se passe lors de l'exécution d'une opération.

On voit que, par exemple, la requête est arrivée au service WS -> le service WS a complété les données via le service R -> ensuite a envoyé une requête au service V -> le service V a chargé beaucoup de données depuis le service R -> a fait appel au service P -> le service P a encore une fois consulté le service R -> le service V a ignoré le résultat et est allé au service J -> et a finalement renvoyé la réponse au service WS, tout en continuant en arrière-plan à calculer autre chose.
Sans ce traçage ou une documentation détaillée sur l'ensemble du processus, il est très difficile de comprendre ce qui se passe au premier coup d'œil sur le code, surtout lorsque le code est dispersé dans différents services et caché derrière de nombreux bins et interfaces. - Collecter des informations sur l'arbre d'exécution pour une analyse ultérieure différée. À chaque étape d'exécution, il est possible d'ajouter des informations disponibles à ce stade dans le traçage et de comprendre ensuite quelles données d'entrée ont conduit à un tel scénario. Par exemple :
- ID utilisateur
- Droits
- Type de méthode sélectionnée
- Journal ou erreur d'exécution
- La transformation des traces en un sous-ensemble de métriques et l'analyse ultérieure sous forme de métriques.
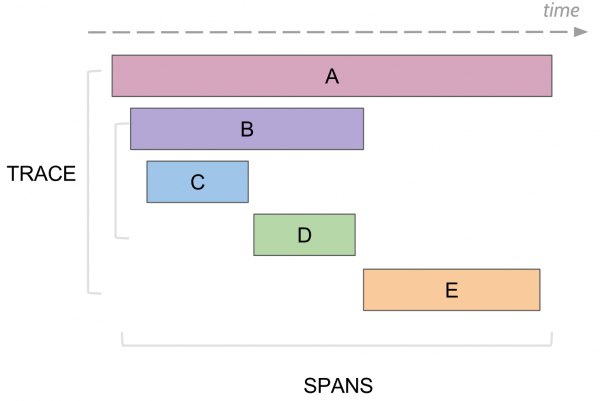
Ce que la traçabilité peut enregistrer. Span
Dans le traçage, il y a le concept de span, qui est l'équivalent d'un log dans la console. Un span a :
- Un nom, généralement le nom de la méthode exécutée
- Le nom du service dans lequel le span a été généré
- Un identifiant unique propre
- Une certaine méta-information sous forme de key/value, qui a été enregistrée dans ce span. Par exemple, les paramètres de la méthode ou si la méthode s'est terminée par une erreur ou non.
- Le temps de début et de fin de l'exécution de ce span
- L'identifiant du span parent
Chaque span est envoyé au collector de spans pour être sauvegardé dans la base de données pour consultation ultérieure dès qu'il a terminé son exécution. Par la suite, il est possible de construire un arbre de tous les spans en les reliant par l'ID du parent. Lors de l'analyse, on peut trouver, par exemple, tous les spans dans un service donné qui ont pris plus d'un certain temps. Ensuite, en consultant un span spécifique, on peut voir tout l'arbre au-dessus et en dessous de ce span.
Opentrace, Jaeger et comment nous l'avons mis en œuvre pour nos projets
Il existe une norme générale , qui décrit comment et quoi collecter, sans lier la traçabilité à une mise en œuvre spécifique dans un langage donné. Par exemple, en Java, tout le travail avec les traces se fait par le biais d'une API commune Opentrace, tandis qu'en dessous peut se cacher, par exemple, Jaeger ou une implémentation par défaut vide qui ne fait rien.
Nous utilisons comme implémentation d'Opentrace. Il se compose de plusieurs composants :
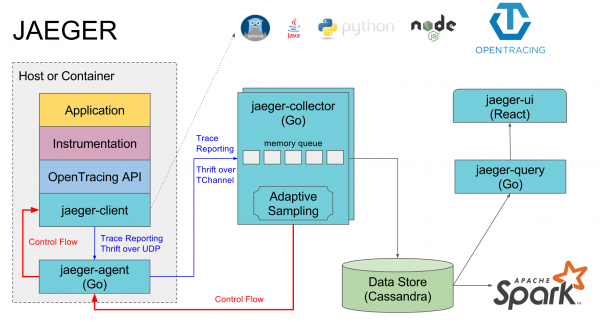
- Jaeger-agent — un agent local, qui est généralement installé sur chaque machine et dans lequel les services enregistrent sur le port par défaut local. Si l'agent est absent, les traces de tous les services sur cette machine sont généralement désactivées.
- Jaeger-collector — tous les agents y envoient les traces collectées, et il les place dans la base de données choisie.
- La base de données — leur préférence est Cassandra, mais nous utilisons Elasticsearch, il existe des implementations pour quelques autres bases de données et une implementation en mémoire qui ne sauvegarde rien sur disque.
- Jaeger-query — c'est un service qui interroge la base de données et restitue les traces collectées pour analyse.
- Jaeger-ui — c'est une interface web pour rechercher et visualiser les traces, elle interroge jaeger-query.
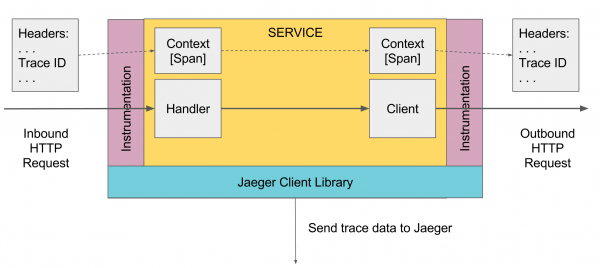
Un composant distinct peut être considéré comme l'implémentation d'opentrace Jaeger pour des langages spécifiques, à travers laquelle les spans sont envoyés au jaeger-agent.
Il s'agit d'implémenter l'interface io.opentracing.Tracer, après quoi toutes les traces passeront par elle vers un véritable agent.
Il est également possible de connecter des composants Spring et l'implémentation de Jaeger qui configurera automatiquement la traçabilité de tout ce qui passe par ces composants, comme les requêtes HTTP dans les contrôleurs, les requêtes à la base de données via JDBC, etc.
Journalisation des traces en Java
À un niveau supérieur, le premier Span doit être créé. Cela peut être fait automatiquement par exemple par le contrôleur Spring lors de la réception d'une requête, ou manuellement s'il n'y a pas de contrôleur. Ensuite, il est transmis par l'intermédiaire du Scope inférieur. Si un quelconque méthode souhaite ajouter un Span, elle prend l'activeSpan actuel à partir du Scope, crée un nouveau Span et indique que son parent est l'activeSpan reçu, puis rend le nouveau Span actif. Lors de l'appel de services externes, l'actuel active span est transmis, et ces services créent de nouveaux spans liés à ce span.
Tout fonctionne via une instance de Tracer, que l'on peut obtenir par le biais du mécanisme DI, ou via GlobalTracer.get() comme une variable globale, si le mécanisme DI ne fonctionne pas. Par défaut, si le tracer n'a pas été initialisé, un NoopTracer sera retourné, qui ne fait rien.
Ensuite, à partir du tracer, le ScopeManager récupère le Scope actuel, crée un nouveau Scope à partir de l'actuel, lié au nouveau span, puis le Scope créé est fermé, ce qui ferme le span créé et restaure l'état actif de l'ancien Scope. Le Scope est lié à un thread, donc en programmation multithread, il ne faut pas oublier de transmettre l'active span dans un autre thread, pour permettre l'activation du Scope de cet autre thread lié à ce span.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Effectuer des actions.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // ÉTAPE 2 CI-DESSUS : réactiver le Span dans le rappel, en passant vrai à
            // startActive() si/quan le Span doit être terminé.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Pour la programmation multithread, il existe également TracedExecutorService et des wrappers similaires qui transmettent automatiquement le span actuel dans le thread lors de l'exécution de tâches asynchrones :
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Pour les requêtes http externes, il y a
HttpClient httpClient = new TracingHttpClientBuilder().build();Les problèmes auxquels nous avons été confrontés
- Les beans et DI ne fonctionnent pas toujours si le tracer est utilisé en dehors d'un service ou d'un composant, alors Le Tracer peut ne pas fonctionner et il faudra utiliser GlobalTracer.get().
- Les annotations ne fonctionnent pas si ce n'est pas un composant ou un service, ou si l'appel de méthode se fait depuis une méthode adjacente de la même classe. Il faut faire attention, vérifier ce qui fonctionne, et utiliser la création manuelle de trace si @Traced ne fonctionne pas. On peut également ajouter un compilateur supplémentaire pour les annotations java, alors elles devraient fonctionner partout.
- Dans les anciennes versions de spring et spring boot, l'autoconfiguration opentracing spring cloud ne fonctionne pas à cause de bugs dans la DI, alors si l'on veut que les traces fonctionnent automatiquement dans les composants Spring, on peut le faire par analogie avec
- En groovy, le try avec ressources ne fonctionne pas, il faut absolument utiliser try finally.
- Chaque service doit spécifier son propre spring.application.name sous lequel les traces seront enregistrées. De plus, un nom distinct pour la production et le test, afin de ne pas les mélanger.
- Si l'on utilise GlobalTracer et tomcat, tous les services lancés dans ce tomcat partagent un seul GlobalTracer, donc ils auront tous le même nom de service.
- Lors de l'ajout de traces à une méthode, il faut s'assurer qu'elle n'est pas appelée en boucle plusieurs fois. Il est nécessaire d'ajouter une trace commune pour tous les appels, qui enregistrera le temps total d'exécution. Sinon, une charge excessive sera générée.
- Une fois, dans jaeger-ui, nous avons effectué des requêtes trop volumineuses sur un grand nombre de traces et, ne pouvant pas attendre la réponse, nous avons réitéré. En fin de compte, jaeger-query a utilisé beaucoup de mémoire et a ralenti elastik. Un redémarrage de jaeger-query a résolu le problème.
Échantillonnage, stockage et visualisation des traces
Il y a trois types :
- Const qui envoie et enregistre toutes les traces.
- Probabilistic qui filtre les traces avec une certaine probabilité définie.
- Le ratelimit qui limite le nombre de traces par seconde. Ces paramètres peuvent être configurés sur le client, soit sur jaeger-agent soit dans le collecteur. Actuellement, dans notre pile de validateurs, nous utilisons const 1 car le nombre de requêtes n'est pas très élevé mais elles prennent beaucoup de temps. À l'avenir, si cela entraîne une charge excessive sur le système, il faudra limiter.
Si l'on utilise Cassandra, par défaut, elle ne conserve les traces que pendant deux jours. Nous utilisons et les traces sont conservées indéfiniment et ne sont pas supprimées. Un index distinct est créé pour chaque jour, par exemple jaeger-service-2019-03-04. À l'avenir, il faudra configurer un nettoyage automatique des anciennes traces.
Pour visualiser les traces, il faut :
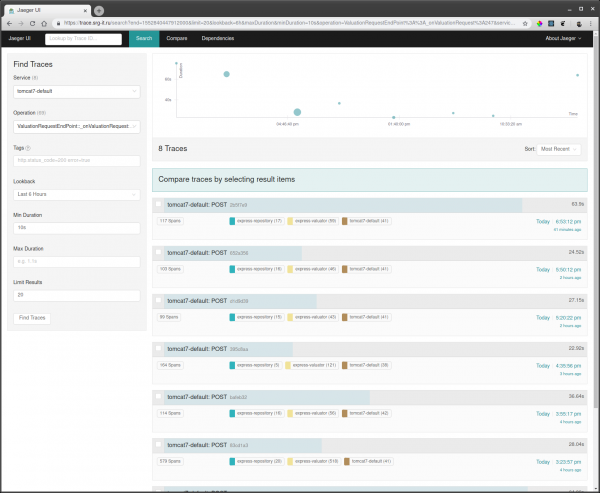
- Choisir le service en fonction duquel vous souhaitez filtrer les traces, par exemple tomcat7-default pour un service qui fonctionne dans Tomcat et qui ne peut pas avoir son propre nom.
- Ensuite, sélectionnez l'opération, la période de temps et la durée minimale de l'opération, par exemple à partir de 10 secondes, afin de ne récupérer que les exécutions longues.

- Accédez à l'une des traces et vérifiez ce qui a causé des ralentissements.

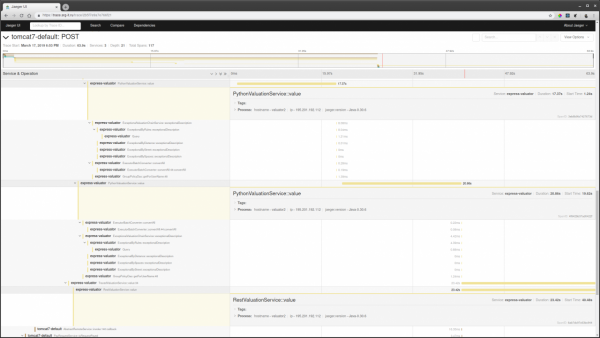
De plus, si un identifiant de requête est connu, il est possible de trouver la trace par cet identifiant via la recherche par balises, si cet identifiant est consigné dans le span de la trace.
Documentation
- Documentation opentracing
- Documentation jaeger
- Connexion jaeger java
- Connexion spring opentracing
Articles
- Jaeger Opentracing et Microservices dans un projet réel en PHP et Golang
- Evolving Distributed Tracing at Uber Engineering
- Exécution de l'agent Jaeger sur du matériel nu
Vidéo
- Comment nous avons utilisé Jaeger et Prometheus pour offrir des requêtes utilisateur ultra-rapides — Bryan Boreham
- Introduction : Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, "Une petite histoire d'un grand succès : OpenTracing, AWS et Jaeger"
Source : habr.com
