

Aujourd'hui, nous allons commencer à étudier le routage via le protocole OSPF. Ce sujet, tout comme l'examen du protocole EIGRP, est crucial dans tout le cours CCNA. Comme vous pouvez le voir, la section 2.4 s'intitule « Configuration, vérification et dépannage d'une zone unique et multizones OSPFv2 pour le protocole IPv4 (à l'exception de l'authentification, du filtrage, de la sommation manuelle des routes, de la redistribution, des zones de poche, des réseaux virtuels et des LSA) ».
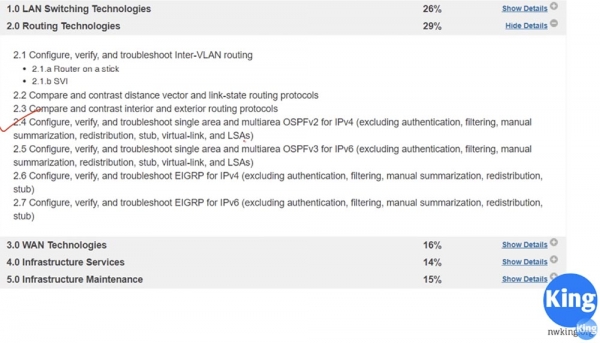
Le sujet OSPF est assez vaste, donc il prendra 2, peut-être 3 vidéos. La leçon d'aujourd'hui sera consacrée à l'aspect théorique, je vais vous expliquer ce qu'est ce protocole en gros et comment il fonctionne. Dans la vidéo suivante, nous passerons au mode de configuration OSPF avec Packet Tracer.
Ainsi, dans cette leçon, nous allons aborder trois choses : qu'est-ce que l'OSPF, comment il fonctionne et qu'est-ce que les zones OSPF. Lors de la leçon précédente, nous avons mentionné que l'OSPF est un protocole de routage de type Link State, qui explore les liaisons entre les routeurs et prend des décisions basées sur la vitesse de ces liaisons. Un long lien avec une vitesse plus élevée, c'est-à-dire avec une plus grande bande passante, sera privilégié par rapport à un lien court avec une bande passante moindre.
Le protocole RIP, étant à vecteur de distance, choisira un chemin en un saut, même si ce lien a une faible vitesse, tandis que le protocole OSPF choisira un itinéraire long de plusieurs sauts si la vitesse totale de cet itinéraire est supérieure à la vitesse de trafic sur le court itinéraire.
Plus tard, nous examinerons l'algorithme de prise de décision, mais pour l'instant, vous devez retenir que l'OSPF est un protocole de l'état des liaisons Link State. Ce standard ouvert a été créé en 1988, donc tout fabricant de matériel réseau et tout fournisseur de réseau pouvait l'utiliser. C'est pourquoi l'OSPF est beaucoup plus populaire que l'EIGRP.
Le protocole OSPF version 2 ne prend en charge que le protocole IPv4, et un an plus tard, en 1989, les développeurs ont annoncé la sortie de la version 3, qui prend en charge l'IPv6. Cependant, la version 3 OSPF pleinement fonctionnelle pour IPv6 n'est apparue qu'en 2008. Pourquoi avoir choisi l'OSPF ? Lors de la dernière leçon, nous avons appris que ce protocole interne réalise la convergence des routes beaucoup plus rapidement que le RIP. C'est un protocole sans classe.
Si vous vous souvenez, RIP est un protocole de classe, c'est-à-dire qu'il ne transmet pas d'informations sur le masque de sous-réseau, et s'il rencontre une adresse IP de classe A/24, il ne l'acceptera pas. Par exemple, si vous lui présentez une adresse IP de type 10.1.1.0/24, il l'interprétera comme le réseau 10.0.0.0, car il ne comprend pas lorsque le réseau est divisé en sous-réseaux à l'aide de plus d'un masque de sous-réseau.
OSPF est un protocole sécurisé. Par exemple, si deux routeurs échangent des informations OSPF, vous pouvez configurer l'authentification de sorte que le partage d'informations avec le routeur voisin ne puisse se faire qu'après la saisie d'un mot de passe. Comme nous l'avons déjà dit, c'est une norme ouverte, donc OSPF est utilisé par de nombreux fabricants d'équipements réseau.
Au sens large, OSPF représente un mécanisme d'échange d'annonces d'état de lien Link State Advertisement, ou LSA. Les messages LSA sont générés par le routeur et contiennent de nombreuses informations : un identifiant unique de routeur router-id, des données sur les réseaux connus du routeur, des données sur leur coût, et ainsi de suite. Toutes ces informations sont nécessaires au routeur pour prendre des décisions de routage.
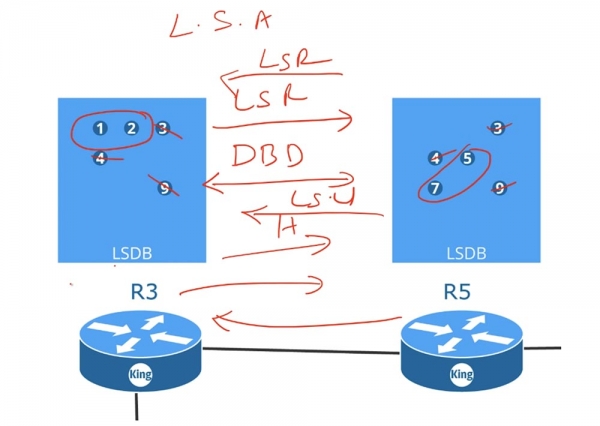
Le routeur R3 envoie ses informations LSA au routeur R5, et le routeur R5 partage ses informations LSA avec R3. Ces LSA constituent une structure de données qui forme la base de données d'état de lien Link State Data Base, ou LSDB. Le routeur collecte tous les LSA reçus et les place dans sa LSDB. Une fois que les deux routeurs ont créé leurs bases de données, ils échangent des messages Hello, qui servent à détecter les voisins, et passent à la procédure de comparaison de leurs LSDB.
Le routeur R3 envoie au routeur R5 un message DBD, ou "description de la base de données", et R5 retourne son DBD au routeur R3. Ces messages contiennent les index LSA présents dans les bases de chaque routeur. Après avoir reçu le DBD, le routeur R3 envoie une demande d'état de réseau LSR au routeur R5, dans laquelle il indique : "j'ai déjà les messages 3, 4 et 9, donc envoyez-moi seulement 5 et 7".
De la même manière, le routeur R5 informe le troisième routeur : « J'ai des informations 3, 4 et 9, alors envoyez-moi 1 et 2 ». Après avoir reçu les demandes LSR, les routeurs renvoient des paquets de mise à jour de l'état du réseau LSU, c'est-à-dire qu'en réponse à leur LSR, le troisième routeur reçoit un LSU du routeur R5. Une fois que les routeurs mettent à jour leurs bases de données, tous, même si vous avez 100 routeurs, auront des bases LSDB identiques. Une fois que les bases de données LSDB sont créées dans les routeurs, chacun d'eux connaîtra l'ensemble du réseau. Le protocole OSPF utilise l'algorithme Shortest Path First pour établir une table de routage, donc une condition essentielle à son bon fonctionnement est la synchronisation des LSDB de tous les dispositifs du réseau.
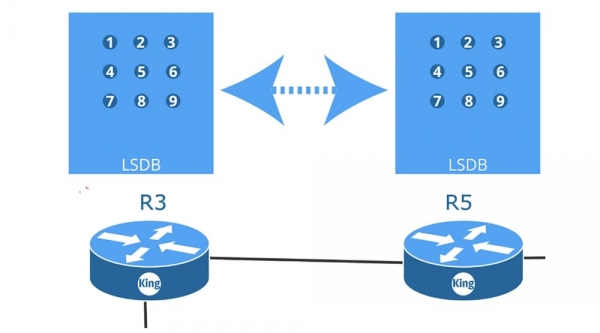
Dans le schéma présenté, il y a 9 routeurs, chacun échangeant des messages LSR, LSU, etc. avec ses voisins. Ils sont tous connectés entre eux par des interfaces de type p2p, ou « point à point », prenant en charge le protocole OSPF, et interagissent les uns avec les autres pour créer des LSDB identiques.
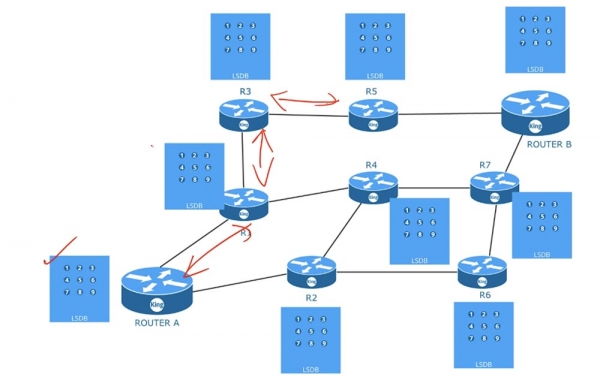
Une fois que les bases sont synchronisées, chaque routeur, en utilisant l'algorithme du chemin le plus court, établit sa propre table de routage. Ces tables seront différentes entre les routeurs. Cela signifie que tous les routeurs utilisent les mêmes LSDB, mais créent des tables de routage basées sur leurs propres considérations des chemins les plus courts. Pour utiliser cet algorithme, OSPF nécessite une mise à jour régulière de la base LSDB.
Ainsi, pour son propre fonctionnement, OSPF doit d'abord satisfaire à 3 conditions : trouver des voisins, créer et mettre à jour la LSDB, et établir une table de routage. Pour remplir la première condition, l'administrateur réseau peut avoir besoin de configurer manuellement le router-id, les timings ou le wildcard mask. Dans la prochaine vidéo, nous examinerons la configuration de l'appareil pour travailler avec OSPF, mais pour l'instant, vous devez savoir que ce protocole utilise un masque inverse, et si celui-ci ne correspond pas, si vos sous-réseaux ne correspondent pas ou si l'authentification ne correspond pas, les voisinages des routeurs ne pourront pas se former. Donc, lors du dépannage du fonctionnement de l'OSPF, vous devez déterminer pourquoi ce voisinage ne se forme pas, c'est-à-dire vérifier la correspondance des paramètres mentionnés ci-dessus.
En tant qu'administrateur réseau, vous ne participez pas au processus de création de la LSDB. La mise à jour des bases de données se produit automatiquement après la création du voisinage des routeurs, tout comme la construction des tables de routage. Tout cela est exécuté par l'appareil lui-même, configuré pour travailler avec le protocole OSPF.
Prenons un exemple. Nous avons 2 routeurs, auxquels j'ai attribué pour simplifier les identifiants RID 1.1.1.1 et 2.2.2.2. Dès que nous les connecterons, le canal link passera immédiatement à l'état up, car j'ai d'abord configuré ces routeurs pour fonctionner avec OSPF. Une fois que le canal de communication est formé, le routeur A enverra immédiatement un paquet Hello au second. Ce paquet contiendra des informations indiquant que ce routeur n'a encore ‘vu’ aucun voisin sur ce canal, car il envoie un Hello pour la première fois, ainsi que son propre identifiant, des données sur le réseau auquel il est connecté et d'autres informations qu'il peut partager avec le voisin.
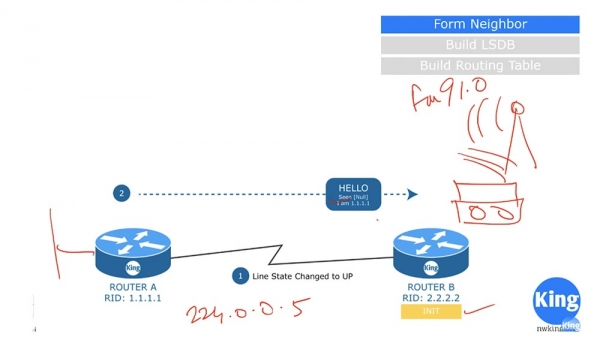
Après avoir reçu ce paquet, le routeur B dira : « Je vois qu'il y a un candidat potentiel pour le voisinage selon le protocole OSPF sur ce canal de communication » et passera à l'état d'initialisation Init state. Le paquet Hello n'est pas un message unicast ou broadcast, c'est un paquet multicast, envoyé à l'adresse IP multicast OSPF 224.0.0.5. Certaines personnes se demandent quelle est le masque de sous-réseau pour le multicast. En réalité, le multicast n'a pas de masque de sous-réseau, il se propage comme un signal radio, que tous les appareils configurés pour sa fréquence peuvent entendre. Par exemple, si vous souhaitez écouter une radio FM diffusant sur la fréquence 91,0, vous devez régler votre récepteur radio sur cette fréquence.
De la même manière, le routeur B est configuré pour recevoir des messages pour l'adresse multicast 224.0.0.5. Écoutant ce canal, il reçoit le paquet Hello envoyé par le routeur A et lui répond avec son propre message.
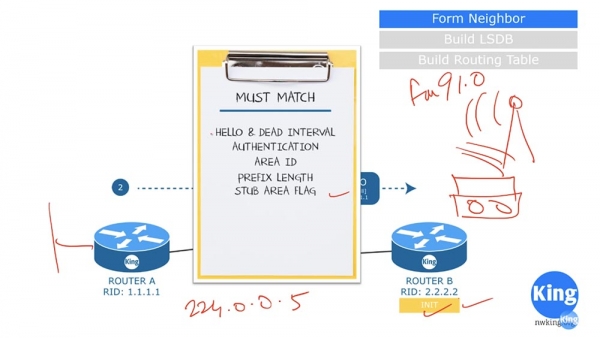
Cependant, le voisinage ne peut être établi que si la réponse de B satisfait un ensemble de critères. Le premier critère est que la fréquence d'envoi des messages Hello et l'intervalle d'attente de la réponse à ce message, le Dead Interval, doivent correspondre pour les deux routeurs. En général, le Dead Interval équivaut à plusieurs valeurs du minuteur Hello. Ainsi, si le Hello Timer du routeur A est de 10 s, et que le routeur B lui envoie un message au bout de 30 s, alors que le Dead Interval est de 20 s, le voisinage ne sera pas établi.
Le deuxième critère est que les deux routeurs doivent utiliser le même type d'authentification. Par conséquent, les mots de passe d'authentification doivent également correspondre.
Le troisième critère est la correspondance des identifiants de zone Arial ID, le quatrième est la correspondance de la longueur du préfixe réseau. Si le routeur A signale un préfixe /24, alors le routeur B doit également avoir un préfixe réseau /24. Dans la prochaine vidéo, nous examinerons cela plus en détail, pour l'instant, je souligne que ce n'est pas un masque de sous-réseau, ici les routeurs utilisent un masque inversé Wildcard mask. Et bien sûr, les indicateurs de zone de stub Stub area doivent également correspondre si les routeurs se trouvent dans cette zone.
Après la vérification de ces critères, si ceux-ci correspondent, le routeur B envoie à son tour un paquet Hello au routeur A. Contrairement au message A, le routeur B indique qu'il a vu le routeur A et se fait connaître lui-même.
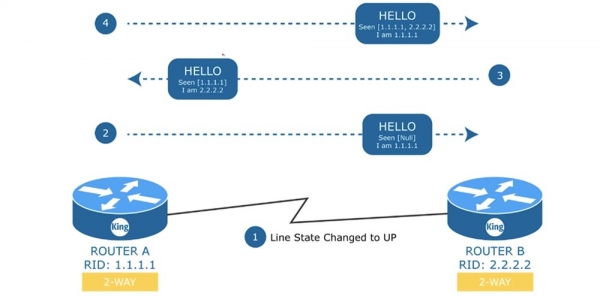
En réponse à ce message, le routeur A renvoie à son tour un paquet Hello au routeur B, dans lequel il confirme avoir également vu le routeur B, la liaison entre eux étant composée des appareils 1.1.1.1 et 2.2.2.2, et lui-même étant l'appareil 1.1.1.1. C'est une étape très importante dans l'établissement du voisinage. Dans ce cas, une connexion bidirectionnelle 2-WAY est utilisée, mais que se passe-t-il si nous avons un switch avec un réseau distribué de 4 routeurs ? Dans ce type d'environnement "partagé", l'un des routeurs doit jouer le rôle de routeur désigné Designated router D.R, et l'autre un routeur désigné de secours Backup designated router, B.D.R.
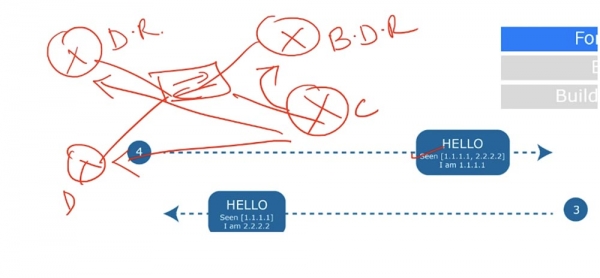
Chacun de ces appareils formera une connexion Full connection, ou état de pleine adjacency ; nous verrons plus tard ce que cela signifie, cependant, ce type de connexion ne sera établi qu'avec le D.R. et le B.D.R., alors que les deux routeurs inférieurs D et B continueront à communiquer entre eux selon le schéma de connexion bidirectionnelle "point-à-point".
C'est-à-dire qu'avec le D.R. et le B.D.R., tous les routeurs établissent un rapport de pleine voisinage, tandis qu'entre eux, ils maintiennent une connexion de type point-à-point. C'est très important, car lors d'une connexion bidirectionnelle entre les appareils adjacents, tous les paramètres du paquet Hello doivent correspondre. Dans notre cas, tout correspond, donc les appareils forment sans problème le voisinage.
Dès que la connexion bidirectionnelle est établie, le routeur A envoie au routeur B un paquet Database Description, ou « description de la base de données », et passe à l'état ExStart — début de l'échange ou attente de chargement. Le Database Descriptor représente des informations similaires à la table des matières d'un livre – c'est un énumération de tout ce qui se trouve dans la base de données de routage. En réponse, le routeur B envoie sa description de base de données au routeur A et passe à l'état d'échange des données de canaux Exchange. Si, dans l'état Exchange, le routeur détecte qu'il lui manque certaines informations dans sa base de données, il passera à l'état de chargement LOADING et commencera à échanger avec son voisin des messages LSR, LSU et LSA.
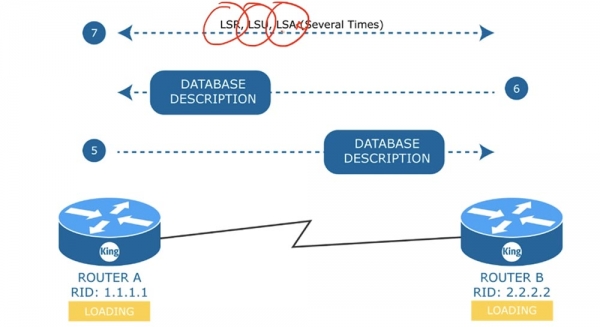
Ainsi, le routeur A enverra un LSR à son voisin, qui lui répondra par un paquet LSU, auquel le routeur A répondra avec un message LSA. Cet échange se produira autant de fois que nécessaire pour que les appareils souhaitent échanger des messages LSA. L'état LOADING signifie que la mise à jour complète de la base de données LSA n'a pas encore eu lieu. Une fois toutes les données chargées, les deux appareils passeront à l'état de pleine adjacence FULL.
Je remarque que dans une connexion bidirectionnelle, les appareils se trouvent simplement en état de voisinage, tandis que l'état de pleine adjacence n'est possible qu'entre les routeurs D.R. et B.D.R. Cela signifie que chaque routeur informe le D.R. des changements dans le réseau, et tous les routeurs apprennent ces changements par le biais du D.R.
Le choix du D.R. et du B.D.R. est une question importante. Examinons comment le choix du D.R. se déroule dans un environnement commun. Supposons que notre schéma comporte trois routeurs et un switch. Tout d'abord, les appareils OSPF comparent les priorités dans les messages Hello, puis ils comparent les Router ID.
L'appareil ayant la priorité la plus élevée devient D.R. Si les priorités de deux appareils se chevauchent, l'appareil avec le plus haut Router ID est choisi pour devenir D.R.
Le routeur désigné de secours B.D.R. devient l'appareil avec la deuxième priorité la plus élevée ou le deuxième Router ID le plus important. Si le D.R. échoue, il sera immédiatement remplacé par le B.D.R. Il commencera à jouer le rôle de D.R., tandis que le système choisira un autre B.D.R.
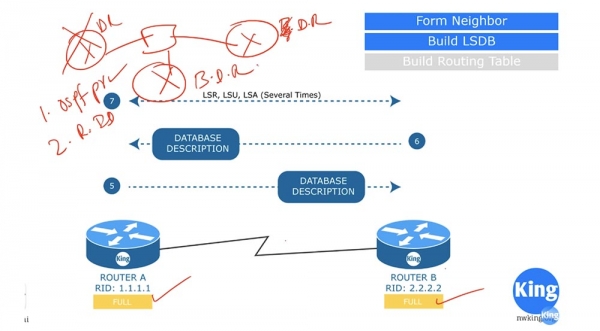
J'espère que vous avez compris le choix du D.R. et du B.D.R. Si ce n'est pas le cas, je reviendrai sur ce sujet dans l'une de mes prochaines vidéos et expliquerai ce processus.
Nous avons donc examiné ce que sont Hello, la description de la base de données Database Descriptor, et les messages LSR, LSU et LSA. Avant de passer au sujet suivant, discutons un peu du coût OSPF.
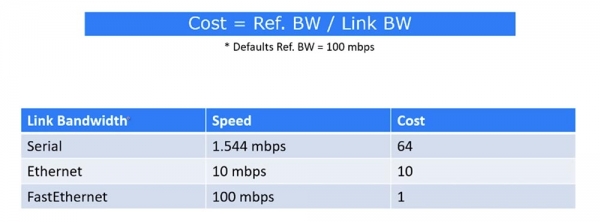
Dans Cisco, le coût d'un itinéraire est calculé selon la formule du rapport entre la bande passante de référence (Reference bandwidth), qui est par défaut de 100 Mbit/s, et le coût du lien. Par exemple, lorsque des appareils sont connectés via un port série, la vitesse est de 1.544 Mbit/s, et le coût sera de 64. En utilisant une connexion Ethernet à une vitesse de 10 Mbit/s, le coût est de 10, tandis que le coût d'une connexion FastEthernet à 100 Mbit/s sera de 1.
Avec Gigabit Ethernet, nous avons une vitesse de 1000 Mbit/s, mais dans ce cas, la vitesse est toujours considérée comme 1. Ainsi, si vous avez du Gigabit Ethernet dans votre réseau, vous devez modifier la valeur par défaut de Ref. BW à 1000. Dans ce cas, le coût sera de 1 et l'ensemble du tableau sera recalculé en multipliant les valeurs des coûts par 10. Après avoir établi le voisinage et construit la base de données LSDB, nous passons à la construction du tableau de routage.
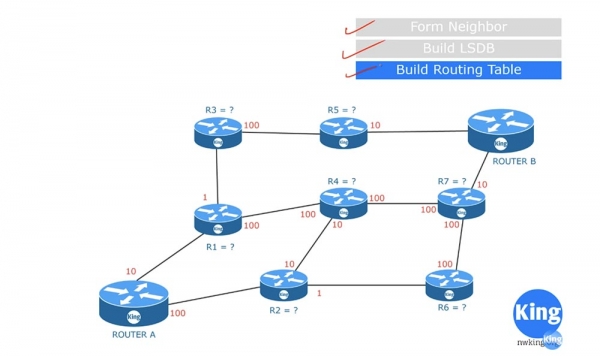
Après avoir reçu le LSDB, chaque routeur commence à élaborer sa liste d'itinéraires à l'aide de l'algorithme SPF. Dans notre schéma, le routeur A créera ce tableau pour lui-même. Par exemple, il calcule le coût de l'itinéraire A-R1 et le détermine à 10. Pour simplifier la compréhension du schéma, supposons que le routeur A détermine l'itinéraire optimal vers le routeur B. Le coût de la connexion A-R1 est de 10, celui de A-R2 est de 100, et le coût de l'itinéraire A-R3 est de 11, c'est-à-dire la somme de l'itinéraire A-R1 (10) et R1-R3 (1).
Si le routeur A souhaite atteindre le routeur R4, il peut le faire soit par l'itinéraire A-R1-R4, soit par l'itinéraire A-R2-R4, dans les deux cas le coût des itinéraires sera le même : 10+100 = 100+10 = 110. L'itinéraire A-R6 coûtera 100+1 = 101, ce qui est déjà meilleur. Ensuite, nous analysons le chemin vers le routeur R5 par l'itinéraire A-R1-R3-R5, dont le coût sera de 10+1+100 = 111.
Le chemin vers le routeur R7 peut être tracé par deux itinéraires : A-R1-R4-R7 ou A-R2-R6-R7. Le coût du premier sera de 210, et celui du second sera de 201, il convient donc de choisir 201. Ainsi, pour atteindre le routeur B, le routeur A peut utiliser 4 itinéraires.
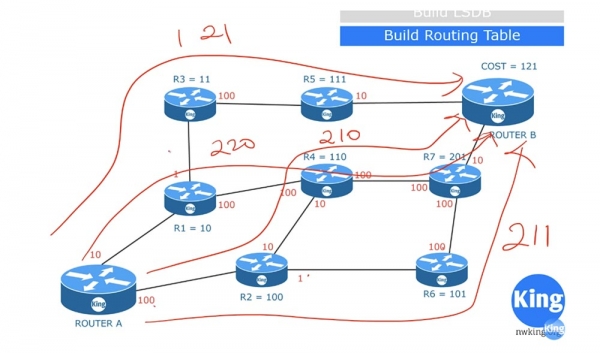
Le coût de la route A-R1-R3-R5-B sera de 121. La route A-R1-R4-R7-B coûtera 220. La route A-R2-R4-R7-B coûte 210, tandis que A-R2-R6-R7-B a un coût de 211. Sur cette base, le routeur A choisira la route avec le coût le plus bas, soit 121, et l'ajoutera à la table de routage. Cela est un schéma très simplifié du fonctionnement de l'algorithme SPF. En réalité, la table contient non seulement les désignations des routeurs par lesquels passe la route optimale, mais aussi les désignations des ports qui les relient et toutes les autres informations nécessaires.
Considérons un autre sujet lié aux zones de routage. En général, lors de la configuration des appareils OSPF de l'entreprise, tous se trouvent dans une zone commune.
Que se passe-t-il si un appareil connecté au routeur R3 tombe soudainement en panne ? Le routeur R3 commencera immédiatement à envoyer aux routeurs R5 et R1 un message indiquant que le canal avec cet appareil ne fonctionne plus, et tous les routeurs commenceront à échanger des mises à jour à propos de cet événement.
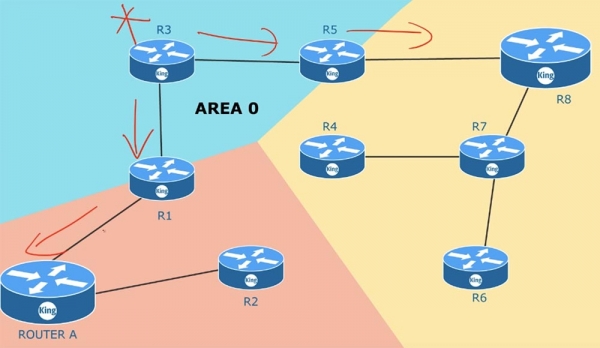
Si vous avez 100 routeurs, ils mettront tous à jour les informations sur l'état des canaux, car ils se trouvent dans une zone commune. Il en sera de même si l'un des routeurs voisins tombe en panne : tous les appareils de la zone échangeront des mises à jour LSA. Après cet échange de messages, la topologie du réseau changera. Dès que cela se produira, le SPF recalculera les tables de routage selon les nouvelles conditions. C'est un processus très volumineux, et si vous avez mille appareils dans une seule zone, vous devez surveiller la taille de la mémoire des routeurs pour qu'elle soit suffisante pour stocker tous les LSA et une énorme base de données d'état des canaux LSDB. Dès qu'il y a des changements dans une partie de la zone, l'algorithme SPF recalculera immédiatement les itinéraires. Par défaut, le LSA est mis à jour toutes les 30 minutes. Ce processus se produit sur tous les appareils non simultanément, mais dans tous les cas, les mises à jour sont effectuées par chaque routeur à intervalle de 30 minutes. Plus il y a d'appareils réseau, plus il faut de mémoire et de temps pour mettre à jour le LSDB.
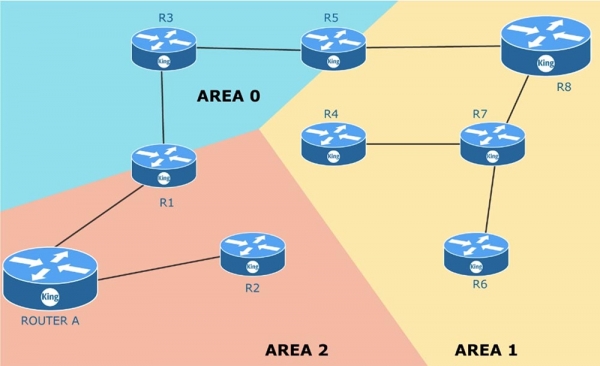
On peut résoudre ce problème en divisant une zone commune en plusieurs zones distinctes, c'est-à-dire en utilisant le multi-zonage. Pour cela, vous devez avoir un plan ou un schéma de l'ensemble du réseau que vous gérez. La zone zéro AREA 0 est votre zone principale. C'est l'endroit où se fait la connexion avec le réseau externe, par exemple, la sortie vers Internet. Lors de la création de nouvelles zones, vous devez respecter la règle suivante : chaque zone doit comporter un routeur frontière ABR, ou Area Border Router. Le routeur frontière a une interface dans une zone et une seconde interface dans une autre zone. Par exemple, le routeur R5 a des interfaces dans la zone 1 et la zone 0. Comme je l'ai dit, chaque zone doit être connectée à la zone zéro, c'est-à-dire disposer d'un routeur frontière, dont une des interfaces est connectée à AREA 0.
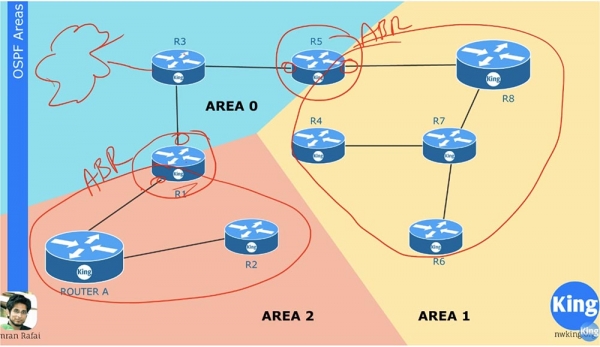
Supposons que la connexion R6-R7 soit défaillante. Dans ce cas, la mise à jour LSA ne se propagera que dans la zone AREA 1 et ne concernera que cette zone. Les dispositifs dans la zone 2 et la zone 0 ne seront même pas au courant. Le routeur frontière R5 synthétise l'information sur ce qui se passe dans sa zone et envoie dans la zone principale AREA 0 un résumé de l'état du réseau. Les dispositifs d'une même zone n'ont pas besoin de connaître tous les changements LSA au sein des autres zones, car le routeur ABR transmettra des informations résumées sur les routes d'une zone à l'autre.
Si vous n'avez pas tout à fait compris le concept de zones, vous pourrez en savoir plus dans les leçons suivantes, lorsque nous aborderons la configuration de la routage OSPF et examinerons quelques exemples.
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenus intéressants ? Soutenez-nous en passant une commande ou en recommandant à vos amis. 30% de réduction pour les utilisateurs de Habr sur un équivalent unique des serveurs d'entrée de gamme, conçu spécialement pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd à moitié prix ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
