

Pour maîtriser Kubernetes, il est nécessaire de connaître les différentes méthodes de mise à l'échelle des ressources de cluster : selon , c'est l'une des principales tâches de Kubernetes. Nous avons préparé un aperçu détaillé des mécanismes d'automatisation horizontale et verticale de la mise à l'échelle et de la redimension des clusters, ainsi que des recommandations sur la manière de les utiliser efficacement.
L'article a été traduit par l'équipe qui a mis en œuvre l'automatisation de la mise à l'échelle dans .
Pourquoi il est important de réfléchir à la mise à l'échelle
— un outil pour la gestion des ressources et l'orchestration. Bien sûr, il est intéressant de jouer avec les fonctionnalités impressionnantes de déploiement, de surveillance et de gestion des pods (le module pod est un groupe de conteneurs, lancé en réponse à une demande).
Cependant, il est également important de réfléchir à des questions telles que :
- Comment mettre à l'échelle les modules et les applications ?
- Comment maintenir les conteneurs en état de fonctionnement et efficaces ?
- Comment réagir aux changements constants dans le code et aux charges de travail des utilisateurs ?
Configurer des clusters Kubernetes pour un équilibrage des ressources et des performances peut être une tâche complexe, nécessitant une expertise sur le fonctionnement interne de Kubernetes. La charge de travail sur votre application ou vos services peut fluctuer au cours de la journée ou même en une heure, c'est pourquoi l'équilibrage devrait être considéré comme un processus continu.
Niveaux de mise à l'échelle automatique de Kubernetes
Une mise à l'échelle automatique efficace nécessite une coordination entre deux niveaux :
- Le niveau des pods, comprenant la mise à l'échelle horizontale (Horizontal Pod Autoscaler, HPA) et la mise à l'échelle verticale (Vertical Pod Autoscaler, VPA). C'est la mise à l'échelle des ressources existantes pour vos conteneurs.
- Le niveau du cluster, géré par le système de mise à l'échelle automatique des clusters (Cluster Autoscaler, CA), qui augmente ou diminue le nombre de nœuds dans le cluster.
Le module de mise à l'échelle automatique horizontale (HPA)
Comme son nom l'indique, le HPA ajuste le nombre de replicas des pods. Comme déclencheurs pour modifier le nombre de replicas, la plupart des DevOps utilisent la charge CPU et la mémoire. Cependant, il est également possible de mettre à l'échelle le système sur la base des , leurs ou même .
Diagramme de haut niveau du fonctionnement du HPA :
- HPA vérifie en continu les valeurs des métriques spécifiées lors de l'installation, avec un intervalle par défaut de 30 secondes.
- HPA tente d'augmenter le nombre de modules si un seuil spécifié est atteint.
- HPA met à jour le nombre de réplicas au sein du contrôleur de déploiement/réplication.
- Le contrôleur de déploiement/réplication déploie ensuite tous les modules supplémentaires nécessaires.
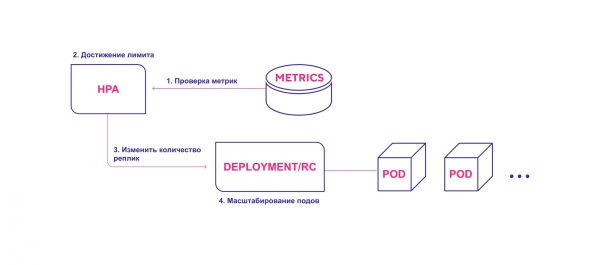
HPA lance le processus de déploiement des modules lorsqu'un seuil de métrique est atteint.
Lors de l'utilisation de HPA, tenez compte des éléments suivants :
- L'intervalle de vérification par défaut de HPA est de 30 secondes. Il est fixé par le paramètre horizontal-pod-autoscaler-sync-period dans le gestionnaire de contrôleur.
- L'erreur relative par défaut est de 10%.
- Après la dernière augmentation du nombre de modules, HPA attend la stabilisation des métriques pendant trois minutes. Cet intervalle est défini par le paramètre horizontal-pod-autoscaler-upscale-delay.
- Après la dernière diminution du nombre de modules, HPA attend la stabilisation pendant cinq minutes. Cet intervalle est défini par le paramètre horizontal-pod-autoscaler-downscale-delay.
- HPA fonctionne mieux avec des objets de déploiement plutôt qu'avec des contrôleurs de réplication. Le scaling horizontal est incompatible avec la mise à jour continue (rolling update), qui manipule directement les contrôleurs de réplication. Lors d'un déploiement, le nombre de réplicas dépend directement des objets de déploiement.
Mise à l'échelle verticale des pods
La mise à l'échelle verticale (VPA) alloue plus (ou moins) de temps processeur ou de mémoire aux pods existants. Elle convient aux pods avec état (stateful) ou sans état (stateless), mais est principalement conçue pour les services stateful. Cependant, vous pouvez également appliquer VPA à des modules sans état si vous avez besoin d'ajuster automatiquement la quantité de ressources initialement allouées.
VPA réagit également aux événements OOM (out of memory, manque de mémoire). Pour modifier le temps processeur et la mémoire, un redémarrage des pods est nécessaire. Lors du redémarrage, VPA respecte le budget de répartition (), afin de garantir le nombre minimum nécessaire de modules.
Vous pouvez définir un volume minimal et maximal de ressources pour chaque module. Par exemple, vous pouvez limiter la mémoire allouée à un maximum de 8 Go. Cela est utile si les nœuds actuels ne peuvent pas allouer plus de 8 Go de mémoire par conteneur. Les spécifications détaillées et le mécanisme de fonctionnement sont décrits dans .
De plus, le VPA dispose d'une fonction intéressante de recommandations (VPA Recommender). Elle suit l'utilisation des ressources et les événements OOM de tous les modules afin de proposer de nouvelles valeurs de mémoire et de temps processeur sur la base d'un algorithme intelligent prenant en compte des métriques historiques. Il existe également une interface API qui prend en entrée un descripteur de pod et fournit les valeurs de ressources recommandées.
Il convient de noter que le VPA Recommender ne suit pas la « limite » des ressources. Cela peut entraîner une monopolisation des ressources à l'intérieur des nœuds. Il est préférable d'établir une valeur limite au niveau de l'espace de noms pour éviter une consommation excessive de mémoire ou de temps processeur.
Schéma de fonctionnement de haut niveau du VPA :
- Le VPA vérifie en continu les valeurs des métriques spécifiées à l'installation, à intervalles par défaut de 10 secondes.
- Si le seuil défini est atteint, le VPA tente de modifier la quantité de ressources allouées.
- Le VPA met à jour le nombre de ressources au sein du contrôleur de déploiement/réplication.
- Lors du redémarrage des modules, toutes les nouvelles ressources sont appliquées aux instances créées.
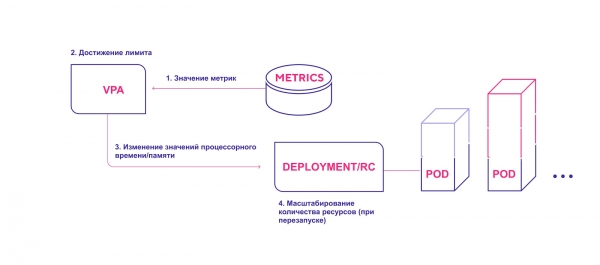
Le VPA ajoute la quantité nécessaire de ressources
Prenez en compte les éléments suivants lors de l'utilisation du VPA :
- Le mise à l'échelle nécessite un redémarrage obligatoire du pod. Cela est nécessaire pour éviter une instabilité après les modifications. Pour plus de fiabilité, les modules se redémarrent et se distribuent sur les nœuds en fonction des nouvelles ressources allouées.
- Le VPA et le HPA ne sont pas encore compatibles entre eux et ne peuvent pas fonctionner sur les mêmes pods. Si vous appliquez les deux mécanismes de mise à l'échelle dans un cluster, assurez-vous que les paramètres ne leur permettent pas d'être activés sur les mêmes objets.
- VPA configure les demandes de conteneurs en ressources uniquement en fonction de leur utilisation passée et actuelle. Il ne fixe pas de limites d'utilisation des ressources. Des problèmes peuvent survenir avec le fonctionnement incorrect des applications qui commencent à consommer de plus en plus de ressources, ce qui entraînera l'arrêt de ce pod par Kubernetes.
- VPA est encore en phase de développement précoce. Soyez prêt à ce que le système subisse des changements dans un avenir proche. Vous pouvez lire sur et . Ainsi, il est prévu de mettre en œuvre la coopération entre VPA et HPA, ainsi que le déploiement de modules avec une politique de mise à l'échelle verticale automatisée pour eux (par exemple, une étiquette spéciale ‘requires VPA’).
Mise à l'échelle automatique du cluster Kubernetes
Le Cluster Autoscaler (CA) ajuste le nombre de nœuds en fonction du nombre de pods en attente. Le système vérifie périodiquement l'existence de pods en attente et augmente la taille du cluster si davantage de ressources sont nécessaires, tout en respectant les limites imposées. Le CA interagit avec le fournisseur de cloud, lui demandant des nœuds supplémentaires ou libérant ceux qui ne sont pas utilisés. La première version publique du CA a été présentée dans Kubernetes 1.8.
Schéma de fonctionnement de haut niveau du CA :
- Le CA vérifie l'existence de pods en attente à un intervalle par défaut de 10 secondes.
- Si un ou plusieurs pods sont en attente en raison d'un manque de ressources disponibles dans le cluster pour les allouer, il tente de préparer un ou plusieurs nœuds supplémentaires.
- Lorsque le fournisseur de cloud alloue le nœud nécessaire, celui-ci rejoint le cluster et est prêt à servir les pods.
- Le planificateur Kubernetes répartit les pods en attente sur le nouveau nœud. Si certains pods restent toujours en attente après cela, le processus se répète - et de nouveaux nœuds sont ajoutés au cluster.
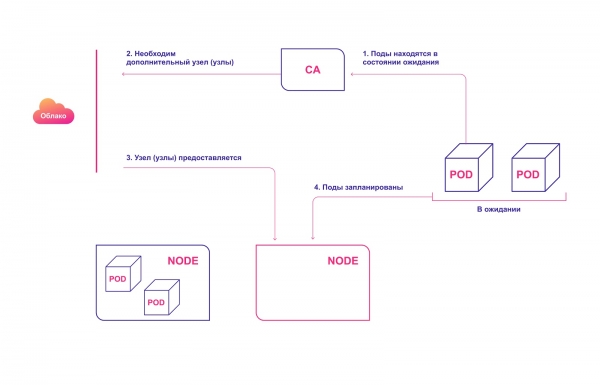
Allocation automatique des nœuds de cluster dans le cloud
Prenez en compte ce qui suit lors de l'utilisation du CA :
- Le CA garantit que tous les pods dans le cluster ont de la place pour s'exécuter, quel que soit le niveau de charge du processeur. De plus, il essaie de s'assurer qu'il n'y a pas de nœuds inutiles dans le cluster.
- CA enregistre le besoin de mise à l'échelle environ toutes les 30 secondes.
- Une fois qu'un nœud devient inutile, CA attend par défaut 10 minutes avant de mettre à l'échelle le système.
- Dans le système d'auto-scaling, il existe le concept d'extenseurs (expanders). Ce sont différentes stratégies pour choisir le groupe de nœuds auquel de nouveaux nœuds seront ajoutés.
- Utilisez avec responsabilité l'option cluster-autoscaler.kubernetes.io/safe-to-evict (true). Si vous déployez beaucoup de pods ou si beaucoup d'entre eux sont dispersés sur tous les nœuds, vous perdrez considérablement la capacité de réduire la taille du cluster.
- Windows VPS pour le travail à distance , afin d'éviter la suppression de pods, ce qui pourrait rendre une partie de votre application complètement hors service.
Comment les systèmes d'auto-scaling Kubernetes interagissent entre eux
Pour une harmonie parfaite, il convient d'appliquer l'auto-scaling à la fois au niveau des pods (HPA/VPA) et au niveau du cluster. Ils interagissent relativement facilement entre eux :
- HPA ou VPA mettent à jour les répliques de pods ou les ressources allouées aux pods existants.
- Si des nœuds sont insuffisants pour le scaling prévu, CA détecte la présence de pods en attente.
- CA alloue de nouveaux nœuds.
- Les modules sont répartis sur les nouveaux nœuds.
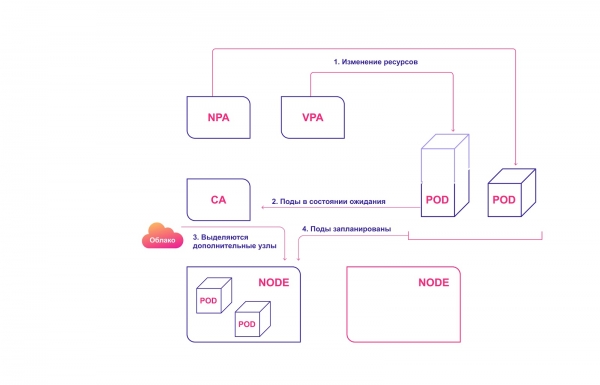
Système d'échelle conjointe des systèmes Kubernetes
Erreurs typiques dans l'auto-scaling Kubernetes
Il existe plusieurs problèmes typiques que les DevOps rencontrent lorsqu'ils essaient d'appliquer l'auto-scaling.
HPA et VPA dépendent des métriques et de certaines données historiques. Si les ressources allouées sont insuffisantes, les modules seront réduits et ne pourront pas générer de métriques. Dans ce cas, l'auto-scaling ne se produira jamais.
L'opération de mise à l'échelle elle-même est sensible au temps. Nous souhaitons que les modules et le cluster se mettent à l'échelle rapidement — avant que les utilisateurs ne remarquent des problèmes ou des pannes. Il faut donc prendre en compte le temps moyen de mise à l'échelle des pods et du cluster.
Le scénario idéal — 4 minutes :
- 30 secondes. Mise à jour des métriques cibles : 30−60 secondes.
- 30 secondes. HPA vérifie les valeurs des métriques : 30 secondes.
- Moins de 2 secondes. Les modules pod sont créés et passent à l'état d'attente : 1 seconde.
- Moins de 2 secondes. CA voit les modules en attente et envoie des appels pour préparer les nœuds : 1 seconde.
- 3 minutes. Le fournisseur cloud alloue les nœuds. K8s attend qu'ils soient prêts : jusqu'à 10 minutes (cela dépend de plusieurs facteurs).
Le pire scénario (plus réaliste) est de 12 minutes :
- 30 secondes. Mise à jour des métriques cibles.
- 30 secondes. HPA vérifie les valeurs des métriques.
- Moins de 2 secondes. Les modules pod sont créés et passent en état d'attente.
- Moins de 2 secondes. CA voit les modules en attente et envoie des appels pour préparer les nœuds.
- 10 minutes. Le fournisseur cloud alloue les nœuds. K8s attend qu'ils soient prêts. Le temps d'attente dépend de plusieurs facteurs, tels que la latence du fournisseur, la latence du système d'exploitation, le fonctionnement des outils auxiliaires.
Ne confondez pas les mécanismes de mise à l'échelle des fournisseurs cloud avec notre CA. Cette dernière fonctionne à l'intérieur du cluster Kubernetes, tandis que le mécanisme du fournisseur cloud fonctionne sur la base de la distribution des nœuds. Il ne sait pas ce qui se passe avec vos pods ou applications. Ces systèmes fonctionnent en parallèle.
Comment gérer la mise à l'échelle dans Kubernetes
- Kubernetes est un outil de gestion des ressources et d'orchestration. Les opérations de gestion des pods et des ressources du cluster sont une étape clé dans la maîtrise de Kubernetes.
- Comprenez la logique de mise à l'échelle des pods en tenant compte de HPA et de VPA.
- CA doit être utilisé uniquement si vous comprenez bien les besoins de vos pods et conteneurs.
- Pour une configuration optimale du cluster, il est nécessaire de comprendre comment les différents systèmes de mise à l'échelle fonctionnent ensemble.
- Lorsque vous évaluez le temps de mise à l'échelle, gardez à l'esprit les meilleurs et pires scénarios.
Source : habr.com
