

L'année approchait de son terme, et les enfants de tout le pays avaient déjà envoyé leurs lettres au Père Noël ou formulé leurs souhaits de cadeaux. Le principal acteur chargé de les réaliser, l'un des grands détaillants, se préparait au sommet des ventes. En décembre, la charge de travail de son centre de données augmentait plusieurs fois. Par conséquent, l'entreprise a décidé de moderniser le data center et de mettre en service plusieurs dizaines de nouveaux serveurs pour remplacer les équipements dont la durée de vie touchait à sa fin. C'est ici que l'introduction se termine, sur fond de flocons de neige, pour céder la place à un véritable thriller.
Les équipements sont arrivés sur le site plusieurs mois avant le pic des ventes. Le service d'exploitation sait bien sûr comment et quoi configurer sur les serveurs pour les mettre en environnement de production. Mais nous devions automatiser cela et éviter le facteur humain. De plus, les serveurs remplaçaient, avant la migration, un ensemble de systèmes SAP, essentiels pour l'entreprise.
Le lancement des nouveaux serveurs était strictement lié à une date butoir. Et le déplacer aurait mis en péril la livraison d'un milliard de cadeaux et la migration des systèmes. Même l'équipe composée de Santa Claus et du Père Noël n'aurais pas pu modifier la date — la migration du système SAP pour la gestion de l'entrepôt ne peut se faire qu'une fois par an. Du 31 décembre au 1er janvier, d'immenses entrepôts du détaillant, d'une superficie totale équivalente à 20 terrains de football, arrêtent leur activité pendant 15 heures. Et c'est la seule fenêtre de temps pour le transfert du système. Nous ne pouvions pas nous permettre d'erreur dans le lancement des serveurs.
Je précise d'emblée : mon récit reflète les outils et le processus de gestion de configurations utilisés par notre équipe.
Le système de gestion des configurations se compose de plusieurs niveaux. Le composant clé est le système CMS. Une absence d'un des niveaux en fonctionnement industriel entraînerait inévitablement des résultats désagréables.
Gestion de l'installation du système d'exploitation
Le premier niveau est le système de gestion de l'installation des systèmes d'exploitation sur des serveurs physiques et virtuels. Il crée des configurations de base du système d'exploitation, éliminant ainsi le facteur humain.
Avec ce système, nous obtenions des exemplaires standards et adaptés à une automatisation ultérieure des serveurs avec un système d'exploitation. Lors de la « dispersion », ils recevaient un ensemble minimal d'utilisateurs locaux et de clés SSH publiques, ainsi qu'une configuration cohérente du système d'exploitation. Nous pouvions gérer les serveurs de manière garantie via le CMS et étions sûrs qu'il n'y avait pas de surprises « en bas », au niveau du système d'exploitation.
La tâche « maximale » pour le système de gestion des installations est de configurer automatiquement les serveurs depuis le niveau BIOS/Firmware jusqu'au système d'exploitation. Beaucoup de choses ici dépendent du matériel et des tâches de configuration. Pour du matériel hétérogène, on peut envisager . Si tout le matériel provient d'un seul fournisseur, il est souvent plus pratique d'utiliser des outils de gestion prêts à l'emploi (par exemple, HP ILO Amplifier, DELL OpenManage, etc.).
Pour l'installation du système d'exploitation sur des serveurs physiques, nous avons utilisé le bien connu Cobbler, qui définit un ensemble de profils d'installation convenus avec le service d'exploitation. Lors de l'ajout d'un nouveau serveur à l'infrastructure, l'ingénieur associât l'adresse MAC du serveur au profil requis dans Cobbler. Lors du premier démarrage en réseau, le serveur recevait une adresse temporaire et un nouveau système d'exploitation. Ensuite, il était transféré dans le VLAN/IP cible et on continuait à travailler là-bas. Oui, le changement de VLAN prend du temps et nécessite une coordination, mais cela offre une protection supplémentaire contre une installation accidentelle dans l'environnement de production.
Nous créions des serveurs virtuels à partir de modèles préparés avec HashiCorp Packer. La raison était la même : prévenir d'éventuelles erreurs humaines lors de l'installation du système d'exploitation. Cependant, contrairement aux serveurs physiques, Packer permet de ne pas utiliser PXE, le démarrage en réseau et le changement de VLAN. Cela a simplifié et facilité la création de serveurs virtuels.
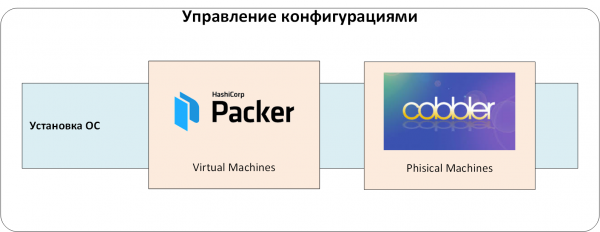
Fig. 1. Gestion de l'installation des systèmes d'exploitation.
Gestion des secrets
Tout système de gestion de configuration contient des données qui doivent être cachées des utilisateurs ordinaires, mais nécessaires à la préparation des systèmes. Il s'agit de mots de passe d'utilisateurs locaux et de comptes de service, de clés de certificats, de tous types de tokens API, etc. On les appelle généralement des « secrets ».
Si l'on ne détermine pas dès le départ où et comment stocker ces secrets, en fonction de la rigueur des exigences de sécurité de l'information, les moyens de stockage probables sont :
- directement dans le code de gestion de la configuration ou dans les fichiers du référentiel;
- dans des outils spécialisés de gestion de configuration (par exemple, Ansible Vault);
- dans des systèmes CI/CD (Jenkins/TeamCity/GitLab/etc.) ou dans des systèmes de gestion de configuration (Ansible Tower/Ansible AWX);
- les secrets peuvent également être transférés par « gestion manuelle ». Par exemple, ils sont publiés à un endroit convenu, puis utilisés par les systèmes de gestion de configuration;
- différentes combinaisons de ce qui précède.
Chaque méthode a ses inconvénients. Le principal est l'absence de politiques d'accès aux secrets : il est impossible ou difficile de déterminer qui peut utiliser tel ou tel secret. Un autre inconvénient est le manque d'audit d'accès et d'un cycle de vie complet. Comment remplacer rapidement, par exemple, une clé publique qui est inscrite dans le code et dans un certain nombre de systèmes associés ?
Nous avons utilisé un stockage centralisé de secrets HashiCorp Vault. Cela nous a permis :
- de stocker les secrets en toute sécurité. Ils sont chiffrés, et même si quelqu'un accède à la base de données du stockage Vault (par exemple, en la restaurant à partir d'une sauvegarde), il ne pourra pas lire les secrets y étant stockés;
- d'organiser des politiques d'accès aux secrets. Les utilisateurs et les applications n'ont accès qu'aux secrets qui leur sont « attribués »;
- de réaliser un audit d'accès aux secrets. Toute action sur les secrets est enregistrée dans le journal d'audit de Vault;
- d'organiser un « cycle de vie » complet des secrets. Ils peuvent être créés, révoqués, avoir une durée de vie définie, etc.
- de s'intégrer facilement à d'autres systèmes nécessitant un accès aux secrets;
- et aussi d'appliquer le chiffrement de bout en bout, des mots de passe à usage unique pour les systèmes d'exploitation et les bases de données, des certificats de centres autorisés, etc.
Nous allons maintenant passer au système central d'authentification et d'autorisation. On aurait pu s'en passer, mais l'administration des utilisateurs dans de nombreux systèmes associés est trop peu triviale. Nous avons configuré l'authentification et l'autorisation via le service LDAP. Sinon, dans Vault, il aurait fallu émettre et suivre en permanence des jetons d'authentification pour les utilisateurs. La suppression et l'ajout d'utilisateurs seraient devenus une quête du genre « ai-je créé/supprimé ce compte partout ? »
Ajoutons un autre niveau à notre système : gestion des secrets et authentification/autorisation centralisées :
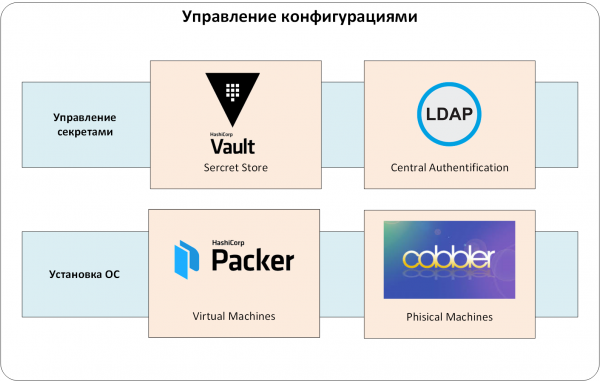
Fig. 2. Gestion des secrets.
Gestion des configurations
Nous avons atteint le cœur — le système CMS. Dans notre cas, c'est un ensemble Ansible et Red Hat Ansible AWX.
Chef, Puppet et SaltStack peuvent également remplacer Ansible. Nous avons choisi Ansible pour plusieurs critères.
- Tout d'abord, sa polyvalence. L'ensemble des modules prêts à l'emploi pour la gestion . Et si cela ne suffit pas, on peut chercher sur GitHub et Galaxy.
- Ensuite, il n'est pas nécessaire d'installer et de maintenir des agents sur le matériel géré, de prouver qu'ils ne perturbent pas la charge et de garantir l'absence de "backdoors".
- Troisièmement, Ansible a une faible barrière à l'entrée. Un ingénieur compétent peut rédiger un playbook fonctionnel dès son premier jour d'utilisation du produit.
Mais Ansible seul n'était pas suffisant dans un environnement industriel. Sinon, nous aurions rencontré de nombreux problèmes avec les restrictions d'accès et l'audit des actions des administrateurs. Comment restreindre l'accès ? Il fallait que chaque département gère (en d'autres termes — exécute des playbooks Ansible) son propre ensemble de serveurs. Comment autoriser l'exécution de playbooks Ansible spécifiques uniquement à certains employés ? Ou comment suivre qui a exécuté un playbook sans créer de multiples comptes utilisateurs locaux sur les serveurs et le matériel géré par Ansible ?
Une grande partie de ces questions est résolue par Red Hat , ou son projet en amont open-source . C'est pourquoi nous l'avons préféré pour notre client.
Et un autre détail sur le portrait de notre système CMS. Le playbook Ansible doit être stocké dans des systèmes de gestion de référentiels de code. Chez nous, c'est .
Ainsi, la gestion des configurations est assurée par l'ensemble Ansible/Ansible AWX/GitLab (voir Fig. 3). Bien sûr, AWX/GitLab sont intégrés à un système d'authentification unique, et le playbook Ansible — à HashiCorp Vault. Les configurations ne passent en environnement de production que par Ansible AWX, où toutes les "règles du jeu" sont définies : qui peut configurer quoi, d'où récupérer le code de gestion des configurations pour le CMS, etc.
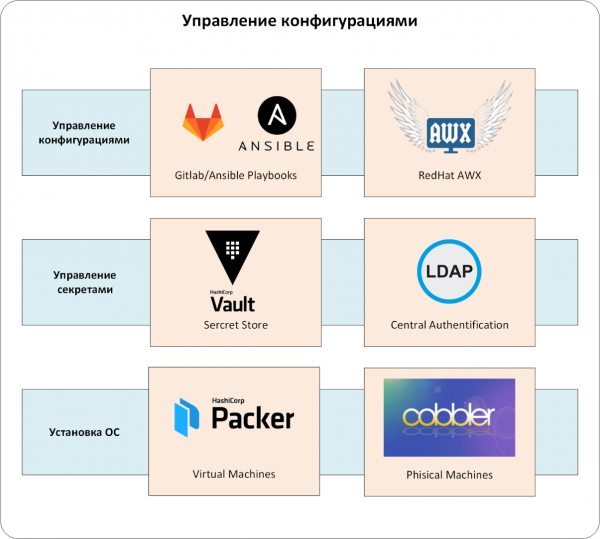
Fig. 3. Gestion des configurations.
Gestion des tests
Notre configuration est présentée sous forme de code. Nous devons donc suivre les mêmes règles que les développeurs de logiciels. Nous devions organiser les processus de développement, de test continu, de livraison et d'application du code de configuration sur les serveurs de production.
Si cela n'est pas fait immédiatement, les rôles écrits pour la configuration cesseraient de supporter et de modifier, ou arrêteraient de se lancer en production. Le remède à cette douleur est connu, et il a fait ses preuves dans ce projet :
- chaque rôle est couvert par des tests modulaires ;
- les tests sont exécutés automatiquement lors de tout changement dans le code qui contrôle les configurations ;
- les modifications dans le code de gestion des configurations ne sont mises en production qu'après avoir réussi tous les tests et la révision du code.
Le développement du code et la gestion des configurations sont devenus plus sereins et prévisibles. Pour organiser des tests continus, nous avons utilisé l'outil GitLab CI/CD, et comme cadre pour organiser les tests, nous avons pris .
À chaque modification du code de gestion des configurations, GitLab CI/CD appelle Molecule :
- cela vérifie la syntaxe du code,
- lève un conteneur Docker,
- applique le code modifié dans le conteneur créé,
- vérifie le rôle pour l'idempotence et exécute les tests pour ce code (la granularité ici est au niveau de rôle ansible, voir Fig. 4).
Nous livrions les configurations dans l'environnement de production à l'aide d'Ansible AWX. Les ingénieurs responsables de l'exploitation appliquaient les modifications de configuration à travers des modèles prédéfinis. AWX demandait automatiquement à chaque application la dernière version du code de la branche master GitLab. Ainsi, nous excluions l'utilisation de code non vérifié ou obsolète dans l'environnement de production. Naturellement, le code n'atteignait la branche master qu'après tests, relecture et approbation.
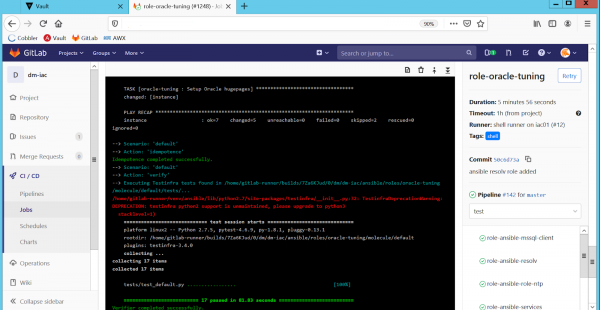
Fig. 4. Test automatique des rôles dans GitLab CI/CD.
Il reste un autre problème lié à l'exploitation des systèmes de production. Dans la vie réelle, il est très difficile d'apporter des modifications à la configuration uniquement via le code CMS. Des situations imprévues surviennent où un ingénieur doit modifier la configuration « ici et maintenant », sans attendre la modification du code, les tests, l'approbation, etc.
En conséquence, en raison des modifications manuelles, il y a des divergences dans la configuration sur un matériel homogène (par exemple, sur des nœuds d'un cluster HA, la configuration des paramètres sysctl est différente). Ou la configuration réelle sur le matériel diffère de celle qui est spécifiée dans le code CMS.
Ainsi, en plus des tests continus, nous vérifions les environnements de production pour détecter les divergences de configuration. Nous avons choisi l'option la plus simple : exécuter le code de configuration CMS en mode « dry run », c'est-à-dire sans appliquer de modifications, mais en signalant toutes les divergences entre la configuration prévue et la configuration réelle. Nous avons mis cela en œuvre grâce à des exécutions régulières de tous les playbooks Ansible avec l'option « --check » sur les serveurs de production. Ansible AWX est toujours responsable de l'exécution et de l'actualité des playbooks (voir Fig. 5) :
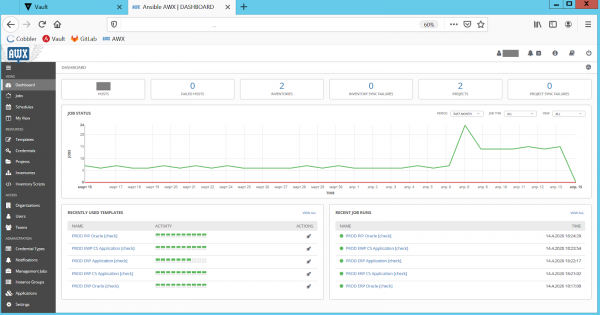
Fig. 5. Vérifications des divergences de configuration dans Ansible AWX.
Après les vérifications, AWX envoie un rapport de divergences aux administrateurs. Ils examinent la configuration problématique, puis la corrigent via des playbooks ajustés. Ainsi, nous maintenons la configuration dans l'environnement de production et le CMS est toujours à jour et synchronisé. Cela élimine les « surprises » désagréables où le code du CMS est appliqué sur des serveurs de « production ».
Nous avons maintenant un niveau de test important, composé d'Ansible AWX/GitLab/Molecule (Fig. 6).
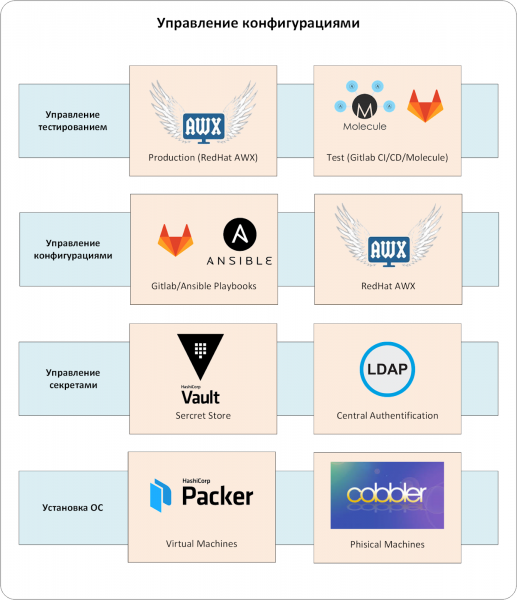
Fig. 6. Gestion des tests.
C'est compliqué ? Je ne conteste pas. Mais ce système de gestion des configurations est une réponse exhaustive à de nombreuses questions liées à l'automatisation de la configuration des serveurs. Désormais, le détaillant a toujours une configuration strictement définie pour ses serveurs standard. Le CMS, contrairement à un ingénieur, n'oubliera pas d'ajouter les paramètres nécessaires, de créer des utilisateurs et d'effectuer des dizaines ou des centaines de configurations requises.
Dans les configurations des serveurs et des environnements, il n'y a plus de « savoirs secrets ». Toutes les particularités nécessaires sont reflétées dans les playbooks. Plus de créativité ou d'instructions vagues : «installe comme un Oracle normal, mais il faut renseigner quelques paramètres sysctl, et ajouter les utilisateurs avec le bon UID. Demande aux gars de l'exploitation, ils savent.».
La capacité à détecter les divergences de configurations et à les corriger à l'avance apporte une tranquillité d'esprit. Sans un système de gestion de configurations, c'est généralement différent. Les problèmes s'accumulent jusqu'à ce qu'un jour, ils « explosent » en production. Ensuite, une analyse est effectuée, les configurations sont vérifiées et corrigées. Et le cycle se répète.
Et bien sûr, nous avons réduit le temps de mise en service des serveurs de plusieurs jours à quelques heures.
Mais dans la nuit de la Saint-Sylvestre, quand les enfants déballaient joyeusement leurs cadeaux et que les adultes formulaient des vœux au son des cloches, nos ingénieurs ont migré le système SAP vers de nouveaux serveurs. Même le Père Noël dirait que les meilleurs miracles sont bien préparés.
P.S. Notre équipe est souvent confrontée à des clients qui souhaitent résoudre de manière aussi simple que possible la gestion des configurations. Idéalement, comme par magie — avec un seul outil. Mais dans la réalité, c'est plus compliqué (oui, encore une fois, les balles en argent n'ont pas été livrées) : il faut créer tout un processus à l'aide des outils pratiques pour l'équipe du client.
Auteur : Sergueï Artemov, architecte de département «Infosystèmes Jet»
Source : habr.com
