

Il y a de fortes chances que personne ne se demande aujourd'hui pourquoi il est nécessaire de collecter les métriques des services. La prochaine étape logique consiste à configurer une alerte sur les métriques collectées, qui vous avertira de toute anomalie dans les données via les canaux de votre choix (email, Slack, Telegram). Dans le service de réservation en ligne d'hôtels, toutes les métriques de nos services sont envoyées dans InfluxDB et affichées dans Grafana, où un système d'alerte de base est également configuré. Pour des tâches telles que 'nous devons calculer quelque chose et comparer', nous utilisons Kapacitor.
Kapacitor est une partie de la stack TICK, capable de traiter les métriques d'InfluxDB. Il peut relier plusieurs dimensions entre elles (join), en calculer quelque chose d'utile à partir des données obtenues, enregistrer le résultat dans InfluxDB, et envoyer une alerte via Slack/Twitter/email.
L'ensemble de la stack dispose d'une documentation impressionnante et détaillée, , mais il y aura toujours des éléments utiles qui ne sont pas explicitement mentionnés dans les manuels. Dans cet article, j'ai décidé de rassembler une série de conseils utiles et subtils (la syntaxe principale de TICKscript est décrite ) et de montrer comment les appliquer, à travers l'exemple de l'une de nos tâches.
Allons-y !
float & int, erreurs de calcul
C'est un problème absolument courant, résolu par un cast :
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Utilisation de default()
Si le tag/champ n'est pas rempli, cela entraînera des erreurs dans les calculs :
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill dans join (inner vs outer)
Par défaut, join rejettera les points pour lesquels il n'y a pas de données (inner).
Avec fill('null'), cela exécutera un outer join, après quoi il faudra faire default() et remplir les valeurs vides :
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Cependant, il y a une nuance. Si, dans l'exemple ci-dessus, l'une des séries (res1 ou res2) est vide, la série finale (data) sera également vide. Il y a plusieurs tickets à ce sujet sur GitHub (, , ) - nous attendons des corrections et en souffrons un peu.
Utilisation des conditions dans les calculs (if dans lambda)
|eval(lambda: if("value" > 0, true, false)
Les cinq dernières minutes du pipeline pour la période
Par exemple, vous devez comparer les valeurs des cinq dernières minutes avec celles de la semaine précédente. Vous pouvez prendre deux lots de données avec deux batchs distincts ou extraire une partie des données d'une période plus longue :
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Une alternative pour les dernières cinq minutes pourrait être l'utilisation du nœud BarrierNode, qui coupe les données plus tôt que prévu :
|barrière()
        .période(5m)
Exemples d'utilisation des modèles Go dans le message
Les modèles sont conformes au format du paquet , voici quelques tâches courantes.
if-else
Mettons de l'ordre, sans trop déclencher les gens avec du texte :
|alerte()
    ...
    .message(
        '{{ if eq .Level "OK" }}Tout va bien maintenant{{ else }}Chef, tout est cassé{{end}}'
    )
Deux chiffres après la virgule dans le message
Améliorons la lisibilité du message :
|alerte()
    ...
    .message(
        'la valeur actuelle est {{ index .Fields "value" | printf "%0.2f" }}'
    )
Développement des variables dans le message
Affichons plus d'informations dans le message pour répondre à la question «Pourquoi ça crie ?»
var warnAlert = 10
  |alerte()
    ...
    .message(
       'Aujourd'hui, la valeur est inférieure à '+string(warnAlert)+'%'
    )
Identifiant unique de l'alerte
C'est nécessaire lorsqu'il y a plus d'un groupe de données, sinon un seul alerte sera généré :
|alerte()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Gestionnaires personnalisés
Dans une longue liste de gestionnaires, il y a exec, qui permet d'exécuter votre propre script avec les paramètres transmis (stdin) - c'est de la créativité pure !
L'un de nos personnalisés est un petit script Python pour envoyer des notifications sur Slack.
Au départ, nous voulions envoyer dans le message une image de Grafana, protégée par authentification. Ensuite, nous avons voulu écrire OK dans le fil du précédent alerte du même groupe, et non dans un message séparé. Un peu plus tard, nous avons ajouté la question de la plus fréquente erreur au cours des X dernières minutes.
Un autre sujet – la connexion avec d'autres services et toute action initiée par l'alerte (uniquement si votre surveillance fonctionne suffisamment bien).
Exemple de description d'un gestionnaire, où slack_handler.py est notre script maison :
sujet : slack_graph
id : slack_graph.alert
match : level() != INFO ET changed() == TRUE
kind : exec
options:
  prog : \/sbin\/slack_handler.py
  args : ["-c", "CHANNELID", "--graph", "--search"]
Comment déboguer ?
Option avec sortie dans le journal
|log()
      .level("error")
      .prefix("quelque chose")
Voir (cli): kapacitor -url :9092 logs lvl=error
Option avec httpOut
Montre les données dans le pipeline actuel :
|httpOut('quelque chose')
Voir (get) : :9092\/kapacitor\/v1\/tasks\/task_name\/quelque chose
Schéma d'exécution
- Chaque tâche retourne un arbre d'exécution avec des chiffres utiles dans le format .
- Prenons le bloc .
- Insérons dans le visualiseur, .
Où d'autre peut-on obtenir le timestamp dans InfluxDB lors de l'enregistrement inverse
timestamp dans influxdb lors de l'écriture inverse
Par exemple, nous configurons une alerte pour le nombre de requêtes par heure (groupBy(1h)) et nous souhaitons enregistrer l'alerte sur influxdb (pour afficher joliment le fait qu'il y a un problème sur le graphique dans grafana).
influxDBOut() enregistrera à timestamp la valeur time de l'alerte, par conséquent, le point sur le graphique sera enregistré plus tôt / plus tard que l'alerte reçue.
Lorsque la précision est requise : nous contournons ce problème en appelant un handler personnalisé, qui enregistrera les données dans influxdb avec le timestamp actuel.
docker, construction et déploiement
Lors du démarrage, kapacitor peut charger des tâches, des modèles et des handlers à partir du répertoire spécifié dans la configuration, dans le bloc [load].
Pour créer correctement une tâche, les éléments suivants sont nécessaires :
- Nom du fichier - se déploie en id / nom du script
- Type - stream / batch
- dbrp - mot-clé pour indiquer dans quelle base + quelle politique le script fonctionne (dbrp «supplier».«autogen»)
S'il n'y a pas de ligne avec dbrp dans une tâche batch, tout le service refusera de se lancer et le signalera honnêtement dans le journal.
Dans chronograf, en revanche, cette ligne ne doit pas être présente, car elle n'est pas acceptée par l'interface et renvoie une erreur.
Hack lors de la construction du conteneur : le Dockerfile échoue avec -1 s'il y a des lignes avec //.+dbrp, ce qui permettra de comprendre immédiatement la raison de l'échec lors de la construction.
join un à plusieurs
Tâche exemple : il faut prendre le 95e centile du temps de fonctionnement du service sur une semaine, comparer chaque minute des 10 dernières avec cette valeur.
Il n'est pas possible de faire un join un à plusieurs, last / mean / median par groupe de points transforme le nœud en stream, renvoyant l'erreur «cannot add child mismatched edges: batch -> stream».
Le résultat du batch, en tant que variable dans l'expression lambda, n'est pas non plus substitué.
Il existe une option pour enregistrer les chiffres nécessaires du premier batch dans un fichier via udf et charger ce fichier via sideload.
Que résolvions-nous avec cela ?
Nous avons environ 100 fournisseurs d'hôtels, chacun d'eux pouvant avoir plusieurs connexions, que nous appellerons des canaux. Il y a environ 300 canaux, chacun pouvant se déconnecter. Parmi toutes les métriques enregistrées, nous allons surveiller le taux d'erreurs (requests et errors).
Pourquoi pas grafana ?
Les alertes sur les erreurs configurées dans grafana ont plusieurs inconvénients. Certains sont critiques, d'autres peuvent être négligés, selon la situation.
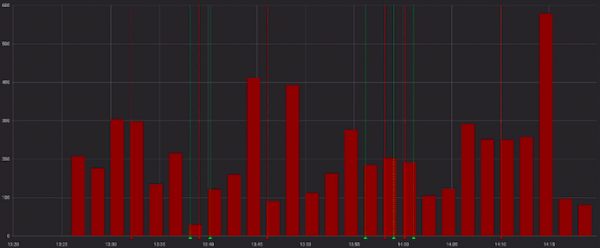
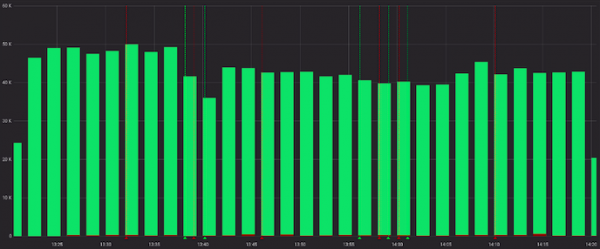
Grafana ne sait pas faire de calculs entre les mesures + alerting, et nous avons besoin du taux (requests-errors) / requests.
Les erreurs semblent sévères :
Et moins sévères, si l'on regarde avec les requêtes réussies :
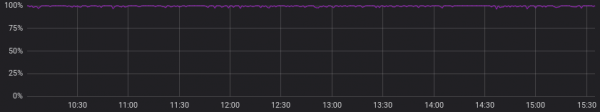
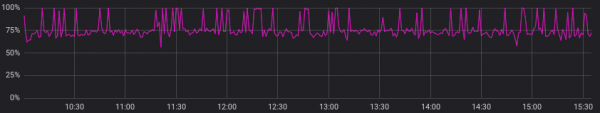
D'accord, nous pouvons estimer le taux dans le service avant Grafana, et dans certains cas cela conviendra. Mais pas dans notre cas, car pour chaque canal, le rapport considéré comme "normal" est différent, et les alertes fonctionnent sur des valeurs statiques (nous cherchons visuellement, et nous modifions si les alertes sont fréquentes).
Voici des exemples de "normal" pour différents canaux :
Écartons le point précédent et supposons que la "normalité" est similaire chez tous les fournisseurs. Tout va bien maintenant, pouvons-nous nous en sortir avec les alertes dans Grafana ?
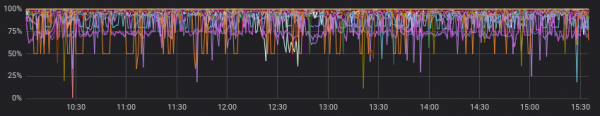
Nous le pouvons, mais nous ne le souhaitons pas vraiment, car il faut choisir l'une des options :
a) créer de nombreux graphiques pour chaque canal séparément (et en supporter la maintenance péniblement)
b) garder un seul graphique avec tous les canaux (et se perdre dans des lignes colorées et des alertes configurées)
Comment cela a-t-il été fait ?
Encore une fois, la documentation propose un bon exemple de départ (), que vous pouvez consulter ou utiliser comme base pour des tâches similaires.
Voici ce que nous avons finalement réalisé :
- jointure de deux séries sur plusieurs heures, regroupement par canaux ;
- nous remplissons les séries par groupes en cas d'absence de données ;
- nous comparons la médiane des 10 dernières minutes avec les données précédentes ;
- nous crions si quelque chose est détecté ;
- nous écrivons les taux calculés et les alertes survenues dans InfluxDB ;
- nous envoyons un message utile dans Slack.
À mon avis, nous avons réussi à obtenir tout ce que nous espérions de façon très esthétique (voire un peu plus avec les gestionnaires personnalisés).
Vous pouvez consulter sur github.com et du script obtenu.
Exemple du code obtenu :
dbrp "fournisseur"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "fournisseur"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "fournisseur"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'fournisseur')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'fournisseur')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // remplissons les valeurs avec des zéros si elles n'étaient pas présentes
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // si dans lambda : calculons le taux, seulement en cas d'erreurs
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// écrivons les valeurs calculées dans influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// sélectionnons les données des 10 dernières minutes, calculons la médiane
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // rassemblons dans le message le lien vers le graphique du tableau de bord grafana
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} rapport err/requêtes ({{ index .Tags "fournisseur" }})
{{ if eq .Level "OK" }}C'est bon maintenant{{ else }}
'+string(todayPeriod)+' la médiane est {{ index .Fields "today.median" | printf "%0.2f" }}%, par rapport à l'ancienne période '+string(period)+' qui est {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "fournisseur" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" est dupliqué comme "value", écrivant aussi dans influx les autres champs de l'alerte (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Et quel est le résultat ?
Kapacitor excelle dans la surveillance et l'alerte avec de nombreuses regroupements, réalise des calculs supplémentaires sur des métriques déjà enregistrées, effectue des actions personnalisées et exécute des scripts (udf).
Le seuil d'entrée n'est pas très élevé – essayez-le si Grafana ou d'autres outils ne répondent pas entièrement à vos attentes.
Source : habr.com
