

Bonjour, dans les articles précédents, nous avons fait connaissance avec le fonctionnement de l'ELK Stack. Maintenant, discutons des possibilités que les spécialistes en sécurité de l'information peuvent réaliser avec ces systèmes. Quels logs peuvent et doivent être générés dans Elasticsearch ? Examinons quelles statistiques peuvent être obtenues en configurant des tableaux de bord et s'il y a un véritable bénéfice à cela. Comment l'automatisation des processus de sécurité de l'information peut-elle être mise en œuvre en utilisant la stack ELK ? Composons l'architecture de fonctionnement du système. En résumé, la mise en œuvre de toutes les fonctionnalités est une tâche très complexe, c'est pourquoi nous avons créé un nom distinct pour la solution — TS Total Sight.
Actuellement, les solutions qui consolident et analysent les incidents de sécurité de l'information dans un lieu logique gagnent en popularité, permettant ainsi au spécialiste d'obtenir des statistiques et un plan d'action pour améliorer l'état de la sécurité de l'information dans l'organisation. C'est l'objectif que nous nous sommes fixé avec l'utilisation de la stack ELK, en extrayant quatre sections principales de la fonctionnalité :
- Statistiques et visualisation ;
- Détection des incidents de sécurité de l'information ;
- Priorisation des incidents ;
- Automatisation des processus de sécurité de l'information.
Examinons plus en détail chacune de ces sections.
Détection des incidents de sécurité de l'information
La tâche principale de l'utilisation d'Elasticsearch dans notre cas est de ne collecter que les incidents de sécurité de l'information. Nous pouvons collecter des incidents de sécurité avec n'importe quel outil de protection, tant qu'il prend en charge des modes de transmission de logs, le plus courant étant syslog ou la sauvegarde dans un fichier via SCP.
Voici quelques exemples standards d'outils de protection à partir desquels nous devrions configurer la transmission des logs :
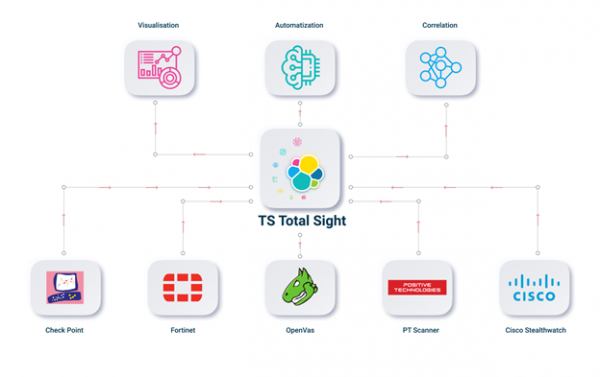
- Tout outil NGFW (Check Point, Fortinet) ;
- Tout scanner de vulnérabilités (PT Scanner, OpenVas) ;
- Web Application Firewall (PT AF) ;
- Analyseurs netflow (Flowmon, Cisco StealthWatch) ;
- Serveur AD.
Après avoir configuré l'envoi de logs et les fichiers de configuration dans Logstash, nous pouvons corréler et comparer avec les incidents provenant de divers outils de sécurité. Il est pratique d'utiliser des indices où nous stockerons tous les incidents liés à un appareil spécifique. En d'autres termes, un indice correspond à tous les incidents d'un même appareil. Cette répartition peut être réalisée de deux manières.
La première option C'est la configuration de Logstash. Pour ce faire, il est nécessaire de dupliquer le journal selon certains champs dans une unité distincte avec un type différent. Puis, par la suite, utiliser ce type. Dans l'exemple, les journaux sont clonés en fonction du blade IPS du pare-feu Check Point.
filter {
    if [product] == "SmartDefense" {
        clone {
	    clones => ["CloneSmartDefense"]
	    add_field => {"system" => "checkpoint"}
	}
    }
}
Pour sauvegarder dans un index distinct ces événements en fonction des champs de journaux, par exemple, celui du Destination IP de la signature d'attaque, on peut utiliser une structure similaire :
output {
    if [type] == "CloneSmartDefense"{
    {
         elasticsearch {
    	 hosts => [",:9200"]
    	 index => "smartdefense-%{dst}"
    	 user => "admin"
    	 password => "password"
  	 }
    }
}
Ainsi, il est possible de sauvegarder dans un index tous les incidents, par exemple, par adresse IP ou par nom de domaine de la machine. Dans ce cas, nous sauvegardons dans l'index «smartdefense-%{dst}», par adresse IP selon la valeur de la signature.
Cependant, les différents produits auront des champs de journal différents, ce qui entraînera du désordre et un usage excessif de la mémoire. Il faudra donc soit remplacer soigneusement dans les paramètres de configuration de Logstash les champs par ceux préalablement définis, qui seront identiques pour tous les types d'incidents, ce qui est également une tâche complexe.
La deuxième option de mise en œuvre — consiste à écrire un script ou un processus qui interrogera en temps réel la base Elasticsearch, extraira les incidents nécessaires et les sauvegardera dans un nouvel index. Cela représente une tâche difficile, mais permet de travailler avec les journaux comme on le souhaite et de corréler directement avec les incidents d'autres outils de sécurité. Cette option permet d'organiser le travail avec les journaux de manière maximisée pour votre cas avec une flexibilité maximale, mais il y a un problème pour trouver un spécialiste capable de mettre cela en œuvre.
Et bien sûr, la question la plus importante, qu'est-ce qui peut être corrélé et détecté?
Il peut y avoir plusieurs options, cela dépend des outils de sécurité utilisés dans votre infrastructure, voici quelques exemples :
- La solution la plus évidente et, à mon avis, la plus intéressante pour ceux qui disposent d'une solution NGFW et d'un scanner de vulnérabilités. Il s'agit de comparer les journaux IPS et les résultats de scan des vulnérabilités. Si une attaque a été détectée (mais pas bloquée) par le système IPS, et que cette vulnérabilité n'est pas corrigée sur la machine cible selon les résultats du scan, il est nécessaire de tirer la sonnette d'alarme, car il y a une forte probabilité que la vulnérabilité ait été exploitée.
- De nombreuses tentatives de connexion depuis une machine vers différents endroits peuvent signaler une activité malveillante.
- Téléchargement de fichiers malveillants par l'utilisateur en raison de visites sur un grand nombre de sites potentiellement dangereux.
Statistiques et visualisation
L'utilisation la plus évidente et la plus compréhensible de l'ELK Stack est le stockage et la visualisation des journaux. il a été montré comment faire entrer des journaux provenant de divers dispositifs en utilisant Logstash. Une fois que les journaux sont envoyés à Elasticsearch, il est possible de configurer des tableaux de bord, dont nous avons également parlé , avec les informations et statistiques nécessaires grâce à la visualisation.
Exemples :
- Tableau de bord sur les événements de Prévention des Menaces avec les événements les plus critiques. Ici, vous pouvez refléter quelles signatures IPS ont été détectées et d'où elles proviennent géographiquement.
- Tableau de bord sur l'utilisation des applications les plus critiques, où des informations pourraient être divulguées.
- Résultats de scan de n'importe quel scanner de sécurité.
- Journaux Active Directory par utilisateur.
- Tableau de bord sur les connexions VPN.
Dans ce cas, si les tableaux de bord sont configurés pour se mettre à jour toutes les quelques secondes, il est possible d'obtenir un système assez pratique pour surveiller les événements en temps réel, qui peut ensuite être utilisé pour une réponse rapide aux incidents de sécurité informatique, en configurant les tableaux de bord sur un écran distinct.
Priorisation des incidents
Dans le cadre d'une grande infrastructure, le nombre d'incidents peut être écrasant, et les spécialistes peuvent ne pas avoir le temps de traiter tous les incidents à temps. Dans ce cas, il est nécessaire de privilégier uniquement ceux qui présentent un plus grand risque. Par conséquent, le système doit prioriser les incidents en fonction de leur dangerosité par rapport à votre infrastructure. Il est conseillé de configurer des alertes par e-mail ou sur Telegram pour ces événements. La priorisation peut être réalisée par les moyens standard de Kibana, en paramétrant la visualisation. En revanche, gérer les alertes est plus compliqué, car par défaut cette fonctionnalité n'est pas incluse dans la version de base d'Elasticsearch, mais seulement dans la version payante. Il faut donc soit acheter la version payante, soit développer un processus qui notifiera en temps réel les spécialistes par e-mail ou sur Telegram.
Automatisation des processus de sécurité de l'information
Et l'un des aspects les plus intéressants est l'automatisation des actions sur les incidents de sécurité de l'information. Auparavant, nous avions mis en place cette fonctionnalité pour Splunk; vous pouvez en lire plus à ce sujet dans cette . L'idée principale est que la politique IPS n'est jamais vérifiée ni optimisée, alors qu'elle constitue dans certains cas une partie essentielle des processus de sécurité de l'information. Par exemple, un an après la mise en œuvre du NGFW et sans optimisation de l'IPS, vous accumulerez un grand nombre de signatures en mode Détection qui ne seront pas bloquées, ce qui réduira considérablement l'état de la sécurité de l'information dans l'organisation. Voici quelques exemples de ce qui peut être automatisé :
- Changer l'état de la signature IPS de Détection à Prévention. Si les signatures critiques ne sont pas bloquées par la Prévention, c'est inquiétant et il s'agit d'une faille sérieuse dans le système de protection. Nous modifions l'action pour ces signatures. Il est possible de réaliser cette fonctionnalité si le dispositif NGFW possède des fonctionnalités REST API. Cela nécessite des compétences en programmation, car il faut extraire les informations nécessaires d'Elasticsearch et effectuer des requêtes API sur le serveur de gestion du NGFW.
- Si un grand nombre de signatures ont été détectées ou bloquées à partir d'une même adresse IP dans le trafic réseau, il est judicieux de bloquer temporairement cette adresse IP dans la politique du pare-feu. La mise en œuvre consiste également à utiliser REST API.
- Lancer une vérification de l'hôte avec un scanner de vulnérabilités si cet hôte génère un grand nombre de signatures dans le système IPS ou d'autres outils de sécurité. Si c'est OpenVas, on peut écrire un script qui se connecte par SSH au scanner de sécurité et lance le scan.
TS Total Sight
Dans l'ensemble, la mise en œuvre de toutes les fonctionnalités représente une tâche très complexe et lourde. Sans compétences en programmation, il est possible de configurer une fonctionnalité minimale, ce qui peut suffire pour une utilisation en production. Mais si vous êtes intéressé par toutes les fonctionnalités, vous pouvez jeter un œil à TS Total Sight. Vous pouvez en savoir plus sur notre . En conséquence, l'ensemble du schéma de travail et de l'architecture ressemblera à cela :
Conclusion
Nous avons examiné ce qui peut être réalisé en utilisant l'ELK Stack. Dans les prochains articles, nous examinerons plus en détail les fonctionnalités de TS Total Sight !
Alors restez à l'écoute pour les mises à jour (, , , ), .
Source : habr.com
