

Que ressentiriez-vous si, un bel après-midi d'été, le centre de données avec votre équipement ressemblait à ça ?
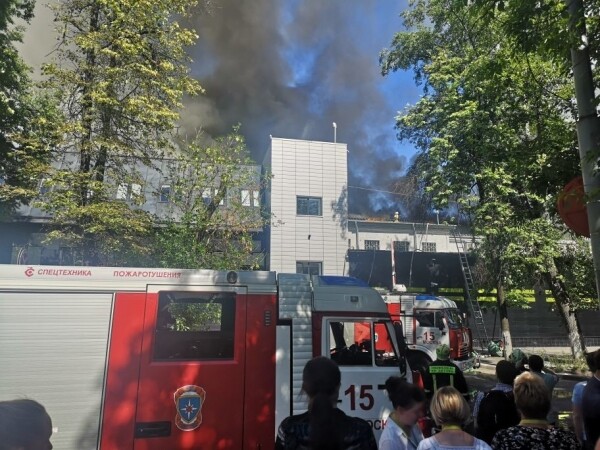
Bonjour à tous ! Je m'appelle Dmitry Samsonov, je suis administrateur système principal chez «». Sur la photo se trouve l'un des quatre centres de données où notre équipement, servant notre projet, est installé. Derrière ces murs se trouvent environ 4 000 unités de matériel : serveurs, systèmes de stockage de données, équipements réseau, etc. — presque ⅓ de tout notre équipement.
La majorité des serveurs fonctionnent sous Linux. Il y a aussi quelques dizaines de serveurs sous Windows (MS SQL) — un héritage dont nous nous séparons progressivement depuis de nombreuses années.
Ainsi, le 5 juin 2019 à 14h35, les ingénieurs de l'un de nos centres de données ont signalé une alarme incendie.
Négation
14h45. De petits incidents de fumée dans les centres de données se produisent plus souvent qu'il n'y paraît. Les indicateurs à l'intérieur des salles étaient normaux, donc notre première réaction a été relativement calme : nous avons imposé une interdiction de travaux sur la production, c’est-à-dire sur tout changement de configuration, le déploiement de nouvelles versions, etc., sauf pour les travaux liés à la réparation de quoi que ce soit.
Colère
Avez-vous déjà essayé de demander aux pompiers où exactement sur le toit s'est produit l'incendie, ou d'aller vous-même sur le toit en feu pour évaluer la situation ? Quel sera le niveau de confiance dans l'information reçue à travers cinq personnes ?
14:50. Des informations ont été reçues indiquant que le feu se rapproche du système de refroidissement. Mais atteindra-t-il ? L'administrateur système de garde dirige le trafic externe depuis les fronts de ce centre de données.
Actuellement, tous nos services sont répliqués dans trois centres de données, et un équilibrage au niveau DNS permet de retirer les adresses d'un centre de données du DNS, protégeant ainsi les utilisateurs de problèmes d'accès potentiels aux services. En cas de problème sur un centre de données, il est automatiquement retiré de la rotation. Vous pouvez en lire plus ici :
Pour l'instant, l'incendie ne nous a pas affectés — ni les utilisateurs ni l'équipement n'ont été touchés. Est-ce une urgence ? La première partie du document « Plan d'action en cas d'urgence » définit le terme « urgence » et se termine par :
«S'il y a des doutes, s'il s'agit d'une urgence ou non, alors c'est une urgence !»
14:53. Un coordinateur d'urgence est désigné.
Le coordinateur est la personne qui supervise la communication entre tous les participants, évalue l'ampleur de l'accident, utilise le « Plan d'action d'urgence », fait appel au personnel nécessaire, supervise l'achèvement des réparations, et, surtout, délègue toutes les tâches. En d'autres termes, c'est la personne qui gère tout le processus de liquidation de l'accident.
Négociation
15:01. Nous commençons à éteindre les serveurs qui ne sont pas liés à la production.
15:03. Nous éteignons correctement tous les services réservés.
Cela inclut non seulement les avant-postes (auxquels les utilisateurs n'accèdent déjà plus à ce stade) et leurs services auxiliaires (logique métier, caches, etc.), mais aussi diverses bases de données avec un facteur de réplication de 2 ou plus (, , , etc.).
15:06. Nous avons reçu l'information qu'un incendie menace l'une des salles du centre de données. Dans cette salle, nous n'avons pas d'équipement, mais le fait que le feu puisse se propager du toit aux salles change considérablement la situation.
(Il s'est avéré plus tard qu'il n'y avait pas de menace physique pour la salle, car elle était hermétiquement isolée du toit. La menace ne concernait que le système de refroidissement de cette salle.)
15:07. Nous autorisons l'exécution des commandes sur les serveurs en mode accéléré sans vérifications supplémentaires ().
15:08. La température dans les salles est normale.
15:12. Une augmentation de la température a été enregistrée dans les salles.
15:13. Plus de la moitié des serveurs dans le centre de données sont éteints. Nous continuons.
15:16. Une décision a été prise d'éteindre tout l'équipement.
15:21. Nous commençons à couper l'alimentation des serveurs sans état sans éteindre correctement l'application et le système d'exploitation.
15:23. Un groupe est désigné pour gérer MS SQL (ils sont peu nombreux, la dépendance des services à leur égard n'est pas grande, mais la procédure de restauration de la fonctionnalité prend plus de temps et est plus complexe que, par exemple, celle de Cassandra).
Dépression
15:25. Nous avons reçu des informations sur la coupure de l'alimentation dans quatre salles sur 16 (n°6, 7, 8, 9). Nos équipements se trouvent dans les salles 7 et 8. Nous n'avons pas encore d'informations sur deux de nos salles (n°1 et 3).
En général, lors des incendies, l'alimentation électrique est immédiatement coupée, mais dans ce cas, grâce au travail coordonné des pompiers et du personnel technique du centre de données, elle n'a pas été coupée partout et immédiatement, mais selon les besoins.
(Il a été découvert plus tard que l'alimentation dans les salles 8 et 9 n'avait pas été coupée.)
15:28. Nous commençons à déployer des bases MS SQL à partir des sauvegardes dans d'autres centres de données.
Combien de temps cela va-t-il prendre ? La bande passante du réseau suffira-t-elle sur tout le trajet ?
15:37. Une coupure de certaines sections du réseau a été signalée.
La gestion et le réseau de production sont physiquement isolés l'un de l'autre. Si le réseau de production est accessible, vous pouvez vous connecter au serveur, arrêter l'application et éteindre l'OS. Si ce n'est pas le cas, vous pouvez accéder via IPMI, arrêter l'application et éteindre l'OS. Si aucun des réseaux n'est disponible, vous ne pourrez rien faire. "Merci, capitaine !", pensez-vous.
« Et d'ailleurs, ça fait pas mal de bruit, » pensez-vous peut-être aussi.
Le problème, c'est que les serveurs génèrent une énorme quantité de chaleur même sans incendie. Plus précisément, lorsqu'il y a du refroidissement, ils génèrent de la chaleur, et quand il n'y en a pas, ils créent un enfer atroce qui, dans le meilleur des cas, fera fondre une partie de l'équipement et éteindra l'autre, et dans le pire des cas... causera un incendie dans la salle, ce qui détruira tout presque inévitablement.
15:39. Nous enregistrons des problèmes avec la base conf.
La base conf est le backend du service éponyme, utilisé par toutes les applications de production pour modifier dynamiquement les paramètres. Sans cette base, nous ne pouvons pas gérer le fonctionnement du portail, mais le portail peut néanmoins fonctionner.
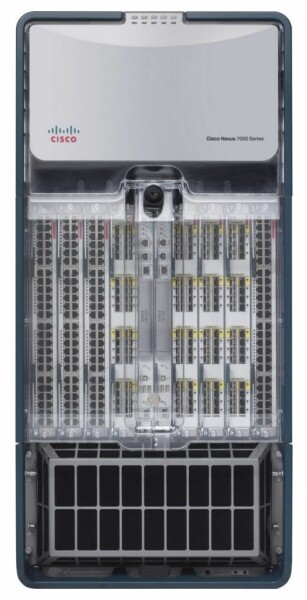
15:41. Les capteurs de température sur l'équipement réseau Core enregistrent des valeurs proches du seuil critique. C'est une boîte qui occupe tout un rack et qui assure le fonctionnement de tous les réseaux à l'intérieur du centre de données.
15:42. Le tracker de problèmes et le wiki ne sont pas accessibles, nous passons au mode de secours.
Ce n'est pas la production, mais en cas d'accident, l'accessibilité de toute base de connaissances peut être critique.
15:50. Un des systèmes de monitorage s'est déconnecté.
Il y en a plusieurs, et elles répondent à différents aspects du fonctionnement des services. Certaines d'entre elles sont configurées pour fonctionner de manière autonome à l'intérieur de chaque centre de données (c'est-à-dire qu'elles ne surveillent que leur propre centre de données), d'autres se composent de composants distribués qui passent sans problème la perte de n'importe quel centre de données.
Dans ce cas, le , qui fonctionne en mode master-standby. Nous avons basculé sur le standby.
Acceptation
15:51. Nous avons éteint tous les serveurs via IPMI sans arrêt correct, sauf pour MS SQL.
Êtes-vous prêts pour la gestion de masse des serveurs via IPMI en cas de besoin ?
C'est le moment où la sauvegarde de l'équipement dans le data center est terminée. Tout ce qui pouvait être fait a été fait. Certains collègues peuvent se reposer.
16:13. Des informations sont parvenues indiquant que des tubes de frigidaire des climatiseurs sur le toit ont éclaté - cela retardera le lancement du data center après l'extinction de l'incendie.
16:19. Selon les données reçues du personnel technique du data center, l'augmentation de la température dans les salles a cessé.
17:10. Le fonctionnement de la base conf a été rétabli. Nous pouvons maintenant modifier les paramètres des applications.
Pourquoi est-ce si important, si tout est tolérant aux pannes et fonctionne même sans un data center ?
Tout d'abord, tout n'est pas tolérant aux pannes. Il existe divers services secondaires qui ne survivent pas encore assez bien à la panne du data center, ainsi que des bases en mode master-standby. La possibilité de gérer les paramètres permet de faire tout le nécessaire pour minimiser les conséquences d'une panne pour les utilisateurs, même dans des conditions difficiles.
Deuxièmement, il est devenu clair que le travail du data center ne sera pas entièrement rétabli dans les heures à venir, il était donc nécessaire de prendre des mesures pour que l'indisponibilité prolongée des répliques ne conduise pas à des problèmes supplémentaires tels que le débordement des disques dans les autres data centers.
17:29. L'heure de la pizza ! Nous avons des gens qui travaillent, pas des robots.
Réhabilitation
18:02. La température dans les salles n°8 (la nôtre), 9, 10 et 11 s'est stabilisée. Dans l'une de celles qui restent éteintes (n°7), se trouve notre équipement, et la température continue d'augmenter.
18:31. Le feu vert a été donné pour le démarrage de l'équipement dans les salles n°1 et 3 - ces salles n'ont pas été touchées par le feu.
À l'heure actuelle, le démarrage des serveurs dans les salles n°1, 3, et 8 est en cours, en commençant par les plus critiques. La conformité de tous les services en cours d'exécution est vérifiée. Des problèmes persistent avec la salle n°7.
18:44. Le personnel technique du data center a découvert que dans la salle n°7 (où se trouve uniquement notre équipement), de nombreux serveurs ne sont pas éteints. Selon nos données, 26 serveurs restent allumés. Après une vérification supplémentaire, nous découvrons 58 serveurs.
20:18. Le personnel technique du data center souffle de l'air dans la salle sans climatiseurs à travers des conduits d'air mobiles, installés à travers les couloirs.
23:08. Nous avons laissé partir le premier administrateur chez lui. Quelqu'un doit dormir cette nuit pour pouvoir continuer demain. Nous laissons ensuite partir d'autres administrateurs et développeurs.
02:56. Nous avons lancé tout ce qui pouvait être lancé. Nous effectuons un grand contrôle de tous les services avec des tests automatisés.
03:02. La climatisation de la dernière salle, la 7e, a été rétablie.
03:36. Nous avons ouvert les fronts dans le centre de données pour la rotation DNS. À partir de ce moment, le trafic utilisateur commence à arriver.
Nous renvoyons la plupart de l'équipe des administrateurs chez eux. Mais nous en gardons quelques-uns.
Petit FAQ :
Q : Que s'est-il passé entre 18:31 et 02:56 ?
R : Conformément au « Plan d'action en cas d'urgence », nous lançons tous les services, en commençant par les plus importants. Pendant ce temps, le coordinateur dans le chat attribue le service à l'administrateur disponible, qui vérifie si les OS et les applications ont démarré, s'il n'y a pas d'erreurs, si les indicateurs sont normaux. Une fois le lancement terminé, il informe le chat qu'il est libre et reçoit un nouveau service du coordinateur.
Le processus est également ralenti par du matériel défectueux. Même si l'arrêt de l'OS et l'extinction des serveurs se sont bien déroulés, certaines machines ne redémarrent pas à cause de disques, de mémoire ou de châssis soudainement défaillants. En cas de perte d'alimentation, le pourcentage de pannes augmente.
Q : Pourquoi ne peut-on pas simplement tout lancer en même temps, puis réparer ce qui apparaît dans la surveillance ?
R : Tout doit être fait progressivement, car il existe des dépendances entre les services. Et il faut tout vérifier immédiatement, sans attendre la surveillance — car il vaut mieux résoudre les problèmes tout de suite, plutôt que d'attendre qu'ils s'aggravent.
7:40. Le dernier administrateur (coordinateur) est parti se coucher. Les travaux du premier jour sont terminés.
8:09. Les premiers développeurs, ingénieurs dans les centres de données et administrateurs (y compris le nouveau coordinateur) ont commencé les travaux de rétablissement.
09:37. Nous avons commencé à lever la salle n°7 (la dernière).
En parallèle, nous continuons à rétablir ce qui n'a pas été terminé dans les autres salles : remplacement de disques/mémoire/serveurs, réparation de tout ce qui « brûle » dans la surveillance, basculement inverse des rôles dans les schémas master-standby et autres détails, qui sont néanmoins assez nombreux.
17:08. Nous autorisons toutes les opérations normales avec le production.
21:45. Les travaux du deuxième jour sont terminés.
09:45. Aujourd'hui, c'est vendredi. Il y a encore pas mal de petits problèmes en cours de surveillance. Le week-end approche, tout le monde veut se reposer. Nous continuons à réparer massivement tout ce qui peut l'être. Les tâches administratives qui pouvaient être reportées ont été mises de côté. Un nouveau coordinateur.
15:40. Soudain, la moitié de la pile Core de l'équipement réseau dans UN AUTRE centre de données a redémarré. Nous avons retiré les faces de la rotation pour minimiser les risques. Aucun impact pour les utilisateurs. Plus tard, il s'est avéré que c'était un châssis défectueux. Le coordinateur travaille sur la réparation de deux pannes simultanément.
17:17. Le fonctionnement du réseau dans un autre centre de données a été rétabli, tout a été vérifié. Le centre de données a été intégré à la rotation.
18:29. Les travaux du troisième jour et la reprise globale après l'accident sont désormais achevés.
Postface
04.04.2013, « Odnoklassniki » — pendant trois jours, le portail était complètement ou partiellement inaccessible. Pendant toute cette période, plus de 100 personnes de différentes villes et de différentes entreprises (merci encore une fois !), ont réparé à distance et directement dans les centres de données, manuellement et automatiquement, des milliers de serveurs.
Nous en avons tiré des leçons. Pour éviter que cela ne se reproduise, nous avons mené et continuons à mener des travaux étendus.
Quelles sont les principales différences entre cet accident et le 404 ?
- Nous avons mis en place un « Plan d'action en cas d'accident ». Une fois par trimestre, nous organisons des exercices — simuler une situation d'accident que le groupe d'administrateurs (tous à tour de rôle) doit résoudre en utilisant le « Plan d'action en cas d'accident ». Les administrateurs systèmes principaux prennent tour à tour le rôle de coordinateur.
- Chaque trimestre, nous isolons temporairement les centres de données (tous à tour de rôle) sur le réseau LAN et WAN, ce qui permet d'identifier rapidement les goulets d'étranglement.
- Moins de disques défectueux, car nous avons durci les normes : moins d'heures de fonctionnement, des seuils stricts pour S.M.A.R.T.
- Nous avons complètement abandonné BerkeleyDB — une ancienne base de données instable qui prenait beaucoup de temps à récupérer après le redémarrage du serveur.
- Nous avons réduit le nombre de serveurs MS SQL et diminué notre dépendance aux serveurs restants.
- Nous avons notre propre vers lequel nous migrons activement tous les services depuis deux ans. Le cloud simplifie considérablement tout le cycle de travail avec l'application, et en cas d'accident, il offre des outils uniques tels que :
- Arrêt correct de toutes les applications en un clic ;
- Migration simple des applications à partir de serveurs défaillants ;
- Démarrage automatique classé (par ordre de priorité des services) de l'ensemble du centre de données.
L'incident décrit dans cet article a été le plus important depuis le jour de l'incident 404. Bien sûr, tout ne s'est pas déroulé sans accroc. Par exemple, pendant l'indisponibilité du centre de données sinistré, un disque d'un des serveurs d'un autre centre de données a échoué, laissant seulement une des trois répliques accessibles dans le cluster Cassandra, ce qui a empêché 4,2 % des utilisateurs des applications mobiles de se connecter. Cependant, les utilisateurs déjà connectés continuaient à travailler. Au total, plus de 30 problèmes ont été identifiés suite à cet incident - allant de simples bugs à des lacunes dans l'architecture des services.
Mais la principale différence entre l'incident actuel et celui de 404 est que tandis que nous gérions les conséquences de l'incendie, les utilisateurs continuaient à échanger des messages et à passer des appels vidéo sur , jouaient à des jeux, écoutaient de la musique, s'offraient des cadeaux, regardaient des vidéos, des séries et des chaînes de télévision sur , ainsi que diffusaient sur .
Comment se déroulent vos incidents ?
Source : habr.com
