

Une petite introduction
Je pense que nous pourrions accomplir beaucoup plus de choses si l'on nous fournissait des instructions étape par étape qui nous indiquent quoi et comment faire. Je me souviens de moments dans ma vie où je n'ai pas pu commencer une tâche simplement parce que je ne savais pas par où commencer. Peut-être qu'il y a longtemps, tu as vu les mots « Data Science » sur Internet et tu as pensé que c'était un domaine lointain, et que les gens qui s'y adonnent se trouvent ailleurs, dans un autre monde. Mais non, ils sont juste ici. Et peut-être que grâce aux personnes de ce secteur, un article t'est parvenu dans ton fil d'actualités. Il existe de nombreux cours qui t'aideront à maîtriser cet art, et ici, je vais t'aider à faire le premier pas.
Alors, es-tu prêt ? Je te préviens tout de suite, tu devras savoir utiliser Python 3, car c'est ce que j'utiliserai ici. Je te recommande également d'installer Jupyter Notebook à l'avance ou de voir comment utiliser Google Colab.
Première étape
Kaggle est ton précieux allié dans ce domaine. En principe, tu peux t'en passer, mais je parlerai de cela dans un autre article. C'est une plateforme où se déroulent des compétitions en Data Science. Dans chaque compétition à ses débuts, tu vas acquérir une quantité incroyable d'expérience dans la résolution de divers problèmes, le développement et le travail en équipe, ce qui est essentiel aujourd'hui.
Nous allons prendre notre tâche de là-bas. Elle s'appelle comme ceci : « Titanic ». Le défi est le suivant : prédire si chaque personne en particulier va survivre. En gros, le travail d'un data scientist consiste à collecter des données, les traiter, entraîner un modèle, faire des prévisions, etc. Sur Kaggle, nous avons la chance de passer l'étape de la collecte des données - elles sont disponibles sur la plateforme. Il nous suffit de les télécharger et nous pouvons commencer à travailler !
Nous pouvons le faire comme suit :
Dans l'onglet Data, se trouvent les fichiers contenant les données


Nous avons téléchargé les données, préparé nos notebooks Jupyter et…
Deuxième étape
Comment allons-nous maintenant charger ces données ?
Tout d'abord, importons les bibliothèques nécessaires :
import pandas as pd
import numpy as np
Pandas nous permettra de charger des fichiers .csv pour un traitement ultérieur.
Numpy est nécessaire pour représenter notre tableau de données sous forme de matrice de nombres.
Allons plus loin. Prenons le fichier train.csv et chargeons-le :
dataset = pd.read_csv('train.csv')
Nous allons référencer notre échantillon de données train.csv via la variable dataset. Regardons ce qu'il y a à l'intérieur :
dataset.head()
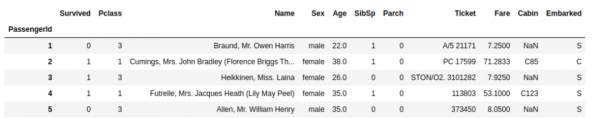
La fonction head() nous permet de visualiser les premières lignes du dataframe.
La colonne Survived représente nos résultats, qui sont connus dans ce dataframe. Concernant la tâche, nous devons prédire la colonne Survived pour les données test.csv. Ces données contiennent des informations sur d'autres passagers du Titanic, pour lesquels les résultats sont inconnus.
Donc, séparons notre tableau en données dépendantes et indépendantes. C'est assez simple. Les données dépendantes sont celles qui dépendent des indépendantes, c’est-à-dire celles qui se trouvent dans les résultats. Les données indépendantes sont celles qui influent sur le résultat.
Par exemple, nous avons ce jeu de données :
« Vova a étudié l'informatique — non.
Vova a reçu 2 en informatique. »
La note en informatique dépend de la réponse à la question : Vova a-t-il étudié l'informatique ? C'est clair ? Passons à la suite, nous sommes déjà plus proches de notre objectif !
La variable traditionnelle pour les données indépendantes est X. Pour les dépendantes, c'est y.
Nous faisons ce qui suit :
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Que signifie cela ? Avec la fonction iloc[:, 2: ], nous disons à Python : je veux voir dans la variable X les données commençant à partir de la deuxième colonne (inclusivement, en supposant que le comptage commence à zéro). Dans la deuxième ligne, nous indiquons que nous voulons voir dans y les données de la première colonne.
[ a:b, c:d ] — c'est la construction que nous utilisons entre crochets. Si nous ne spécifions pas certaines variables, elles seront conservées par défaut. Donc, nous pouvons spécifier [:,: d] et alors nous obtiendrons dans le dataframe toutes les colonnes sauf celles qui commencent à partir du numéro d et au-delà. Les variables a et b définissent les lignes, mais nous en avons besoin de toutes, donc nous les laissons par défaut.
Voyons ce que nous avons obtenu :
X.head() 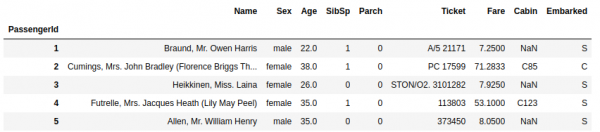
y.head() 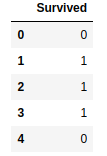
Pour simplifier ce petit cours, nous allons supprimer les colonnes qui nécessitent un « soin » particulier, ou qui n'influencent pas du tout la survie. Elles contiennent des données de type str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super ! Passons à l'étape suivante.
Étape trois
Ici, nous devons coder nos données pour que la machine puisse mieux comprendre comment ces données influencent le résultat. Mais nous ne coderons pas tout, seulement les données de type str que nous avons laissées. La colonne « Sexe ». Comment souhaitons-nous coder cela ? Représentons les données sur le genre d'une personne sous forme de vecteur : 10 pour masculin, 01 pour féminin.
Tout d'abord, nous allons transformer nos tableaux en matrice NumPy :
X = np.array(X)
y = np.array(y)
Et maintenant, regardons :
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
La bibliothèque sklearn est une super bibliothèque qui nous permet de réaliser tout le travail en Data Science. Elle contient de nombreux modèles intéressants d'apprentissage automatique et nous permet également de nous occuper de la préparation des données.
OneHotEncoder nous permettra de coder le genre d'une personne comme nous l'avons décrit. Deux classes seront créées : masculin et féminin. Si la personne est un homme, alors 1 sera enregistré dans la colonne « masculin », et 0 dans la colonne « féminin ».
Après OneHotEncoder() se trouve [1] — cela signifie que nous souhaitons coder la colonne numéro 1 (compté à partir de zéro).
Super. Continuons encore plus loin !
Il arrive souvent que certaines données restent incomplètes (c'est-à-dire NaN — not a number). Par exemple, il y a des informations sur une personne : son nom, son genre. Mais il n'y a pas de données sur son âge. Dans ce cas, nous appliquerons la méthode suivante : nous trouverons la moyenne arithmétique de toutes les colonnes et, si des données sont manquantes dans une colonne, nous remplirons le vide avec la moyenne arithmétique.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Et maintenant, prenons en compte le fait que certaines situations se présentent où les données sont très étendues. Certaines données se situent dans l'intervalle [0:1], tandis que d'autres peuvent atteindre des centaines et des milliers. Pour exclure une telle variation et que l'ordinateur soit plus précis dans ses calculs, nous allons mettre les données à l'échelle. Assurons-nous que tous les nombres ne dépassent pas trois. Pour cela, nous utiliserons la fonction StandartScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Maintenant, nos données ressemblent à ceci :

Génial. Nous sommes déjà proches de notre objectif !
Étape quatre
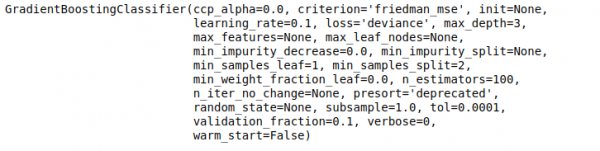
Entraînons notre premier modèle ! Dans la bibliothèque sklearn, nous pouvons trouver un grand nombre d'intérêts. J'ai appliqué à cette tâche le modèle Gradient Boosting Classifier. Nous utilisons un classificateur car notre tâche est une tâche de classification. Nous devons prédire si une personne est classée 1 (survécu) ou 0 (non survécu).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
La fonction fit dit à Python : laissez le modèle chercher des relations entre X et y.
Moins d'une seconde et le modèle est prêt.
Comment l'appliquer ? Nous allons le voir !
Étape cinq. Conclusion
Nous devons maintenant charger le tableau avec nos données de test, pour lesquelles nous devons faire des prédictions. Nous effectuerons toutes les mêmes actions que nous avons faites pour X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Appliquons déjà notre modèle !
gbc_predict = gbc.predict(X_test)
C'est tout. Nous avons fait la prédiction. Maintenant, nous devons l'enregistrer dans un CSV et l'envoyer sur le site.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
C'est prêt. Nous avons obtenu un fichier contenant les prédictions pour chaque passager. Il ne reste plus qu'à télécharger ces solutions sur le site et à obtenir une évaluation des prévisions. Une telle solution primitive donne non seulement 74 % de bonnes réponses en public, mais représente également un certain élan en Data Science. Les plus curieux peuvent toujours m'envoyer un message privé pour poser des questions. Merci à tous !
Source : habr.com
