

Le trafic légitime sur le réseau DDoS-Guard a récemment dépassé les cent gigabits par seconde. Actuellement, 50 % de tout notre trafic provient des services web de nos clients. Il s'agit de plusieurs dizaines de milliers de domaines, très variés et nécessitant, dans la plupart des cas, une approche individualisée.
Sous le couvercle — comment nous gérons les nœuds frontaux et émettons Certificats SSL pour des centaines de milliers de sites.
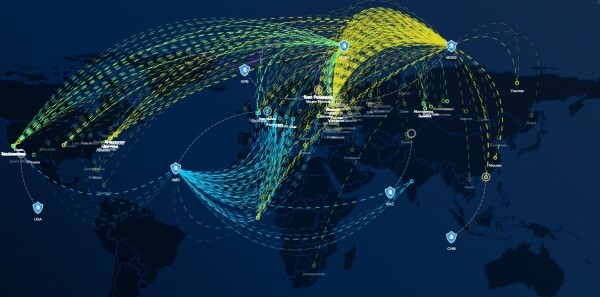
Configurer un frontal pour un seul site, même très grand, c’est simple. Nous prenons nginx ou haproxy ou lighttpd, nous le configurons selon les guides et nous oublions. Si nous devons changer quelque chose, nous faisons un reload et nous oublions encore.
Tout change lorsque vous traitez en temps réel de gros volumes de trafic, évaluez la légitimité des requêtes, compressez et mettez en cache le contenu utilisateur, tout en modifiant les paramètres plusieurs fois par seconde. L'utilisateur veut voir le résultat sur tous les nœuds externes immédiatement après avoir modifié les paramètres dans son espace personnel. De plus, l'utilisateur peut télécharger via l'API plusieurs milliers (parfois même des dizaines de milliers) de domaines avec des paramètres de traitement du trafic individuels. Tout cela doit également fonctionner immédiatement en Amérique, en Europe et en Asie — une tâche pas si triviale, sachant que rien qu'à Moscou, il y a plusieurs nœuds de filtrage physiques dispersés.
Pourquoi avoir beaucoup de nœuds fiables et importants à travers le monde ?
- La qualité du service du trafic client — les requêtes en provenance des États-Unis doivent être traitées précisément aux États-Unis (y compris en ce qui concerne les attaques, le parsing et d'autres anomalies), et non pas transportées à Moscou ou en Europe, augmentant de manière imprévisible la latence de traitement.
- Le trafic d'attaque doit être localisé — les opérateurs de transit peuvent dégénérer lors des attaques dont le volume dépasse souvent 1Tbps. Transporter le trafic d'attaque par des liaisons transatlantiques ou transasiatiques n’est pas la meilleure idée. Nous avons eu des cas réels où des opérateurs de niveau 1 ont déclaré : « Les volumes d'attaque que vous recevez sont dangereux pour nous. » C'est pourquoi nous acceptons les flux entrants aussi près que possible de leurs sources.
- Les exigences strictes en matière de continuité des services stipulent que les centres de traitement ne doivent pas dépendre les uns des autres ni des événements locaux de notre monde en constante évolution. Une coupure de courant de tout un étage du MMTS-9 pendant une semaine ? Pas de soucis. Aucun client ne sera affecté s'il n'est pas physiquement connecté à cet emplacement, et les services web ne subiront aucune interruption, quelles que soient les circonstances.
Comment gérer tout cela ?
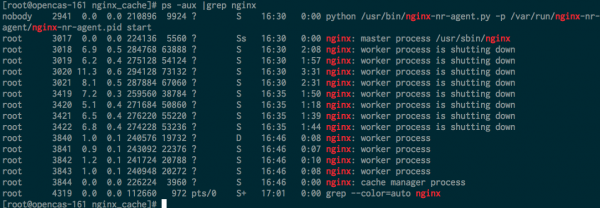
Les configurations des services doivent être diffusées le plus rapidement possible (de préférence instantanément) sur tous les nœuds frontaux. Il n'est pas acceptable de simplement modifier les fichiers de configuration texte et de redémarrer les démons à chaque changement — le même nginx maintient des processus en cours (worker shutting down) pendant encore quelques minutes (voire quelques heures si des sessions websocket longues sont en cours).
Lors du redémarrage de la configuration, il est tout à fait normal d'observer le tableau suivant :
Concernant l'utilisation de la mémoire :
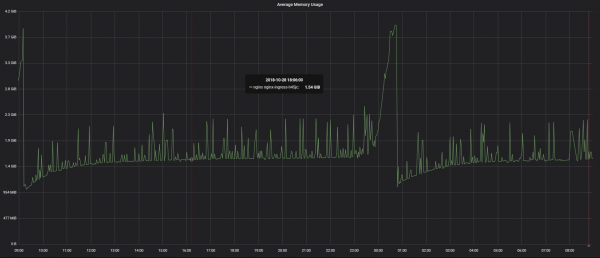
Les anciens travailleurs consomment de la mémoire, y compris celle qui n'est pas linéairement dépendante du nombre de connexions, ce qui est normal. Lorsque les connexions des clients seront fermées, cette mémoire sera libérée.
Pourquoi cela n'était-il pas un problème lorsque nginx a commencé à se développer ? Il n'y avait ni HTTP/2, ni WebSocket, ni connexions keep-alive longues massivement utilisées. 70 % de notre trafic web utilise HTTP/2, ce qui représente des connexions très longues.
La solution est simple : ne pas utiliser nginx, ne pas gérer les fronts sur la base de fichiers texte, et surtout, ne pas envoyer des configurations texte compressées par les canaux transpacifiques. Les canaux, bien sûr, sont garantis et réservés, mais cela ne les rend pas moins transcontinentaux.
Nous avons notre propre serveur frontal-balanceur, dont je parlerai dans les prochains articles. La principale capacité est qu'il peut appliquer des milliers de modifications de configuration par seconde en temps réel, sans redémarrages, rechargements, ni pics de consommation de mémoire, et tout ça. C'est très similaire au Hot Code Reload, par exemple en Erlang. Les données sont stockées dans une base de données clé-valeur géodistribuée et sont lues immédiatement par les mécanismes d'exécution en frontal. C'est-à-dire que vous avez chargé le certificat SSL via l'interface web ou l'API à Moscou, et en quelques secondes, il est déjà prêt à fonctionner dans notre centre de purification à Los Angeles. Si jamais une guerre mondiale se produisait et que l'internet disparaissait dans le monde entier, nos nœuds continueraient à fonctionner de manière autonome et répareraient le split-brain dès qu'un des canaux dédiés Los Angeles-Amsterdam-Moscou, Moscou-Amsterdam-Hong Kong-Los Angeles ou au moins l'un des GRE de secours serait disponible.
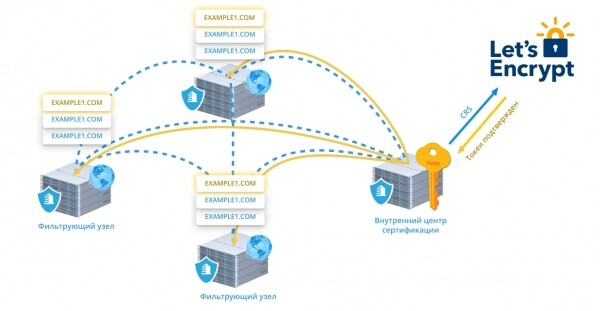
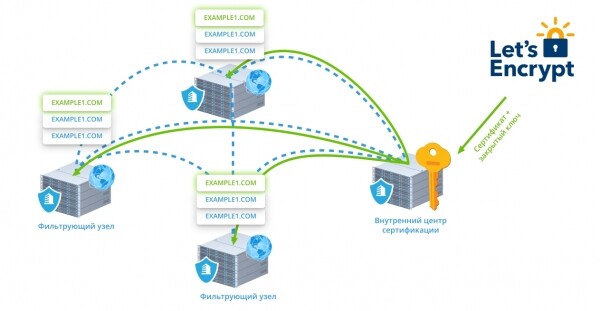
Ce même mécanisme nous permet de publier et de prolonger instantanément des certificats Let’s Encrypt. Très schématiquement, cela fonctionne comme suit :
- Dès que nous recevons au moins une requête HTTPS pour le domaine de notre client sans certificat (ou avec un certificat expiré), le nœud externe qui a reçu la requête informe le centre de certification interne.

- Si l'utilisateur n'a pas interdit l'émission de Let’s Encrypt, le centre de certification génère un CSR, reçoit un token de confirmation de LE et le diffuse à tous les fronts par un canal chiffré. Maintenant, n'importe quel nœud peut confirmer la requête de validation de LE.
- Dans quelques instants, nous recevrons le certificat correct et la clé privée et nous les distribuerons de la même manière aux fronts. Encore une fois, sans redémarrer les démons.
- Sept jours avant la date d'expiration, la procédure de renouvellement du certificat est initiée.
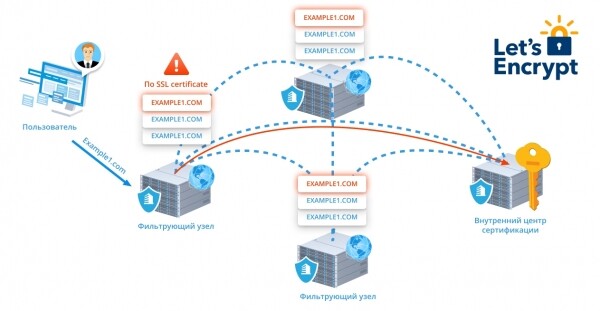
En ce moment même, nous rotatif en temps réel 350 000 certificats de manière totalement transparente pour les utilisateurs.
Dans les prochains articles de la série, je parlerai d'autres caractéristiques du traitement en temps réel d'un important trafic web - par exemple, de l'analyse du RTT avec des données incomplètes pour améliorer la qualité de service des clients de transit, et en général de la protection du trafic de transit contre les attaques de plusieurs térabits, de la livraison et de l'agrégation des informations sur le trafic, du WAF, d'un CDN presque illimité et de nombreux mécanismes d'optimisation de la restitution du contenu.
Seuls les utilisateurs enregistrés peuvent participer au sondage. Connectez-vous, s'il vous plaît.
Sur quoi aimeriez-vous en savoir plus en premier ?
- 14,3%Algorithmies de clustering et d'analyse de la qualité du trafic web<3
- 33,3%Intérieurs des équilibreurs DDoS-Guard7
- 9,5%Protection du trafic transit L3/L42
- 0,0%Protection des sites web sur le trafic transit0
- 14,3%Pare-feu d'application web3
- 28,6%Protection contre le scraping et le click fraud6
21 utilisateurs ont voté. 6 utilisateurs se sont abstenus.
Source : habr.com
