

VictoriaMetrics — une base de données rapide et évolutive pour le stockage et le traitement des données sous forme de séries temporelles (un enregistrement forme le temps et un ensemble de valeurs correspondantes à ce temps, par exemple, obtenues via un sondage périodique de l'état des capteurs ou la collecte de métriques).
Je m'appelle Pavel Kolobaev. DevOps, SRE, LeroyMerlin, tout comme le code – c'est tout nous : moi et les autres employés de LeroyMerlin.
Il existe un nuage basé sur OpenStack. Voici un petit lien vers le radar technique.
Il est construit sur du matériel Kubernetes, ainsi que sur tous les services associés à OpenStack et à la journalisation.
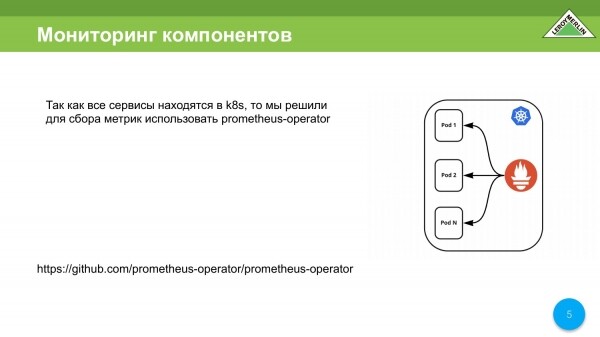
Voici comment nous avons organisé le développement. Lorsque nous avons tout développé, nous avions un opérateur Prometheus qui stockait les données à l'intérieur du cluster K8s. Il trouve automatiquement ce qu'il faut scraper et le place sous ses pieds, pour dire les choses simplement.
Nous devons déplacer toutes les données en dehors du cluster Kubernetes, car si quelque chose se produit, nous devons comprendre où et quoi.
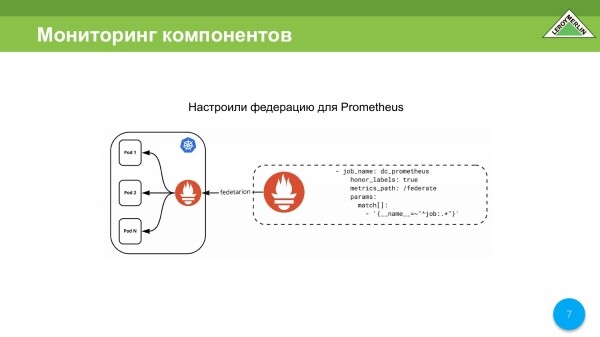
La première solution consiste à utiliser la fédération, lorsque nous avons un Prometheus externe, lorsque nous accédons au cluster Kubernetes via le mécanisme de fédération.
Mais ici, cela pose quelques problèmes. Dans notre cas, les problèmes ont commencé lorsque nous avions 250 000 métriques, et lorsque nous sommes passés à 400 000 métriques, nous avons réalisé que nous ne pouvions pas travailler de cette manière. Nous avons augmenté le scrape_timeout à 25 secondes.
Pourquoi avons-nous dû faire cela ? Prometheus commence à compter le temps d'attente à partir du moment où il commence à collecter. Et peu importe que les données soient encore en cours d'envoi. Si, pendant cette période spécifiée, les données ne sont pas envoyées et que la session n'est pas fermée par http, il est considéré que la session a échoué et que les données ne sont pas envoyées dans Prometheus lui-même.
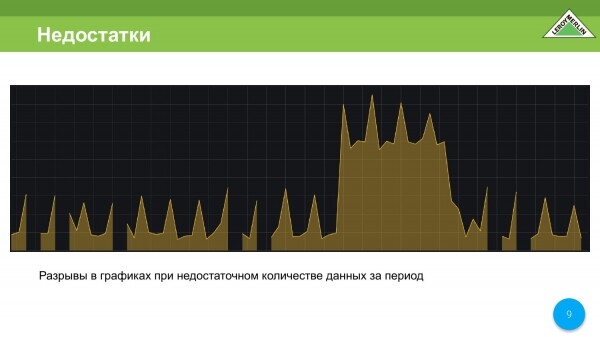
Tout le monde connaît les graphiques que nous obtenons lorsque certaines données sont manquantes. Les graphiques sont fragmentés et cela ne nous convient pas.
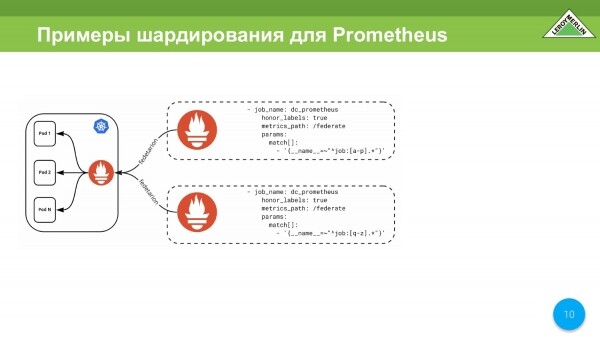
La prochaine option est le partitionnement basé sur deux Prometheus différents via le même mécanisme de fédération.
Par exemple, simplement les partitionner par nom. Cela peut également être utilisé, mais nous avons décidé d'aller plus loin.
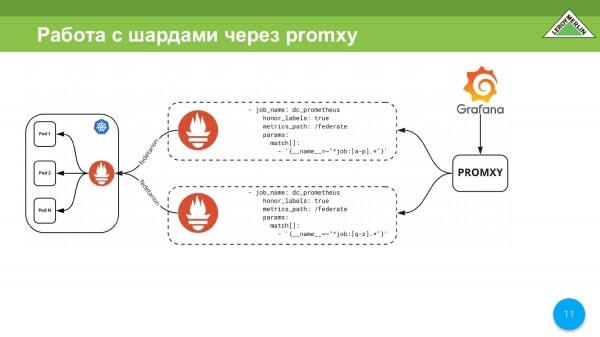
Nous allons maintenant devoir traiter ces shards d'une manière ou d'une autre. On peut utiliser promxy, qui va dans la zone du shard, multiplie les données. Il fonctionne avec deux shards comme un point d'entrée unique. Cela peut être réalisé via promxy, mais c'est encore trop complexe.
La première option – nous voulons renoncer au mécanisme de fédération, car il est très lent.
Les développeurs de Prometheus disent clairement : « Les gars, utilisez d'autres TimescaleDB, car nous ne supporterons pas un stockage à long terme des métriques ». Ce n'est pas leur rôle. 
Nous notons sur un papier qu'il nous faut effectivement une exportation vers l'extérieur, afin de ne pas tout stocker au même endroit.
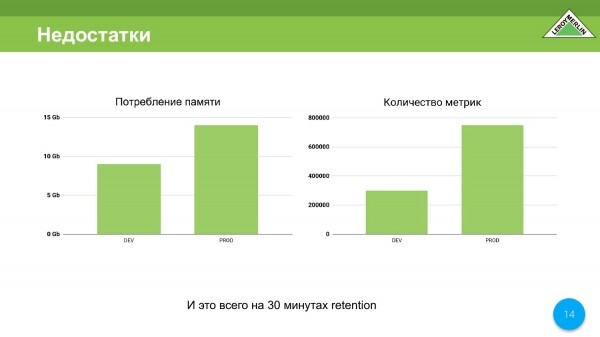
Le deuxième inconvénient est la consommation de mémoire. Oui, je comprends que beaucoup diront qu'en 2020, quelques gigaoctets de mémoire ne coûtent pas cher, mais néanmoins.
Actuellement, nous avons un environnement dev et prod. En dev, cela représente environ 9 gigaoctets pour 350 000 métriques. En prod, c'est juste un peu plus de 14 gigaoctets pour 780 000 métriques. De plus, notre temps de rétention est de seulement 30 minutes. C'est problématique. Et je vais expliquer pourquoi.
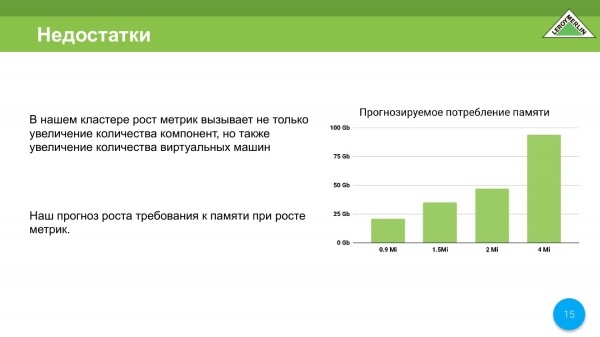
Nous faisons le calcul, c'est-à-dire qu'avec un million et demi de métriques, et nous y sommes presque, au stade de la conception, nous prévoyons 35 à 37 gigaoctets de mémoire. Mais déjà pour 4 millions de métriques, il faut environ 90 gigaoctets de mémoire. Cela a été calculé selon la formule fournie par les développeurs de Prometheus. Nous avons observé la corrélation et compris que nous ne voulons pas payer quelques millions pour un serveur juste pour la surveillance.
Nous n'allons pas seulement augmenter le nombre de machines, nous surveillons aussi les machines virtuelles elles-mêmes. Donc, plus il y a de machines virtuelles, plus il y aura de métriques de différents types, etc. Nous prévoyons une croissance spéciale de notre cluster en termes de métriques.
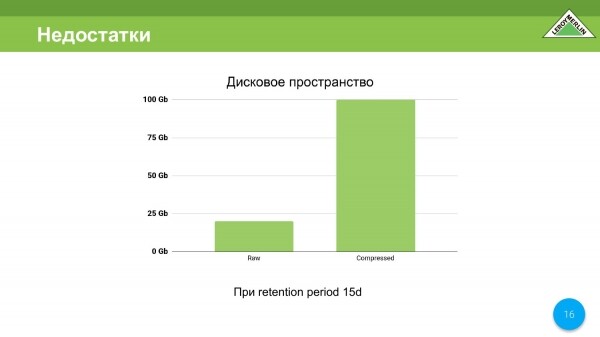
Ce n'est pas si grave en ce qui concerne l'espace disque, mais nous aimerions l'améliorer. Nous avons obtenu en 15 jours un total de 120 gigaoctets, dont 100 sont des données compressées, 20 des données non compressées, mais nous souhaiterions toujours moins.
Par conséquent, nous notons un autre point : c'est une grande consommation de ressources que nous aimerions économiser, car nous ne voulons pas que notre cluster de surveillance consomme plus de ressources que notre cluster qui gère OpenStack.
Il y a un autre inconvénient de Prometheus que nous avons identifié, c'est au moins une certaine limitation de la mémoire. Avec Prometheus, c'est bien pire, car il n'a pas du tout ce type de réglages. Utiliser des limites de mémoire dans Docker n’est également pas une option. Si votre RAF tombe et qu'il y a 20-30 gigaoctets, la remontée prendra beaucoup de temps.
C'est une autre raison pour laquelle Prometheus ne nous convient pas, c'est-à-dire qu'il n'est pas possible de limiter la consommation de mémoire.
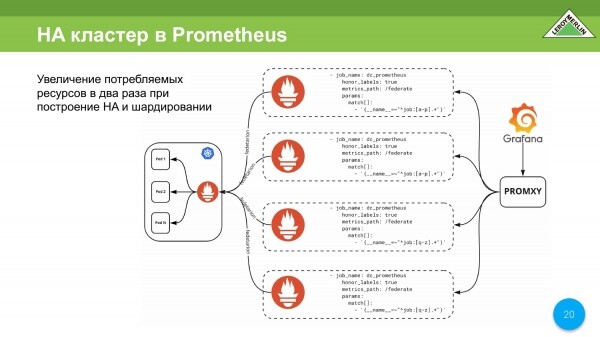
Nous pourrions adopter un tel schéma. Ce schéma est nécessaire pour organiser un cluster HA. Nous voulons que nos métriques soient toujours et partout accessibles, même en cas de panne du serveur qui les stocke. Ainsi, nous devrons construire un tel schéma.
Ce schéma indique que nous aurons une duplication des shards, et par conséquent, une duplication des ressources consommées. Il peut presque être mis à l'échelle horizontalement, mais néanmoins, la consommation des ressources sera énorme.
Les inconvénients, par ordre, tels que nous les avons écrits pour nous :
- Une exportation des métriques vers l'extérieur est nécessaire.
- Grande consommation de ressources.
- Impossible de limiter la consommation de mémoire.
- Implémentation complexe et gourmande en ressources pour le HA.
Nous avons décidé d'abandonner Prometheus comme solution de stockage.
Nous avons également défini d'autres exigences dont nous avons besoin. Celles-ci sont :
- Le support de promql, car beaucoup de choses ont déjà été écrites pour Prometheus : requêtes, alertes.
- Et ensuite, nous avons Grafana, qui est également conçue pour Prometheus en tant que backend. Nous ne voulons pas réécrire les dashboards.
- Nous voulons construire une architecture HA correcte.
- Nous souhaitons réduire la consommation de toutes les ressources.
- Il y a encore un petit détail. Nous ne pouvons pas utiliser différents types de systèmes cloud de collecte de métriques. Nous ne savons pas ce qui se perdra dans ces métriques pour l'instant. Et comme tout ce qui veut y aller peut s'y retrouver, nous devons nous limiter à un hébergement local.
Le choix était limité. Nous avons rassemblé tout ce que nous avions expérimenté. Nous avons regardé la page de Prometheus dans la section intégration, lu de nombreux articles, et vérifié ce qui existe. Nous avons choisi VictoriaMetrics comme remplacement de Prometheus.
Pourquoi ? Parce que :
- Il sait utiliser promql.
- Il dispose d'une architecture modulaire.
- Il ne nécessite pas de modifications dans Grafana.
- Et surtout – il est possible que nous offrions le stockage des métriques au sein de notre entreprise en tant que service, donc nous nous orientons déjà vers des limitations de divers types, afin que les utilisateurs puissent utiliser toutes les ressources du cluster d'une manière un peu limitée, car il y a une chance qu'il soit multitenant.
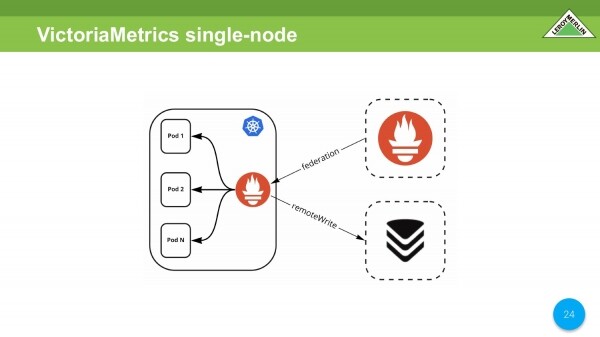
Nous faisons une première comparaison. Nous prenons le même Prometheus à l'intérieur du cluster, auquel se connecte un Prometheus externe. Nous ajoutons VictoriaMetrics via remoteWrite.
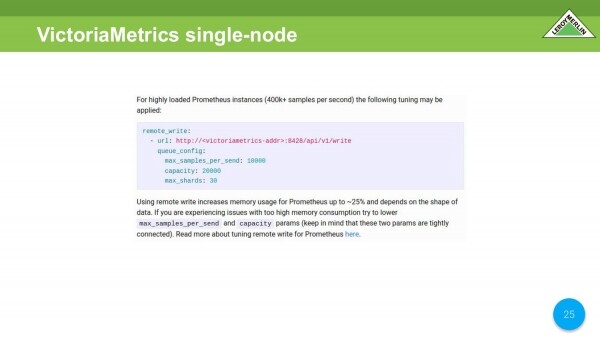
Je précise tout de suite qu'ici nous avons constaté une légère augmentation de la consommation CPU de VictoriaMetrics. La wiki de VictoriaMetrics indique quels paramètres sont les plus appropriés. Nous les avons vérifiés. Ils ont très bien réduit la consommation spécifiquement en ce qui concerne le CPU.
Dans notre cas, la consommation de mémoire de Prometheus, qui est dans le cluster Kubernetes, a légèrement augmenté.
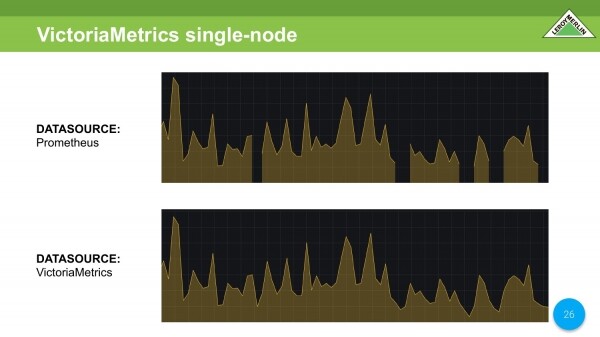
Nous comparons deux sources de données des mêmes données. Dans Prometheus, nous voyons toutes les mêmes données manquantes. Dans VictoriaMetrics, tout est en ordre.
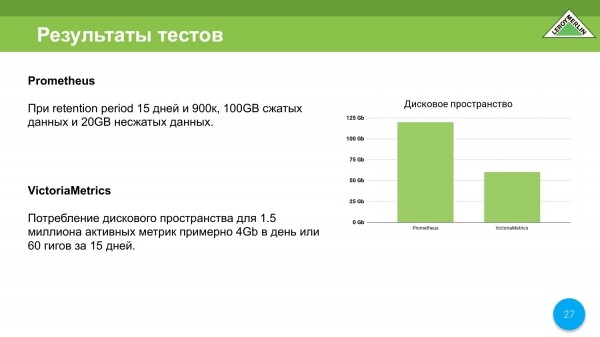
Résultats des tests en termes d'espace disque. Nous avons obtenu 120 Go au total dans Prometheus. Avec VictoriaMetrics, nous obtenons déjà 4 Go par jour. Il y a un mécanisme légèrement différent de ce à quoi nous sommes habitués avec Prometheus. Autrement dit, les données sont déjà assez bien comprimées en une journée, en une demi-heure. Elles sont bien comprimées après une journée, en une demi-heure, même si les données seront ensuite fusionnées. Au final, nous avons économisé sur l'espace disque.
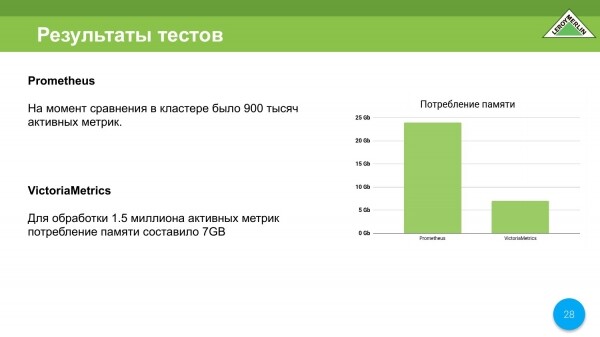
Nous faisons également des économies sur la consommation des ressources mémoire. Lors des tests, Prometheus était déployé sur une machine virtuelle - 8 cœurs, 24 Go. Prometheus consomme pratiquement tout. Il a été arrêté par OOM Killer. En même temps, il ne traitait que 900 000 métriques actives. Cela représente environ 25 000 à 27 000 métriques par seconde.
VictoriaMetrics était exécuté sur une machine virtuelle à deux cœurs avec 8 Go de RAM. Nous avons réussi à faire fonctionner VictoriaMetrics efficacement en ajustant certaines choses sur la machine de 8 Go. Nous avons finalement utilisé 7 Go. De plus, nous avons obtenu une vitesse de livraison de contenu, c'est-à-dire de métriques, même supérieure à celle de Prometheus.
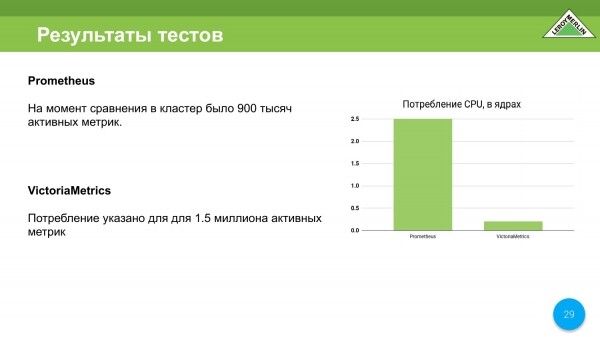
En ce qui concerne le CPU, c'est beaucoup mieux par rapport à Prometheus. Ici, Prometheus consomme 2,5 cœurs, tandis que VictoriaMetrics ne consomme que 0,25 cœur. Au départ, c'est 0,5 cœur. Au fur et à mesure de la fusion, il atteint un cœur, mais cela arrive extrêmement rarement.
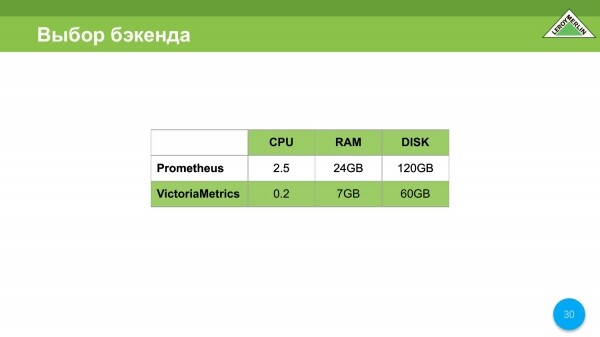
Dans notre cas, le choix s'est porté sur VictoriaMetrics pour des raisons évidentes, nous souhaitions économiser et nous avons réussi.
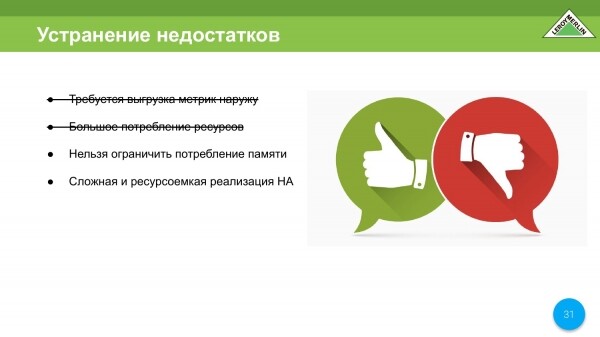
Nous éliminons immédiatement deux points - l'exportation des métriques et une grande consommation de ressources. Il ne reste plus que deux points à résoudre que nous avons encore à examiner.
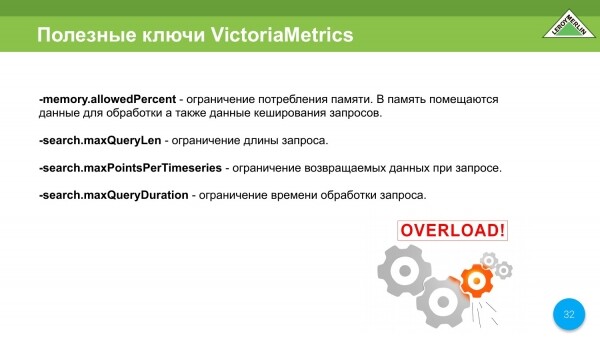
Je précise tout de suite que nous considérons VictoriaMetrics comme un stockage de métriques. Mais puisque nous allons probablement fournir VictoriaMetrics comme stockage pour tout Leroy, nous devons restreindre ceux qui utiliseront ce cluster afin qu'ils ne le mettent pas en panne.
Il existe une excellente option qui permet de limiter le temps, le volume de données et la durée d'exécution.
Il y a aussi une option fantastique qui permet de limiter la consommation de mémoire, nous permettant ainsi de trouver cet équilibre qui nous donnera une vitesse de fonctionnement normale et une consommation de ressources adéquate.
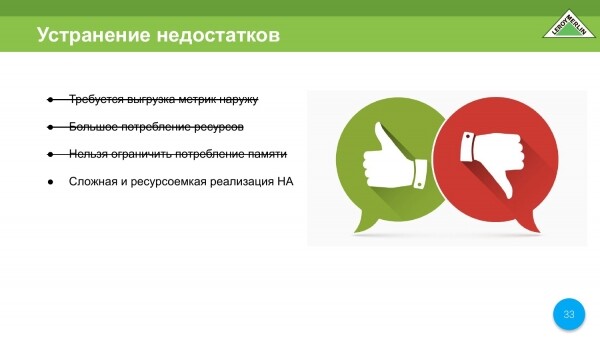
Un point de moins, c'est-à-dire que nous rayons le point – la consommation de mémoire ne peut pas être limitée.
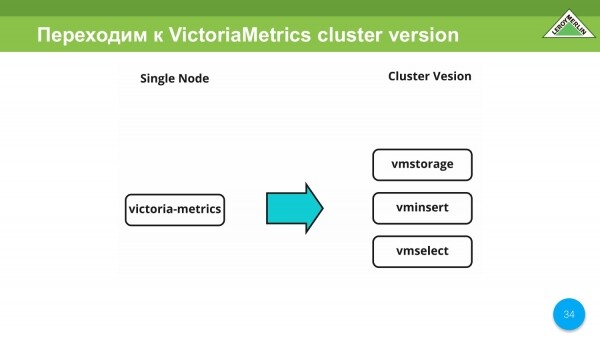
Dans les premières itérations, nous avons testé VictoriaMetrics Single Node. Nous passons maintenant à la version Cluster de VictoriaMetrics.
Ici, nous avons une flexibilité quant à la répartition des différents services dans VictoriaMetrics en fonction de leur fonctionnement et de leurs ressources consommées. C'est une solution très flexible et pratique. Nous l'avons utilisée nous-mêmes.
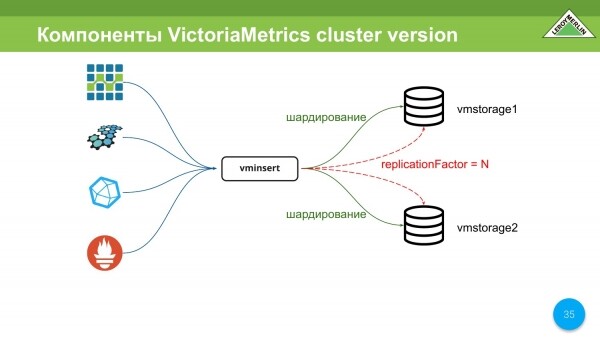
Les composants principaux de la version Cluster de VictoriaMetrics sont le vmstorage. Il peut y en avoir un nombre N. Dans notre cas, nous en avons deux pour l'instant.
Et il y a le vminsert. C'est un serveur proxy qui nous permet : d'organiser le sharding entre tous les storages que nous lui avons indiqués, et il supporte également la réplication, c'est-à-dire que vous aurez à la fois du sharding et de la réplication.
Le vminsert prend en charge les protocoles OpenTSDB, Graphite, InfluxDB et remoteWrite de Prometheus.
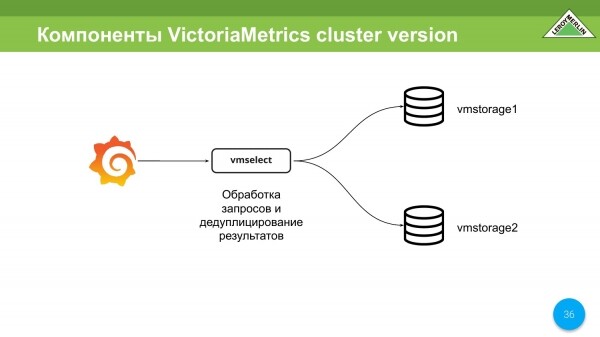
Il y a aussi le vmselect. Sa tâche principale est d'aller dans le vmstorage, d'en obtenir les données, de les dédupliquer et de les transmettre au client.
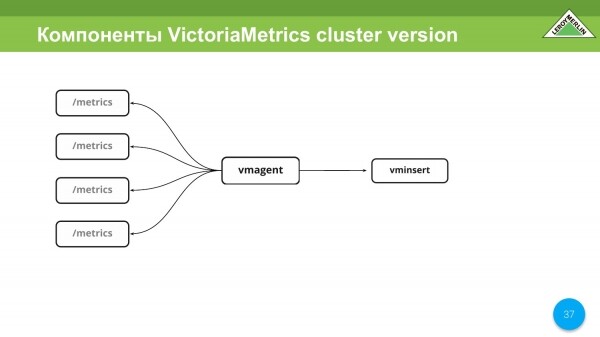
Il y a une chose formidable qu'est le vmagent. Nous l'aimons beaucoup. Il permet de configurer de la même manière que Prometheus tout en faisant exactement la même chose que Prometheus. C'est-à-dire qu'il collecte des métriques à partir de différentes entités, services, et les envoie au vminsert. Après cela, tout dépend de vous.
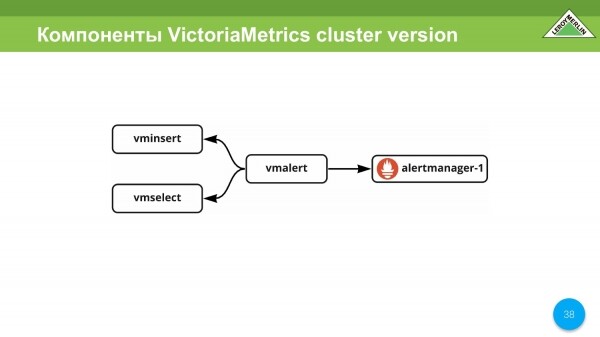
Un autre service remarquable est le vmalert, qui permet d'utiliser VictoriaMetrics comme backend, de recevoir des données de vminsert et de les transmettre à vmselect. Il traite les alertes et les règles. En cas d'alerte, nous recevons l'alerte via alertmanager.
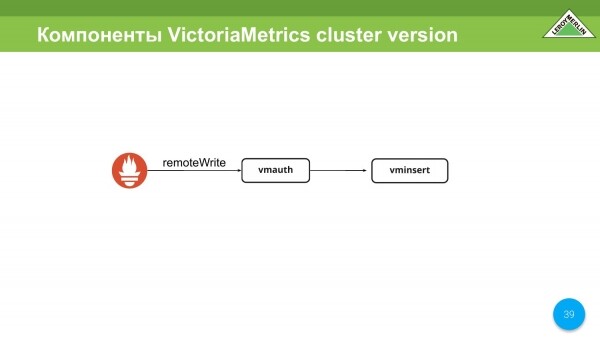
Il y a un composant wmauth. Il sera peut-être utilisé, ou peut-être pas (nous ne nous sommes pas encore décidés) comme système d'autorisation pour la version multitenancy des clusters. Il prend en charge remoteWrite pour Prometheus et peut autoriser sur la base de l'url, plus précisément de sa deuxième partie, où vous pouvez ou non écrire.
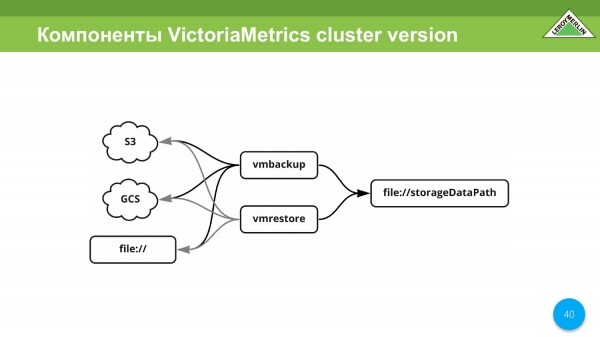
Il y a encore le vmbackup, le vmrestore. Ce sont, en fait, la récupération et la sauvegarde de toutes les données. Il gère S3, GCS, file.
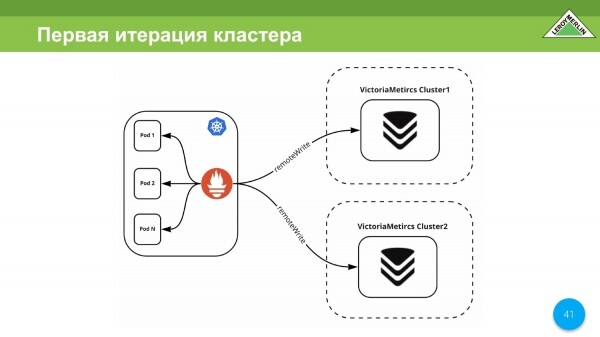
La première itération de notre cluster a été réalisée pendant le confinement. À ce moment-là, il n'y avait pas de réplique, donc notre itération était composée de deux clusters différents et indépendants, d'où nous obtenions des données via remoteWrite.
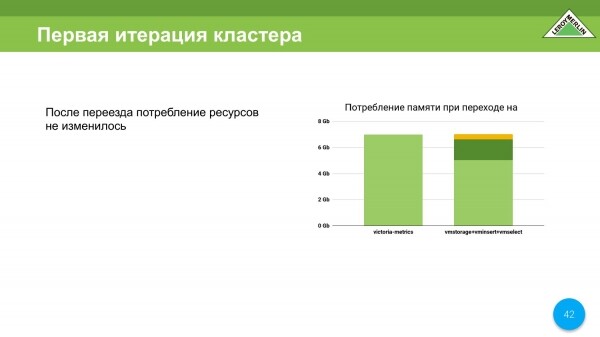
Je préciserai ici qu'en passant de VictoriaMetrics Single Node à VictoriaMetrics Cluster Version, nous avons conservé les mêmes ressources consommées, c'est-à-dire principalement la mémoire. Voici comment nos données se sont réparties, c'est-à-dire la consommation des ressources.
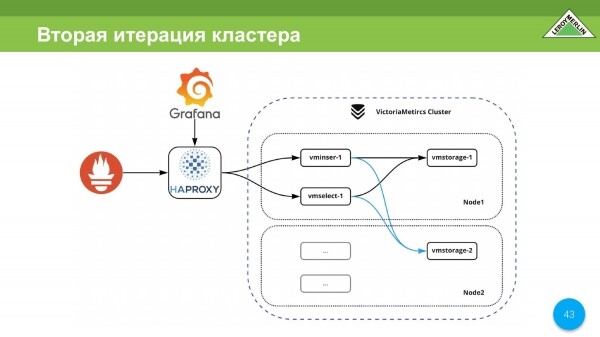
Une réplication a déjà été ajoutée. Nous avons fusionné tout cela en un seul cluster relativement grand. Toutes nos données sont à la fois shardées et répliquées.
L'ensemble du cluster a N points d'entrée, c'est-à-dire que Prometheus peut ajouter des données via HAPROXY. Voici notre point d'entrée. Et par ce point d'entrée, on peut accéder à Grafana.
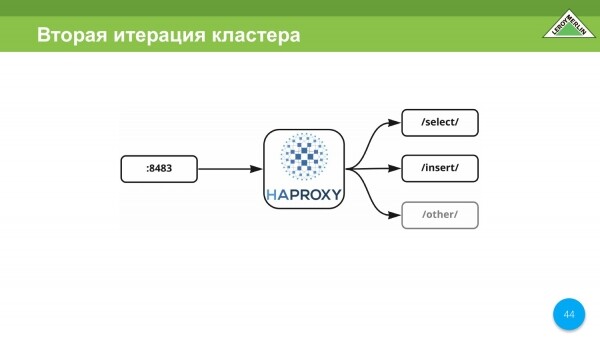
Dans notre cas, HAPROXY est le seul port qui proxy select, insert et les autres services à l'intérieur de ce cluster. Dans notre cas, il n'a pas été possible de créer une seule adresse, nous avons dû établir plusieurs points d'entrée, car les machines virtuelles sur lesquelles le cluster VictoriaMetrics fonctionne se trouvent dans différentes zones d'un même fournisseur de cloud, c'est-à-dire à l'extérieur de notre cloud.
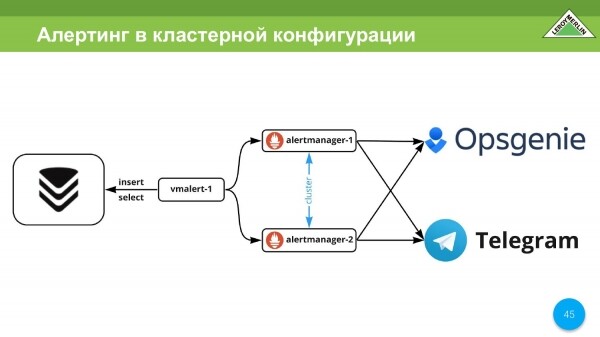
Nous avons un système d'alerte. Nous l'utilisons. Nous utilisons alertmanager de Prometheus. Pour la livraison des alertes, nous utilisons Opsgenie et Telegram. Sur Telegram, nous recevons des alertes de dev, peut-être quelque chose de prod, mais surtout des éléments statistiques nécessaires aux ingénieurs. Opsgenie est pour les alertes critiques. Ce sont des appels, la gestion des incidents.
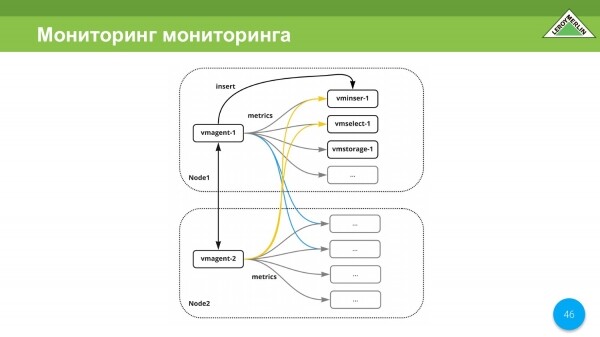
La question éternelle : «Qui surveille la surveillance ?». Dans notre cas, la surveillance surveille elle-même la surveillance, car nous utilisons vmagent sur chaque nœud. Étant donné que nos nœuds sont dispersés dans différents centres de données d'un même fournisseur, chaque centre de données a son propre canal, ils sont indépendants et même en cas de split brain, nous recevrons tout de même des alertes. Oui, il y en aura plus, mais il vaut mieux recevoir plus d'alertes que pas du tout.
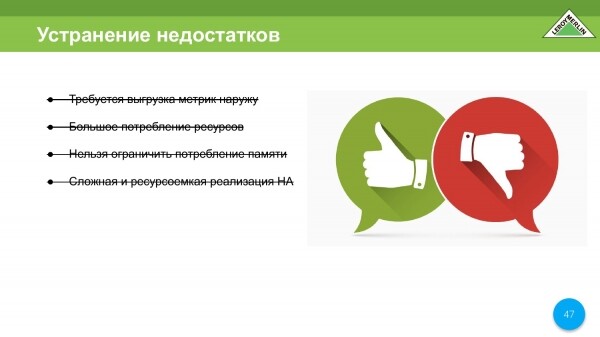
Nous concluons notre liste avec la mise en œuvre de la HA.
Je voudrais également souligner l'expérience de collaboration avec la communauté VictoriaMetrics. Cela a été très positif. Les gars sont réactifs. Ils essaient de comprendre chaque cas proposé.
J'ai créé des issues sur GitHub. Elles ont été résolues très rapidement. Il y a encore quelques issues qui ne sont pas complètement résolues, mais je vois déjà dans le code que des travaux sont en cours dans cette direction.
La principale douleur pendant les itérations pour moi était que si je coupais un nœud, alors pendant les 30 premières secondes, vminsert ne pouvait pas comprendre qu'il n'y avait pas de backend. Maintenant, c'est résolu. En une seconde ou deux, les données sont déjà récupérées de tous les nœuds restants, et la requête cesse d'attendre le nœud manquant.
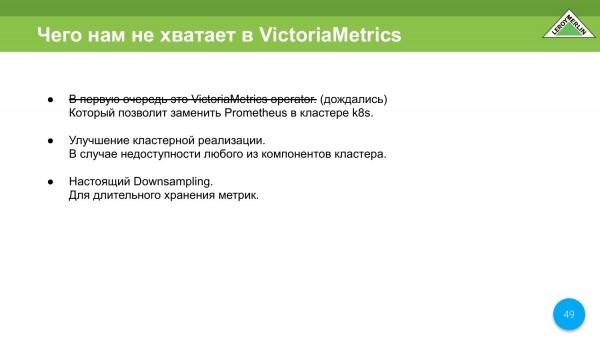
À un moment donné, nous voulions que ce soit un opérateur VictoriaMetrics. Nous l'avons attendu. Nous construisons actuellement une interface autour de l'opérateur VictoriaMetrics pour prendre toutes les règles de pré-calcul, etc. à Prometheus, car nous utilisons assez activement les règles qui viennent avec l'opérateur Prometheus.
Il y a des suggestions pour améliorer l'implémentation en cluster. Je les ai exposées ci-dessus.
Et il y a aussi un besoin urgent de downsampling. Dans notre cas, le downsampling est nécessaire uniquement pour visualiser les tendances. En gros, j'ai besoin d'une seule métrique pendant la journée. Ces tendances doivent être disponibles pour un an, trois ans, cinq ans, dix ans. Et une seule valeur de métrique est tout à fait suffisante.
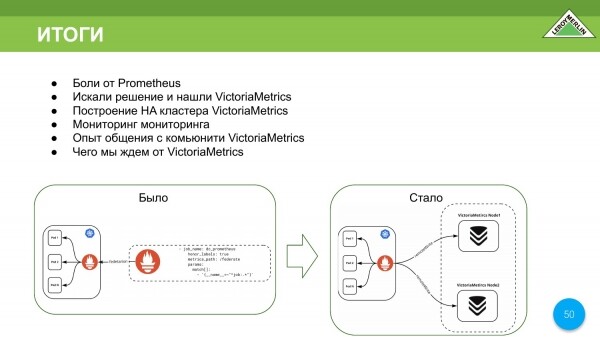
- Nous avons ressenti la douleur, comme certains de nos collègues, en utilisant Prometheus.
- Nous avons choisi VictoriaMetrics.
- Elle évolue très bien à la fois verticalement et horizontalement.
- Nous pouvons répartir différents composants sur un nombre différent de nœuds dans le cluster, les limiter en termes de mémoire, ajouter de la mémoire, etc.
Nous utiliserons VictoriaMetrics chez nous, car elle nous a beaucoup plu. Voici ce qu'il en était et ce qu'il en est devenu.
Quelques QR codes pour le chat VictoriaMetrics, mes contacts, le radar technologique LeroyMerlin.
Source : habr.com
