

Cette note sera intéressante pour ceux qui utilisent la bibliothèque de traitement de données tabulaires pour R — data.table, et peut-être sera-t-elle ravie de voir la flexibilité de son application à travers différents exemples.
Inspiré par un bon exemple , et espérant que vous avez déjà lu son article, je propose d'approfondir l'optimisation du code et la performance basée sur data.table.
Introduction : d'où vient data.table ?
Il est préférable de commencer à se familiariser avec la bibliothèque un peu à distance, à savoir avec les structures de données à partir desquelles peut être obtenu un objet data.table (ci-après, DT).
Tableau
Code
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
L'une de ces structures est un tableau (?base::array). Comme dans d'autres langages, les tableaux ici sont multidimensionnels. Cependant, ce qui est intéressant, c'est que, par exemple, un tableau à deux dimensions commence à hériter des propriétés de la classe matrice (?base::matrix), tandis qu'un tableau à une dimension, ce qui est également important, n'hérite pas d'un vecteur (?base::vector).
Il faut comprendre que le type de données contenues dans un objet doit être vérifié à l'aide de la fonction base::typeof, qui retourne une description interne du type selon R Internals — un protocole général du langage, lié à l'origine C.
Une autre commande pour déterminer la classe d'un objet, base::class, retourne, dans le cas des vecteurs, le type vectoriel (il porte un nom différent de l'interne, mais permet également de comprendre le type de données).
La liste
D'un tableau à deux dimensions, soit une matrice, on peut passer à une liste (?base::list).
Code
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Cela entraîne plusieurs choses à la fois :
- La seconde dimension de la matrice se contracte, c'est-à-dire que nous obtenons simultanément à la fois une liste et un vecteur.
- La liste hérite donc de ces classes. Il faut garder à l'esprit qu'un élément de la liste correspondra à une seule valeur (scalaire) d'une cellule de la matrice-tableau.
Étant donné que la liste est également un vecteur, certaines fonctions pour vecteurs peuvent être appliquées à elle.
Dataframe
À partir d'une liste, d'une matrice ou d'un vecteur, on peut passer à un dataframe (?base::data.frame).
Code
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Ce qui est intéressant, c'est que le dataframe hérite de la liste ! Les colonnes du dataframe sont des cellules de la liste. Cela sera important plus tard, lorsque nous utiliserons des fonctions appliquées aux listes.
data.table
On peut obtenir un DT (?data.table::data.table) à partir d'un dataframe, d'une liste, d'un vecteur ou d'une matrice. Par exemple, comme ceci (in situ).
Code
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Ce qui est utile, c'est que, comme le dataframe, le DT hérite des propriétés de la liste.
DT et mémoire
Contrairement à tous les autres objets dans R base, les data.table sont passées par référence. Si vous devez copier dans un nouvel espace mémoire, utilisez la fonction data.table::copy ou vous devez faire une sélection à partir de l'ancien objet.
Code
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Avec cela, l'introduction touche à sa fin. Les data.table sont une extension du développement des structures de données dans R, qui se fait principalement par l'élargissement et l'accélération des opérations effectuées sur des objets de classe data.frame. L'héritage d'autres primitives est préservé.
Quelques exemples d'utilisation des caractéristiques de data.table
Comme une liste...
Itérer sur les lignes d'un data.frame ou d'une data.table n'est pas la meilleure idée, car le code de la boucle en R est considérablement plus lent, Cmais il est tout à fait possible de parcourir les colonnes, qui sont généralement beaucoup moins nombreuses. En passant par les colonnes, rappelons-nous que chaque colonne est un élément de liste, contenant généralement un vecteur. Les opérations sur les vecteurs sont bien vectorisées dans les fonctions de base du langage. Vous pouvez également utiliser des opérateurs de sélection, propres aux listes et vecteurs : `[[`, `$`.
Code
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vectorisation
S'il est nécessaire de parcourir les lignes d'une grande data.table, la meilleure solution sera d'écrire une fonction avec vectorisation. Mais si cela ne fonctionne pas, il convient de rappeler que la boucle à l'intérieur d'une data.table est tout de même plus rapide qu'une boucle en R, car elle s'exécute sur C.
Essayons sur un exemple plus important avec 100K lignes. Nous allons extraire la première lettre des mots contenus dans une colonne-vecteur w.
Mise à jour
Code
library(magrittr)
library(microbenchmark)

## Exemple plus grand ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorisation

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# troisième

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Premier passage avec itération sur les lignes :
Unité : millisecondes
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Seconde passe, où la vectorisation se fait par la transformation de la liste en matrice et la prise d'éléments au découpage avec l'indice 1 (c'est cela, en effet, la vectorisation). Je me corrige : vectorisation au niveau de la fonction. strsplit, qui peut accepter un vecteur en entrée. Il s'avère que la procédure de transformation d'une liste en matrice est beaucoup plus lourde que la vectorisation elle-même, mais dans ce cas, elle est aussi beaucoup plus rapide que la variante non vectorisée.
Unité : millisecondes
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Accélération par rapport à la médiane de 3 fois.
Troisième passe, où le schéma de transformation en matrice a été modifié.
Unité : millisecondes
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Accélération par rapport à la médiane de 13 fois.
Il faut expérimenter avec cela, plus on fait, mieux c'est.
Un autre exemple de vectorisation, où il y a aussi du texte, mais il est proche des conditions réelles : longueur différente des mots, nombre différents de mots. Il faut extraire les 3 premiers mots. Voici comment :
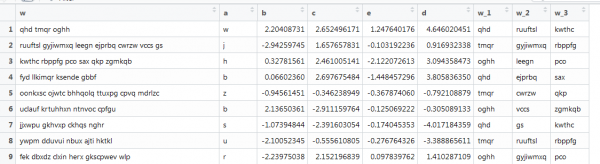
Ici, la fonction précédente ne fonctionne plus, car les vecteurs ont des longueurs différentes, et nous avions défini la taille de la matrice. Nous allons le refaire, en fouillant sur internet.
Code
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unité : millisecondes
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Le script a fonctionné avec une vitesse moyenne de 1 seconde. Pas mal.
Liés par une chaîne…
Avec les objets DT, on peut travailler en utilisant le chaining. Cela ressemble à l'attachement de la syntaxe de parenthèses à droite, en fait, c'est du sucre syntaxique.
Code
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Il coule dans les tuyaux…
Des opérations similaires peuvent être effectuées via le piping, cela semble similaire, mais est fonctionnellement plus riche, car on peut utiliser toutes les méthodes, pas seulement DT. Examinons les coefficients de régression logistique pour nos données synthétiques avec plusieurs filtres sur DT.
Code
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistiques, apprentissage automatique et autres à l'intérieur de DT
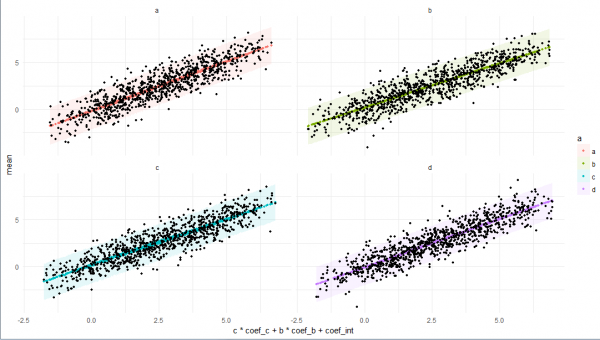
On peut utiliser des fonctions lambda, mais parfois il est préférable de les créer séparément, d'écrire tout le pipeline d'analyse de données, et en avant - elles fonctionnent à l'intérieur de DT. L'exemple est enrichi de toutes les fonctionnalités mentionnées ci-dessus, plus plusieurs éléments utiles de l'arsenal DT (tel que l'accès à DT à l'intérieur de DT par le lien, parfois inséré de manière non séquentielle, mais pour que cela soit bien).
Code
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Conclusion
J'espère avoir réussi à créer une image cohérente, même si elle n'est pas exhaustive, d'un objet tel que data.table, en partant de ses propriétés liées à l'héritage des classes R jusqu'à ses propres caractéristiques et son environnement d'éléments tidyverse. J'espère que cela vous aidera à mieux comprendre et à appliquer cette bibliothèque dans votre travail et divertissement.
Merci!
Code complet
Code
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Source : habr.com
