

Bonjour à tous. Voici la transcription .
– un système de surveillance de divers systèmes et services, qui permet aux administrateurs système de collecter des informations sur les paramètres actuels des systèmes et de configurer des alertes pour recevoir des notifications en cas d'anomalies dans le fonctionnement des systèmes.
La présentation comparera et — des projets pour le stockage à long terme des métriques Prometheus.
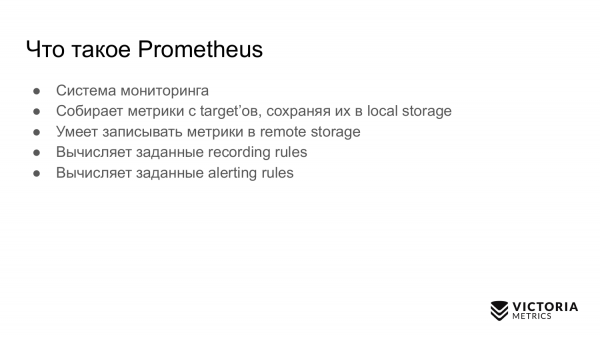
Je vais d'abord parler de Prometheus. C'est un système de surveillance qui collecte des métriques à partir de cibles définies et les stocke dans un stockage local. Prometheus peut enregistrer des métriques dans un stockage distant, générer des alertes et créer des règles d'enregistrement.
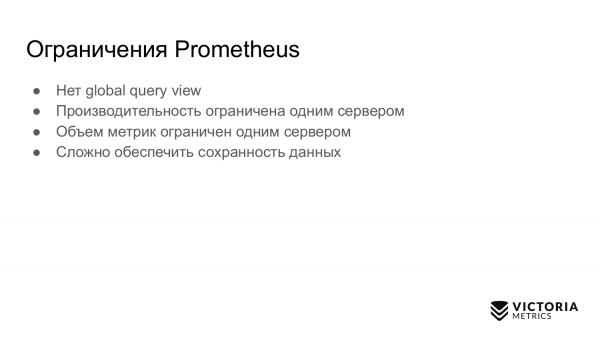
Limitations de Prometheus :
- Il n'a pas de vue de requête globale. C'est quand vous avez plusieurs instances indépendantes de Prometheus. Elles collectent des métriques. Et vous souhaitez interroger toutes ces métriques collectées à partir des différentes instances de Prometheus. Prometheus ne le permet pas.
- La performance de Prometheus est limitée à un seul serveur. Prometheus ne peut pas automatiquement se mettre à l'échelle sur plusieurs serveurs. Vous devez manuellement répartir vos cibles entre plusieurs Prometheus.
- Le volume de métriques dans Prometheus est limité à un seul serveur pour la même raison qu'il ne peut pas se mettre à l'échelle automatiquement sur plusieurs serveurs.
- Il n'est pas si facile d'organiser la sauvegarde des données dans Prometheus.
Quelles sont les solutions à ces problèmes / tâches ?
Les solutions sont les suivantes :
Toutes ces solutions visent le stockage distant des données collectées par Prometheus. Elles abordent le problème de stockage distant de la diapositive précédente de différentes manières. Dans cette présentation, je ne parlerai que des deux premières solutions : et .
Pour la première fois, des informations sur sont apparues dans . L'architecture y est décrite et comment cela fonctionne.
Thanos prend les données que Prometheus a sauvegardées sur le disque local et les copie dans S3, dans ou dans un autre stockage d'objets.
Ainsi, Thanos fournit une vue de requête globale. Vous pouvez interroger les données sauvegardées dans le stockage d'objets depuis plusieurs instances de Prometheus.
Thanos prend en charge PromQL et .
Thanos utilise le code de Prometheus pour le stockage des données.
Thanos est développé par les mêmes développeurs que Prometheus.
À propos de . Voici , où nous avons parlé pour la première fois de .
VictoriaMetrics obtient des données de plusieurs Prometheus via un protocole pris en charge par Prometheus.
VictoriaMetrics fournit une vue de requête globale, car plusieurs instances de Prometheus peuvent écrire des données dans une seule instance de VictoriaMetrics. Par conséquent, vous pouvez interroger toutes ces données.

VictoriaMetrics prend également en charge, tout comme Thanos, le PromQL et l'API de requête de Prometheus.
Contrairement à Thanos, le code source de VictoriaMetrics a été écrit de zéro et optimisé pour la vitesse et l'utilisation des ressources.
VictoriaMetrics, contrairement à Thanos, peut évoluer à la fois verticalement et horizontalement. Il y a , qui se développe verticalement. Vous pouvez commencer avec un processeur et 1 Go de RAM et progressivement augmenter jusqu'à une centaine de processeurs et 1 To de RAM. VictoriaMetrics peut utiliser toutes ces ressources. Sa performance augmentera d'environ 100 fois par rapport à un système à un cœur.
L'histoire de Thanos a commencé en novembre 2017, avec le premier commit public. Avant cela, Thanos a été développé en interne par la société .
En juin 2019, un lancement emblématique 0.5.0 a eu lieu, où a été supprimé. Il a été retiré de Thanos car il a montré des performances peu satisfaisantes. Souvent, le cluster Thanos ne fonctionnait pas correctement, les nœuds ne se connectant pas correctement en raison du protocole gossip. C'est pourquoi il a été décidé de l'enlever. Je pense que c'était la bonne décision.
Dans le même mois de juin 2019, ils ont soumis la demande numéro dans .
Et après quelques mois, Thanos a été accepté dans , qui comprend Prometheus, Kubernetes et d'autres projets populaires.
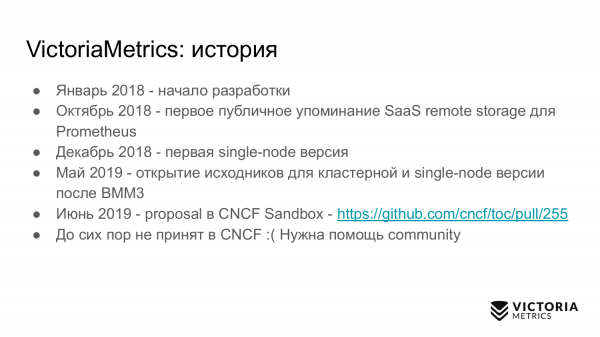
En janvier 2018, le développement de VictoriaMetrics a commencé.
En septembre 2018, j'ai mentionné VictoriaMetrics publiquement pour la première fois.
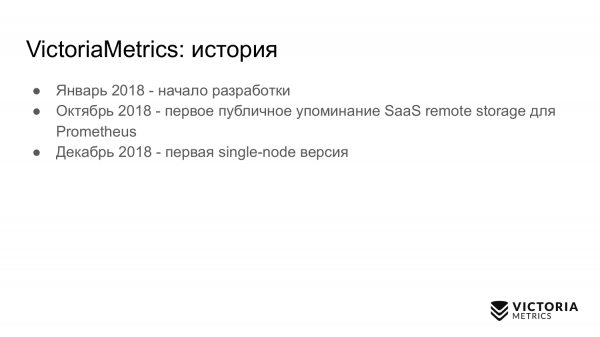
En décembre 2018, la version à nœud unique a été publiée.
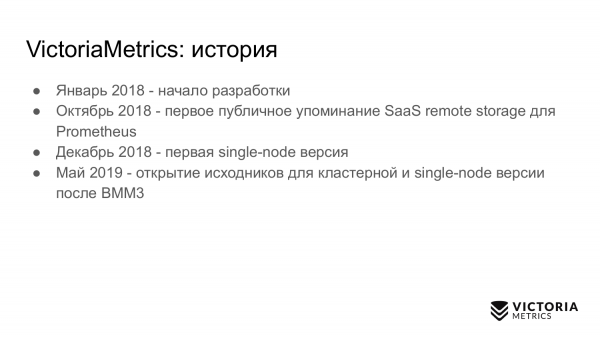
En mai 2019 En juin 2019, tout comme Thanos, nous avons soumis une demande à la fondation CNCF sous le numéro
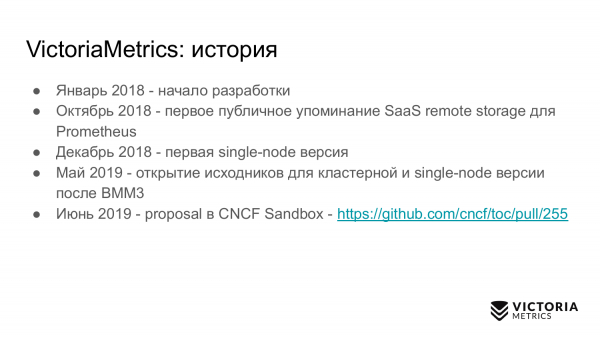
. Nous avons soumis notre demande un jour avant que Thanos ne soumette la sienne. Mais, malheureusement, nous n'avons toujours pas été acceptés. Nous avons besoin de l'aide de la communauté.
Examinons les diapositives les plus importantes montrant l'architecture de Thanos et VictoriaMetrics.
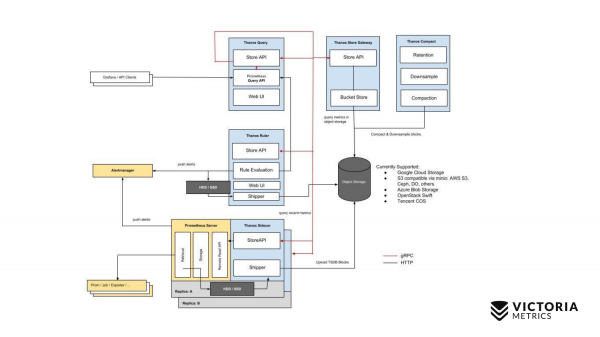
Commençons par Thanos. Les composants jaunes sont des composants de Prometheus. Tout le reste est des composants de Thanos. Commençons par le composant le plus important. Thanos Sidecar est le composant qui s'installe à côté de chaque Prometheus. Il s'occupe de charger les données de Prometheus du stockage local vers S3 ou un autre stockage d'objets.
VictoriaMetrics fournit une vue de requête globale, car plusieurs instances de Prometheus peuvent écrire des données dans une seule instance de VictoriaMetrics. Par conséquent, vous pouvez interroger toutes ces données.
Il existe également un composant appelé Thanos Store Gateway, capable de lire ces données à partir de l'Object Storage lors des requêtes entrantes de Thanos Query. Thanos Query implémente PromQL et l'API Prometheus. Autrement dit, il se présente à l'extérieur comme Prometheus. Il accepte les requêtes PromQL, les envoie au Thanos Store Gateway, qui extrait les données nécessaires de l'Object Storage et les renvoie.
Cependant, dans notre Object Storage, nous stockons des données sans les deux dernières heures en raison des particularités de l'implémentation de Thanos Sidecar, qui ne peut pas charger les deux dernières heures dans l'Object Storage S3, car pour ces deux dernières heures, Prometheus n'a pas encore créé de fichiers dans le stockage local.
Comment contourner ce problème ? Thanos Query, en plus d'envoyer des requêtes au Thanos Store Gateway, envoie parallèlement des requêtes à chaque Thanos Sidecar situé à proximité de Prometheus.
Et Thanos Sidecar, à son tour, relaye les requêtes vers Prometheus et extrait les données des deux dernières heures.
En plus de ces composants, il y a un autre composant optionnel sans lequel Thanos fonctionnerait mal. C'est Thanos Compact, qui s'occupe de la fusion de petits fichiers dans l'Object Storage en fichiers plus volumineux, qui ont été chargés ici par les Thanos Sidecars. Thanos Sidecar charge des fichiers contenant des données pour une période de deux heures. Si ces fichiers ne sont pas fusionnés en fichiers plus volumineux, leur nombre peut augmenter de manière significative. Plus il y a de tels fichiers, plus il faut de mémoire pour Thanos Store Gateway, et plus les ressources nécessaires pour le transfert de données sur le réseau et les métadonnées augmentent. Le fonctionnement de Thanos Store Gateway devient inefficace. C'est pourquoi il est impératif de lancer Thanos Compact, qui fusionne les petits fichiers en fichiers plus volumineux, afin de réduire leur nombre et de diminuer la surcharge sur Thanos Store Gateway.
Il y a également un composant appelé Thanos Ruler. Il exécute les règles d'alerte de Prometheus et peut calculer les règles d'enregistrement de Prometheus pour enregistrer à nouveau des données dans l'Object Storage. Cependant, il n'est pas recommandé d'utiliser ce composant, car il .
Voilà à quoi ressemble le schéma simple de Thanos.
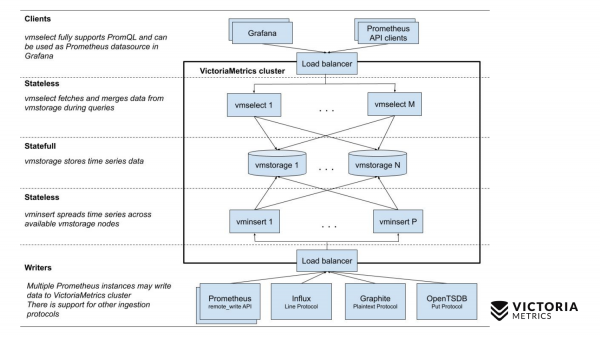
Comparons maintenant avec le schéma de VictoriaMetrics.
VictoriaMetrics propose 2 versions : une version Single-node et une version cluster. La version Single-node fonctionne sur un seul ordinateur. Dans la version Single-node, il n'y a pas ces composants, juste un binaire unique. Ce binaire apparaît dans la diapositive sous la forme de ce carré. Tout ce qui se trouve à l'intérieur du carré représente le contenu du fichier binaire de la version Single-node. Vous n'avez pas besoin de vous en soucier. Il vous suffit de lancer le binaire — et tout fonctionne.
La version cluster est plus complexe. Elle comprend trois composants différents : vmselect, vminsert et vmstorage. Leurs noms indiquent clairement leurs fonctions respectives. Le composant Insert reçoit des données dans différents formats : via l'API remote write de Prometheus, le protocole line d'Influx, le protocole Graphite et celui d'OpenTSDB. Le composant Insert les reçoit, les analyse et les répartit entre les composants de stockage existants où les données sont ensuite conservées. Le composant Select, quant à lui, prend des requêtes en PromQL. Il implémente , ainsi que l'API de requêtes de Prometheus, et peut être utilisé comme une alternative à Prometheus dans Grafana ou d'autres clients API de Prometheus. Select prend une requête promql, l'analyse, lit les données nécessaires pour effectuer cette requête à partir des nœuds de stockage, les traite et renvoie la réponse.
Comparons la complexité d'installation de Thanos et de VictoriaMetrics.
Commençons par Thanos. Avant de commencer à utiliser Thanos, il faut créer un bucket dans un stockage d'objets, tel que S3 ou GCS, afin que le Thanos Sidecar puisse y enregistrer des données.
Ensuite, pour chaque instance de Prometheus, il est nécessaire d'installer le Thanos Sidecar. Il ne faut pas oublier de désactiver la compression des données dans Prometheus. La compression des données compresse périodiquement les données dans le stockage local de Prometheus pour réduire la consommation de ressources.
Lorsque vous installez le Thanos Sidecar sur vos instances de Prometheus, vous devez désactiver cette compression des données, car le Thanos Sidecar ne fonctionne pas correctement lorsque la compression des données est activée. Cela signifie que votre Prometheus commence à enregistrer des données par blocs de deux heures et cesse de fusionner ces blocs en plus gros. Par conséquent, si vous effectuez des requêtes dépassant la durée des deux dernières heures, elles ne fonctionneront pas aussi efficacement que si la compression des données était activée.
C'est pourquoi Thanos recommande de réduire la durée de conservation des données dans le stockage local à 6-8 heures afin de diminuer cette surcharge de nombreux petits blocs.
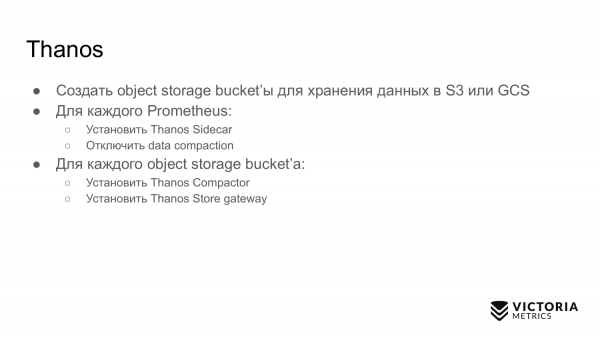
Après avoir installé le Thanos Sidecar, vous devez installer deux composants pour chaque bucket de stockage d'objets. Ce sont Thanos Compactor et Thanos Store Gateway.
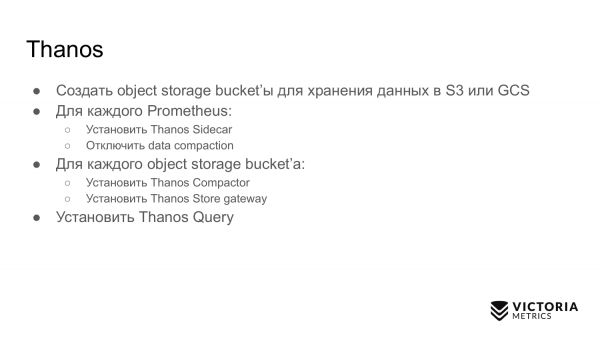
Après cela, il est nécessaire d'installer Thanos Query et de le configurer pour qu'il puisse se connecter à tous les Thanos Store Gateway disponibles, ainsi qu'à tous les Thanos Sidecar.
Il peut y avoir un petit problème ici.
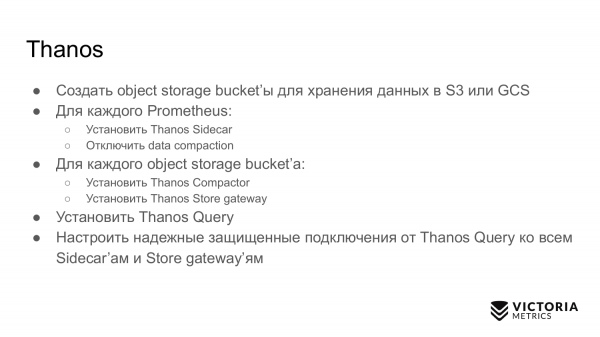
Vous devez configurer une connexion fiable et sécurisée de Thanos Query à ces composants. Si vous avez des Prometheus situés dans différents centres de données ou dans des VPC distincts, les connexions externes y sont interdites. Cependant, pour faire fonctionner Thanos Query, vous devez trouver un moyen d'établir cette connexion.
Si vous avez de nombreux centres de données, la fiabilité de l'ensemble du système en souffre. Thanos Query doit maintenir des connexions avec tous les Thanos Sidecar situés dans différents centres de données. À chaque requête entrante, il enverra des requêtes à tous les Thanos Sidecar. Si la connexion est interrompue, vous obtiendrez soit un ensemble de données incomplet, soit un message disant que le « cluster ne fonctionne pas ».
Avec VictoriaMetrics, c'est un peu plus simple. Pour la version à nœud unique, il suffit de lancer un binaire et tout fonctionne.
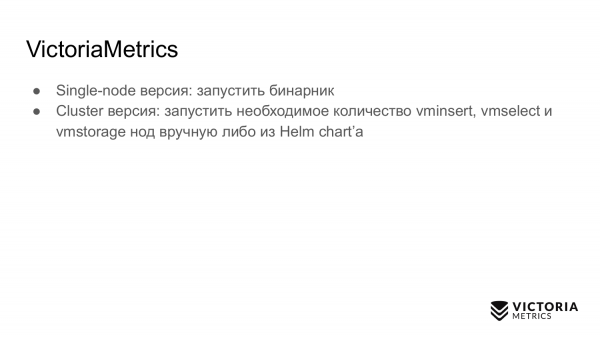
Pour la version en cluster, il suffit de lancer les trois types de composants mentionnés ci-dessus en quantités nécessaires ou d'utiliser pour automatiser le lancement des composants dans Kubernetes. Nous prévoyons également de créer un opérateur Kubernetes. Le helm chart ne couvre pas certains cas et peut vous causer des problèmes. Par exemple, il permet de réduire le nombre de nœuds de stockage, ce qui entraîne une perte de données.
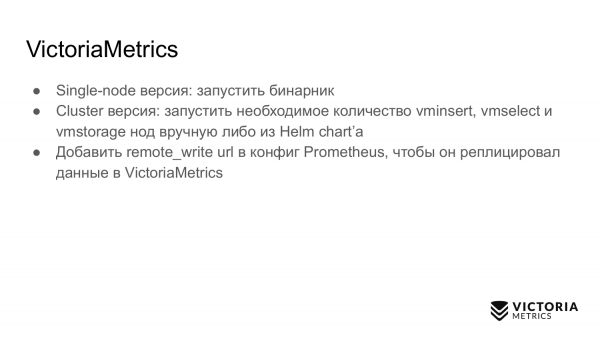
Après avoir lancé un binaire ou la version en cluster, il vous suffit d'ajouter à la configuration de Prometheus , afin qu'il commence à enregistrer les données à la fois dans le stockage local et dans le stockage distant. Comme vous l'avez remarqué, cette configuration doit être beaucoup plus fiable par rapport à la configuration Thanos. Nous n'avons pas besoin de maintenir une connexion de VictoriaMetrics à tous les Prometheus, car les Prometheus se connectent eux-mêmes à VictoriaMetrics et transmettent les données.
Examinons la prise en charge de Thanos et de VictoriaMetrics.
Thanos doit surveiller Sidecar pour s'assurer qu'il continue de charger les données dans l'Object Storage. Il peut arrêter ce chargement en raison d'erreurs de téléchargement, par exemple si votre connexion réseau à l'Object Storage est temporairement interrompue ou si l'Object Storage devient temporairement indisponible. À ce moment-là, Thanos Sidecar le remarquera, signalera l'erreur, peut se fermer et ensuite cesser de fonctionner. Si vous ne le surveillez pas, les données cesseront d'être transmises à l'Object Storage. Si le temps de rétention (6 à 8 heures recommandé) s'écoule, vous perdrez les données qui n'ont pas été transférées dans l'Object Storage.
Les compresseurs Thanos peuvent cesser de fonctionner en raison de Les compresseurs prennent des données de l'Object Storage et les fusionnent en morceaux de données plus volumineux. Comme les compresseurs ne sont pas synchronisés avec les Sidecars, il peut se produire ce qui suit : le Sidecar n'a pas encore fini d'écrire un bloc, le Compactor décide que ce bloc est complètement écrit. Le Compactor commence à le lire. Il lit le bloc de manière incomplète et cesse de fonctionner. Voir les détails. .
Le Store Gateway peut renvoyer des données inconsistantes en raison des courses entre le Compactor et les Sidecars. C'est le même problème puisque le Store Gateway n'est pas synchronisé avec les Compactors et les Sidecars. Par conséquent, des conditions de course peuvent se produire lorsque le Store Gateway ne voit pas certaines données, ou voit des données supplémentaires.
Le composant Query dans Thanos renvoie par défaut un résultat partiel si certains Sidecars ou le Store Gateway ne sont pas disponibles à ce moment-là. Vous obtiendrez une partie des données et ne saurez même pas que vous n'avez pas reçu toutes les données. C'est ainsi qu'il fonctionne par défaut. Dans une situation similaire, VictoriaMetrics retourne les données marquées comme partielles.
Contrairement à Thanos, VictoriaMetrics perd rarement des données. Même si la connexion de Prometheus à VictoriaMetrics est interrompue, ce n'est pas un problème, car Prometheus continue d'écrire les nouvelles données entrantes dans le Write Ahead Log, dont la taille est de 2 heures. Si vous restaurez la connexion à VictoriaMetrics dans les deux heures, les données ne seront pas perdues. Prometheus .
Contrairement à Thanos, qui enregistre les données dans un stockage d'objets seulement après deux heures, Prometheus réplique automatiquement les données via le protocole remote write dans un stockage distant, tel que VictoriaMetrics. Vous n'avez pas à craindre la perte de stockage local dans Prometheus. Si jamais il perd le stockage local, vous ne perdrez au pire que les dernières secondes de données qui n'ont pas eu le temps d'être enregistrées dans le stockage distant.
Kubernetes gère automatiquement le cluster contrairement à Thanos. Tous les composants de Thanos sont difficiles à placer dans un seul cluster Kubernetes, à la différence des composants cluster de VictoriaMetrics.
La mise à jour vers une nouvelle version de VictoriaMetrics est très simple. Il suffit d'arrêter VictoriaMetrics, de mettre à jour les binaires et de relancer. Lors de l'arrêt via le signal SIGINT, tous les binaires de VictoriaMetrics effectuent un arrêt en douceur. Ils sauvegardent correctement les données nécessaires et ferment correctement les connexions entrantes pour ne rien perdre. Vous ne perdrez donc rien lors de la mise à jour.
Il est très simple d'étendre le cluster de VictoriaMetrics. Il suffit d'ajouter les composants nécessaires et de continuer à travailler.
À propos des écueils dans Thanos et VictoriaMetrics.
Thanos a plusieurs écueils. Prometheus doit conserver les données des deux dernières heures. Si elles sont perdues, vous les perdez complètement, car elles n'ont pas encore eu le temps d'être enregistrées dans un stockage d'objets tel que S3.
Le composant Store Gateway et le composant compactor peuvent nécessiter beaucoup de mémoire pour travailler avec un grand stockage d'objets s'il y a de nombreux petits fichiers. Plus le nombre et le volume de fichiers sont élevés, plus la mémoire vive requise par Store Gateway et compactor pour stocker les méta-informations est importante. Thanos a de nombreux problèmes concernant cela. .
Thanos se vantent qu'il peut se développer indéfiniment en fonction de vos Prometheus. En réalité, c'est faux. Toutes les requêtes passent par le composant Query, qui doit interroger en parallèle tous les composants Store Gateway et tous les composants Sidecar, extraire les données et ensuite les prétraiter. Évidemment, la vitesse des requêtes est limitée par le maillon le plus faible, que ce soit le Store Gateway le plus lent ou le Sidecar le plus lent.
Ces composants peuvent être soutenus de manière inégale. Par exemple, vous avez un Prometheus qui collecte des millions de métriques par seconde. Et il y a un Prometheus qui en collecte des milliers par seconde. Prometheus, qui collecte des millions de métriques par seconde, sollicite beaucoup plus le serveur sur lequel il fonctionne. Par conséquent, le Sidecar fonctionne plus lentement. Et en général, tout fonctionne plus lentement là-bas. Le composant de requête extraira les données très lentement. Par conséquent, les performances de l'ensemble de votre cluster seront limitées par ce Sidecar lent.
Par défaut, Thanos fournit des données partielles si certains Sidecars ou Store Gateway ne sont pas disponibles. Par exemple, si vos Sidecars sont dispersés à travers le monde dans différents centres de données, la probabilité de coupure de connexion et d'indisponibilité des composants augmente considérablement. Par conséquent, dans la plupart des cas, vous recevrez des données partielles, même sans le savoir.
VictoriaMetrics a aussi ses pièges. Le premier piège est une option qui limite la quantité de mémoire vive utilisée par le cache de VictoriaMetrics. Par défaut, elle est fixée à 60 % de la mémoire vive de la machine sur laquelle VictoriaMetrics est exécuté ou 60 % de la RAM du pod VictoriaMetrics dans Kubernetes.
Si vous modifiez incorrectement cette valeur, vous pouvez nuire aux performances de VictoriaMetrics. Par exemple, si vous définissez une valeur trop basse, les données peuvent ne plus entrer dans le cache de VictoriaMetrics. Cela entraînera un travail supplémentaire pour le processeur et le disque. Si vous rendez cette option trop grande, cela augmente, d'une part, la probabilité que VictoriaMetrics rencontre une erreur de mémoire insuffisante, et, d'autre part, cela laissera très peu de mémoire vive pour le cache de fichiers dans le système d'exploitation. Or, VictoriaMetrics dépend de ce cache de fichiers pour ses performances. S'il est insuffisant, cela peut considérablement augmenter la charge sur le disque. Donc, conseil : ne modifiez pas ce paramètre sans nécessité absolue.
La deuxième option. C'est le retentionPeriod – période, qui est par défaut fixée à 1 mois. C'est le temps pendant lequel VictoriaMetrics conserve les données. À l'expiration de ce délai, VictoriaMetrics supprime les données.
Beaucoup lancent VictoriaMetrics sans ce paramètre et enregistrent des données pendant un mois. Puis ils se demandent : pourquoi les données ont-elles disparu le mois précédent ? Parce que le retentionPeriod par défaut est de 1 mois. Il est donc crucial de connaître et d'établir un bon retentionPeriod.
Passons en revue les possibilités uniques.
Thanos possède une fonctionnalité appelée downsampling : des intervalles de 5 minutes et horaires, qui souvent . Si on recherche sur Google et qu'on regarde leurs problèmes sur GitHub, il y a beaucoup d'issues liées à ce downsampling, qui ne fonctionne parfois pas comme prévu ou ne fonctionne pas comme les utilisateurs s'y attendent.
Thanos propose une déduplication des données pour les paires HA de Prometheus. Lorsque deux instances de Prometheus collectent les mêmes métriques des mêmes cibles, Thanos les stocke dans un Object Storage. Thanos déduplique correctement ces données, contrairement à VictoriaMetrics.
Thanos a un composant d'alerte, qui était sur le schéma de Thanos. Mais il .
L'avantage de Thanos est que le code de Thanos et de Prometheus est commun. Thanos et Prometheus ont été développés par les mêmes développeurs. Lors des améliorations dans Thanos ou Prometheus, l'autre partie en bénéficie également.
La principale fonctionnalité de VictoriaMetrics est MetricsQL. C'est une extension de VictoriaMetrics pour PromQL, dont j'ai parlé lors du dernier grand meetup sur le monitoring.
VictoriaMetrics supporte l'injection de données via de nombreux protocoles différents. VictoriaMetrics peut non seulement recevoir des données de Prometheus, mais aussi via les protocoles Influx, OpenTSDB et Graphite.
Les données de VictoriaMetrics occupent généralement beaucoup moins d'espace par rapport à Thanos et Prometheus.
Lorsque vous enregistrez des données réelles, les utilisateurs parlent d'une réduction de 2 à 5 fois de la taille des données sur disque par rapport à Prometheus et Thanos.
Un autre avantage de VictoriaMetrics est qu'elle est optimisée pour la vitesse.
Passons en revue le coût de l'infrastructure.
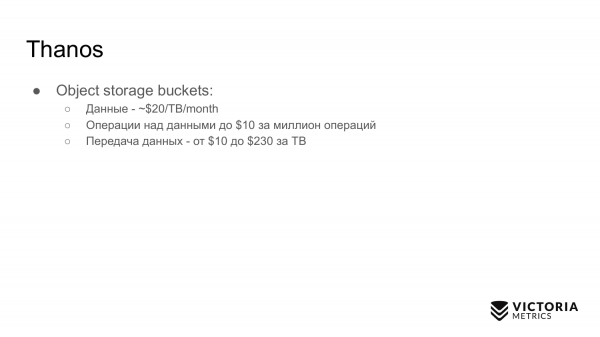
Un des avantages de Thanos est qu'il stocke les données dans des object storages, qui sont relativement bon marché.
Lorsqu'il s'agit de stocker des données dans un object storage, vous devez payer pour les opérations d'écriture et de lecture des données (10 $ par million d'opérations). Lorsque vous écrivez des données dans un object storage, vous en payez les frais d'hébergement pour le téléchargement des données sur Internet, si votre cluster n'est pas dans AWS — là-bas, c'est gratuit. Lorsque vous lisez des données, vous payez entre 10 et 230 $ pour 1 To. Cela peut être significatif si vous demandez souvent des données historiques à partir du cluster Thanos.
Pour le cluster Thanos, il est nécessaire de payer pour des serveurs pour les composants Compact, Store Gateway et Query, qui nécessitent beaucoup de mémoire et de CPU pour de grands volumes de données.
Pour VictoriaMetrics, les coûts sont les suivants. Si les données sont stockées sur des disques GCE HDD, cela revient à 40 $ par To. Pour VictoriaMetrics, des disques HDD ordinaires suffisent, il n'est pas nécessaire d'utiliser des SSD, qui coûtent cinq fois plus cher. VictoriaMetrics est optimisée pour les HDD.
Pour VictoriaMetrics, des serveurs sont nécessaires pour les composants : soit Single-node, soit pour des composants en cluster, qui, contrairement aux composants Thanos, nécessitent beaucoup moins de CPU et de RAM, ce qui sera donc moins cher.
Exemples d'implémentation.
Un exemple d'implémentation de Thanos est Gitlab. Gitlab fonctionne entièrement sur Thanos. Mais tout n'est pas si simple. Si l'on regarde leurs , on peut voir qu'ils rencontrent constamment des : ils manquent de mémoire pour les composants Store Gateway ou Query. Ils doivent constamment augmenter la mémoire.
Cela augmente les coûts pour résoudre ces problèmes.
Une deuxième implémentation, qui pourrait être plus réussie, est l'entreprise Improbable, qui a commencé le développement de Thanos. Ils ont publié le code source de Thanos. Improbable est une entreprise spécialisée dans le développement de moteurs de jeu.
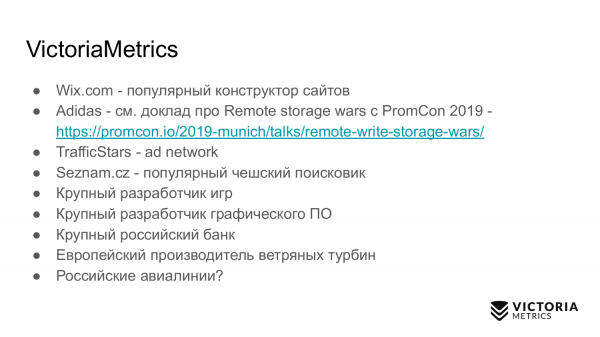
Les exemples publics d'implémentation de VictoriaMetrics sont :
- wix.com, un constructeur de sites web
- Adidas implémente VictoriaMetrics et a même fait une présentation lors du dernier PromCon 2019
- TrafficStars — réseau publicitaire
- Seznam.cz — un moteur de recherche tchèque populaire.
Et ensuite, il y a des entreprises inconnues que je ne peux pas nommer pour le moment. Elles n'ont pas donné leur accord.
- Un grand développeur de jeux. Plus grand qu'Improbable.
- Un important développeur de logiciels graphiques.
- Une grande banque russe.
- Un fabricant européen d'éoliennes qui a réussi à tester VictoriaMetrics. Ce fabricant implémente VictoriaMetrics pour le suivi des données reçues des éoliennes avec une vitesse de 50 échantillons par seconde pour chaque capteur. Chaque éolienne a plusieurs centaines de capteurs. Ils ont plusieurs centaines d'éoliennes.
- Les lignes aériennes russes qui souhaitent implémenter VictoriaMetrics, mais n'y parviennent pas. Nous sommes en phase de contrat avec eux.
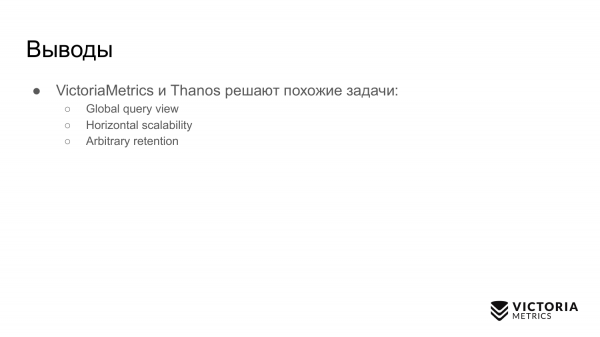 Conclusions.
VictoriaMetrics et Thanos résolvent des problèmes similaires, mais de manières différentes :
- Vue de requête globale
- mise à l'échelle horizontale
- rétention arbitraire
Merci.
Nous vous attendons sur notre .
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Quel est votre stockage à long terme pour Prometheus ?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%autre4
17 utilisateurs ont voté. 16 utilisateurs se sont abstenus.
Source : habr.com
