

Bonjour, je crée des applications pour les bases de données. — c'est une plateforme développée par Mail.ru Group, combinant une base de données hautes performances et un serveur d'applications en Lua. La rapidité des solutions basées sur Tarantool est notamment due à la prise en charge du mode in-memory de la base de données et à la possibilité d'exécuter la logique métier de l'application dans le même espace d'adresses que les données. La persistance des données est garantie par des transactions ACID (un journal WAL est maintenu sur disque). Tarantool intègre un support de réplication et de sharding. À partir de la version 2.1, des requêtes en SQL sont prises en charge. Tarantool est open source et distribué sous une licence BSD simplifiée. Il existe également une version commerciale Enterprise.
Ressentez la puissance ! (…ou plutôt, profitez de la performance)
Tout cela fait de Tarantool une plateforme attrayante pour la création d'applications fortement sollicitées fonctionnant avec des bases de données. Dans de telles applications, il est souvent nécessaire de répliquer des données.
Comme mentionné précédemment, Tarantool dispose d'une réplication de données intégrée. Son principe de fonctionnement consiste à exécuter séquentiellement sur les répliques toutes les transactions contenues dans le journal principal (WAL). En général, cette réplication (que nous appellerons de bas niveau) est utilisée pour assurer la résilience de l'application et/ou pour répartir la charge de lecture entre les nœuds du cluster.
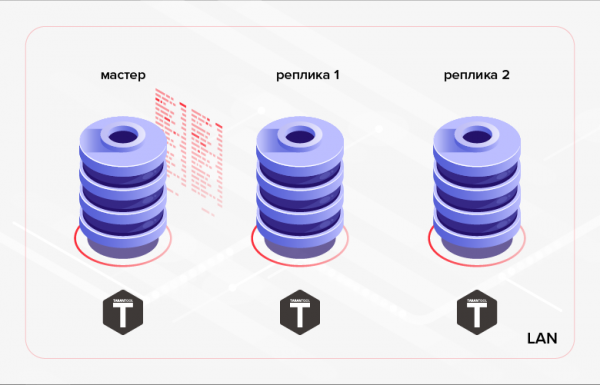
Fig. 1. Réplication à l'intérieur du cluster
Un exemple de scénario alternatif pourrait être le transfert de données créées dans une base de données vers une autre base de données pour traitement/suivi. Dans ce dernier cas, une solution plus pratique pourrait être d'utiliser de haut niveau la réplication — la réplication de données au niveau de la logique métier de l'application. C'est-à-dire que nous n'utilisons pas une solution prête à l'emploi intégrée à la base de données, mais que nous mettons en œuvre nous-mêmes la réplication à l'intérieur de l'application que nous développons. Cette approche a ses avantages et ses inconvénients. Énumérons les points positifs.
1. Économie de trafic :
- il est possible de transmettre non pas toutes les données, mais seulement une partie (par exemple, on peut transmettre uniquement certaines tables, certains de leurs colonnes ou des enregistrements correspondant à certains critères);
- Contrairement à la réplication de bas niveau, qui s'effectue en continu en mode asynchrone (réalisé dans la version actuelle de Tarantool - 1.10) ou synchrone (qui sera réalisé dans les versions ultérieures de Tarantool), la réplication de haut niveau peut être exécutée par sessions (c'est-à-dire que l'application effectue d'abord la synchronisation des données - session d'échange de données, puis il y a une pause dans la réplication, après quoi la prochaine session d'échange a lieu, etc.).
- Si l'enregistrement a été modifié plusieurs fois, seule sa dernière version peut être transmise (contrairement à la réplication de bas niveau, où les modifications effectuées sur le maître seront reproduites successivement sur les répliques).
2. Aucune complexité dans la mise en œuvre de l'échange par HTTP, ce qui permet de synchroniser des bases de données distantes.
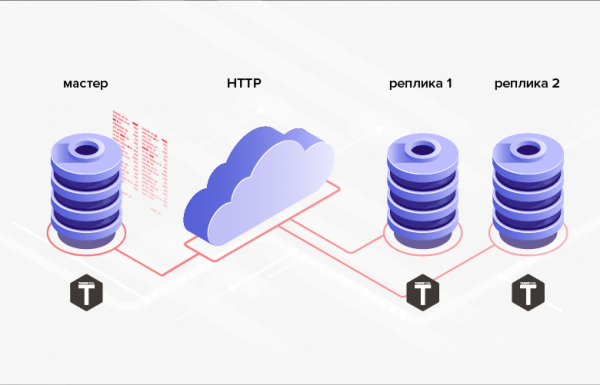
Fig. 2. Réplication par HTTP
3. Les structures des bases de données entre lesquelles les données sont transmises n'ont pas besoin d'être identiques (de plus, en général, il est même possible d'utiliser différentes SGBD, langages de programmation, plates-formes, etc.).
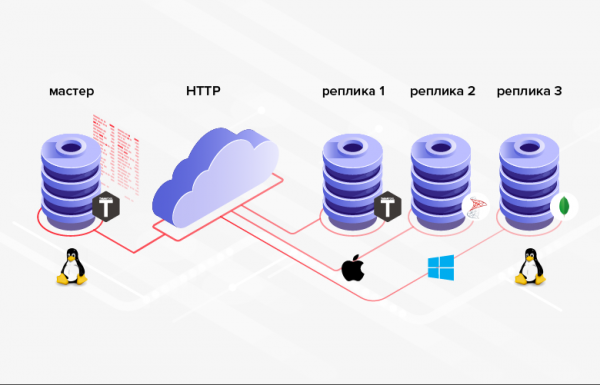
Fig. 3. Réplication dans des systèmes hétérogènes
L'inconvénient est qu'en moyenne, la programmation est plus complexe/coûteuse que la configuration, et au lieu de configurer une fonctionnalité intégrée, il faudra réaliser la sienne.
Si dans votre situation, les avantages mentionnés sont décisifs (ou sont une condition nécessaire), il est judicieux d'utiliser la réplication de haut niveau. Examinons plusieurs méthodes pour réaliser la réplication de données de haut niveau dans le SGBD Tarantool.
Minimiser le trafic
Ainsi, l'un des avantages de la réplication de haut niveau est l'économie de trafic. Pour que cet avantage se manifeste pleinement, il est nécessaire de minimiser la quantité de données transmises à chaque session d'échange. Évidemment, il ne faut pas oublier qu'à la fin de la session, le récepteur des données doit être synchronisé avec la source (au moins pour la partie des données qui participe à la réplication).
Comment minimiser la quantité de données transmises lors de la réplication de haut niveau ? Une solution « directe » pourrait être de sélectionner des données par date-heure. Pour cela, on peut utiliser le champ date-heure déjà présent dans la table (s'il existe). Par exemple, un document « commande » peut avoir un champ « temps d'exécution requis de la commande » - temps_de_livraison. Le problème avec cette solution réside dans le fait que les valeurs de ce champ ne doivent pas nécessairement être organisées dans un ordre correspondant à la création des commandes. Ainsi, nous ne pouvons pas mémoriser la valeur maximale du champ temps_de_livraison, transmise lors de la session précédente d'échange, et lors de la prochaine session d'échange, sélectionner tous les enregistrements avec une valeur de champ plus élevée temps_de_livraison. Entre les sessions d'échange, des enregistrements avec une valeur de champ inférieure peuvent avoir été ajoutés temps_de_livraison. De plus, la commande a pu subir des modifications, qui néanmoins n'ont pas affecté le champ temps_de_livraison. Dans les deux cas, les modifications ne seront pas transmises de la source vers le récepteur. Pour résoudre ces problèmes, nous devrons transmettre les données « en superposition ». C'est-à-dire qu'à chaque session d'échange, nous allons transmettre toutes les données ayant une valeur de champ temps_de_livraison, dépassant un certain moment dans le passé (par exemple, N heures à partir du moment actuel). Toutefois, il est évident que pour les systèmes de grande taille, cette approche est considérablement redondante et peut annuler l'économie de trafic que nous visons. En outre, il se peut qu'il n'y ait pas de champ associé à la date-heure dans le tableau transmis.
Une autre solution, plus complexe en termes de mise en œuvre, consiste à confirmer la réception des données. Dans ce cas, à chaque session d'échange, toutes les données dont la réception n'est pas confirmée par le récepteur sont transmises. Pour cela, il sera nécessaire d'ajouter une colonne booléenne dans la table source (par exemple, est_transféré). Si le récepteur confirme la réception de l'enregistrement, le champ correspondant prend la valeur true, après quoi l'enregistrement ne participe plus aux échanges. Cette variante de mise en œuvre présente les inconvénients suivants. Tout d'abord, il est nécessaire de générer et d'envoyer une confirmation pour chaque enregistrement transmis. Grosso modo, cela pourrait être comparable à un doublement de la quantité de données transmises et entraîner un doublement du nombre de tours aller-retour. Deuxièmement, il n'est pas possible d'envoyer le même enregistrement à plusieurs récepteurs (le premier récepteur ayant reçu l'enregistrement confirmera la réception pour lui-même et pour tous les autres).
Une méthode, dépourvue des défauts mentionnés ci-dessus, consiste à ajouter une colonne dans la table transférée pour suivre les modifications de ses lignes. Cette colonne peut avoir un type date-heure et doit être définie/mise à jour par l'application à l'heure actuelle chaque fois qu'une entrée est ajoutée/modifiée (de manière atomique avec l'ajout/modification). Prenons par exemple la colonne update_time. En conservant la valeur maximale de ce champ pour les enregistrements transmis, nous pourrons commencer la prochaine session d'échange à partir de cette valeur (sélectionner les enregistrements avec une valeur de champ update_time, supérieure à la valeur précédemment conservée). Le problème lié à la dernière approche est que les modifications de données peuvent se produire en mode batch. Par conséquent, les valeurs des champs dans la colonne update_time peuvent ne pas être uniques. Ainsi, cette colonne ne peut pas être utilisée pour une remise de données par lots (pagination). Pour la remise de données par lots, il sera nécessaire d'inventer des mécanismes supplémentaires, qui, très probablement, auront une efficacité très faible (par exemple, extraire de la base de données tous les enregistrements avec une valeur update_time supérieure à un seuil donné et fournir un certain nombre d'enregistrements, à partir d'un certain décalage depuis le début de l'échantillon).
Nous pouvons améliorer l'efficacité du transfert de données en perfectionnant légèrement l'approche précédente. Pour cela, nous utiliserons un type entier (long entier) comme valeur des champs de la colonne pour suivre les modifications. Appelons cette colonne row_ver. La valeur de ce champ doit encore être définie/mise à jour chaque fois qu'un enregistrement est créé/modifié. Mais dans ce cas, le champ ne sera pas attribué à la date-heure actuelle, mais plutôt à la valeur d'un certain compteur, augmentée de un. En conséquence, la colonne row_ver contiendra des valeurs uniques et pourra être utilisée non seulement pour fournir un "delta" de données (données ajoutées/modifiées après la fin de la session d'échange précédente), mais aussi pour une division simple et efficace en pages.
La dernière méthode proposée pour minimiser la quantité de données transférées dans le cadre de la réplication de haut niveau me semble la plus optimale et universelle. Arrêtons-nous plus en détail sur ce point.
Transfert de données utilisant un compteur de versions de lignes.
Mise en œuvre de la partie serveur/master
Dans MS SQL Server, il existe un type de colonne spécial pour mettre en œuvre une approche similaire — rowversion. Chaque base de données a un compteur qui s'incrémente à chaque ajout/modification d'enregistrement dans une table ayant une colonne de type rowversion. La valeur de ce compteur est automatiquement attribuée au champ de cette colonne dans l'enregistrement ajouté/modifié. La base de données Tarantool n'a pas de mécanisme intégré similaire. Cependant, il est facile de le mettre en œuvre manuellement dans Tarantool. Voyons comment faire.
Pour commencer, un peu de terminologie : les tables dans Tarantool sont appelées espaces (space), et les enregistrements sont des tuples (tuple). Dans Tarantool, on peut créer des séquences (sequence). Les séquences ne sont rien d'autre que des générateurs nommés de valeurs entières ordonnées. C'est exactement ce dont nous avons besoin pour nos objectifs. Ci-dessous, nous allons créer une telle séquence.
Avant d'effectuer une opération sur la base de données dans Tarantool, il faut exécuter la commande suivante :
box.cfg{}À la suite de cela, Tarantool commencera à enregistrer des instantanés de la base de données (snapshot) et des journaux de transactions dans le répertoire actuel.
Créons une séquence row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
L'option if_not_exists permet d'exécuter le script de création plusieurs fois : si l'objet existe, Tarantool ne tentera pas de le créer à nouveau. Cette option sera utilisée dans toutes les prochaines commandes DDL.
Créons un espace pour l'exemple.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Ici, nous avons défini le nom de l'espace (goods), les noms des champs et leurs types.
Les champs auto-incrémentés dans Tarantool sont également créés à l'aide de séquences. Créons une clé primaire auto-incrémentée basée sur le champ id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool prend en charge plusieurs types d'index. Les types d'index les plus couramment utilisés sont les index de type TREE et HASH, basés sur les structures correspondant à leur nom. TREE est le type d'index le plus polyvalent. Il permet d'extraire des données de manière ordonnée. En revanche, pour les sélections par égalité, HASH est plus approprié. Par conséquent, il est judicieux d'utiliser HASH pour la clé primaire (ce que nous avons fait).
Pour utiliser la colonne row_ver pour transmettre les données modifiées, il est nécessaire de lier aux champs de cette colonne les valeurs de la séquence row_ver. Mais contrairement à la clé primaire, la valeur du champ de la colonne row_ver doit augmenter d'une unité non seulement lors de l'ajout de nouveaux enregistrements, mais aussi lors de la modification des enregistrements existants. Pour cela, des déclencheurs peuvent être utilisés. Dans Tarantool, il existe deux types de déclencheurs pour les espaces : before_replace et on_replace. Les déclencheurs s'exécutent à chaque modification des données dans l'espace (pour chaque tuple affecté par les modifications, la fonction du déclencheur est exécutée). Contrairement à on_replace, before_replace- les déclencheurs permettent de modifier les données du tuple pour lequel le déclencheur est exécuté. Par conséquent, le dernier type de déclencheurs nous convient.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Le déclencheur fourni remplace la valeur du champ row_ver du tuple enregistré par la valeur suivante de la séquence row_version.
Pour pouvoir extraire des données de l'espace goods par la colonne row_ver, créons un index :
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Le type d'index est un arbre (TREE), car nous devrons extraire les données par ordre croissant des valeurs de la colonne. row_ver.
Ajoutons quelques données dans l'espace :
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Comme le premier champ est un compteur auto-increment, nous passons nil à sa place. Tarantool substituera automatiquement la valeur suivante. De même, pour les valeurs des champs de la colonne row_ver , il est possible de passer nil, ou de ne pas spécifier de valeur du tout, car cette colonne occupe la dernière position dans l'espace.
Vérifions le résultat de l'insertion :
tarantool> box.space.goods:select()
---
- - [1, 'stylo', 123, 1]
  - [2, 'crayon', 321, 2]
  - [3, 'pinceau', 100, 3]
  - [4, 'aquarelle', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'cahier', 800, 6]
  - [7, 'gomme', 531, 7]
  - [8, 'règle', 135, 8]
...
Comme nous le voyons, le premier et le dernier champ se sont remplis automatiquement. Il sera donc facile d'écrire une fonction pour l'extraction par page des modifications de l'espace. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
La fonction prend en paramètre une valeur row_ver, à partir de laquelle il faut réaliser l'extraction des modifications, et renvoie un lot de données modifiées.
L'extraction des données dans Tarantool se fait par le biais d'index. La fonction get_goods utilise un itérateur sur l'index row_ver pour obtenir les données modifiées. Le type d'itérateur — GT (Greater Than, plus grand que). Cela signifie que l'itérateur effectuera un parcours séquentiel des valeurs de l'index à partir de la clé (valeur du champ) transmise. row_ver).
L'itérateur renvoie des tuples. Pour pouvoir ensuite transmettre les données par HTTP, il est nécessaire de transformer les tuples en une structure qui soit pratique pour la sérialisation ultérieure. Dans l'exemple, on utilise la fonction standard tomap. Au lieu d'utiliser tomap vous pouvez écrire votre propre fonction. Par exemple, nous pouvons vouloir renommer le champ nom, ne pas transmettre le champ code et ajouter le champ comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'un commentaire'
    obj.row_ver = tuple.row_ver
    return obj
end
La taille de la page des données renvoyées (nombre d'enregistrements par portion) est définie par la variable page_size. Dans l'exemple, la valeur page_size égal à 5. Dans un programme réel, la taille de la page a généralement plus d'importance. Elle dépend de la taille moyenne des tuples de l'espace. La taille de la page optimale peut être déterminée empiriquement en mesurant le temps de transmission des données. Plus la taille de la page est grande, moins il y a de round-trips entre l'expéditeur et le récepteur. Cela peut réduire le temps total de déchargement des modifications. Cependant, si la taille de la page est trop grande, le serveur prendra trop de temps pour sérialiser la sélection. En conséquence, des retards peuvent survenir lors du traitement d'autres requêtes envoyées au serveur. Le paramètre page_size peut être chargé à partir du fichier de configuration. Pour chaque espace transmis, une valeur propre peut être définie. Cependant, pour la plupart des espaces, une valeur par défaut (par exemple, 100) peut convenir.
Exécutons la fonction get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: stylo
    id: 1
  - row_ver: 2
    code: 321
    name: crayon
    id: 2
  - row_ver: 3
    code: 100
    name: pinceau
    id: 3
  - row_ver: 4
    code: 456
    name: aquarelle
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Prenons la valeur du champ row_ver de la dernière ligne et rappelons la fonction :
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: carnet
    id: 6
  - row_ver: 7
    code: 531
    name: gomme
    id: 7
  - row_ver: 8
    code: 135
    name: règle
    id: 8
...
Et encore une fois :
tarantool> get_goods(8)
---
- []
...
Comme nous le voyons, avec cette utilisation, la fonction retourne toutes les entrées de l'espace de manière paginée goods. Après la dernière page, il y a un résultat vide.
Faisons des modifications dans l'espace :
box.space.goods:update(4, {{'=', 6, 'carnet'}})
box.space.goods:insert{nil, 'clip', 234}
box.space.goods:insert{nil, 'dossier', 432}
Nous avons modifié la valeur du champ nom pour une entrée et ajouté deux nouvelles entrées.
Répétons le dernier appel de fonction :
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: carnet
    id: 6
  - row_ver: 10
    code: 234
    name: clip
    id: 9
  - row_ver: 11
    code: 432
    name: dossier
    id: 10
...
La fonction a retourné les enregistrements modifiés et ajoutés. Ainsi, la fonction get_goods permet d'obtenir les données qui ont changé depuis son dernier appel, ce qui est la base de la méthode de réplication discutée.
Nous laisserons la sortie des résultats via HTTP au format JSON en dehors du cadre de cet article. Vous pouvez lire à ce sujet ici :
Implémentation de la partie client/slave
Voyons à quoi ressemble l'implémentation du côté récepteur. Créons, du côté récepteur, un espace pour stocker les données chargées :
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
La structure de l'espace ressemble à celle de l'espace dans la source. Mais comme nous ne prévoyons pas de transmettre les données reçues ailleurs, la colonne row_ver est absente dans l'espace du destinataire. Dans le champ id seront enregistrés les identifiants de la source. Par conséquent, du côté du récepteur, il n'est pas nécessaire de le rendre auto-incrémental.
En outre, nous aurons besoin d'un espace pour stocker les valeurs row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Pour chaque espace à charger (champ space_name) nous allons conserver ici la dernière valeur chargée row_ver (champ value). En tant que clé primaire, la colonne space_name.
Créons une fonction pour charger les données de l'espace goods via HTTP. Pour cela, nous aurons besoin d'une bibliothèque réalisant un client HTTP. La ligne suivante charge la bibliothèque et crée une instance du client HTTP :
local http_client = require('http.client').new()Nous aurons également besoin d'une bibliothèque pour désérialiser le json :
local json = require('json')Cela suffit pour créer la fonction de chargement des données :
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
La fonction effectue une requête HTTP à l'adresse url, transmet le row_ver comme paramètre et retourne le résultat désérialisé de la requête.
La fonction de sauvegarde des données reçues est la suivante :
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
La boucle de sauvegarde des données dans l'espace goods est placée dans une transaction (pour cela, la fonction box.atomic) est utilisée pour réduire le nombre d'opérations sur le disque.
Enfin, la fonction de synchronisation de l'espace local goods avec la source peut être implémentée comme suit :
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Tout d'abord, lisons la valeur précédemment enregistrée row_ver pour l'espace goods. Si elle est absente (première session d'échange), nous prendrons comme row_ver zéro. Ensuite, dans la boucle, nous effectuons un chargement page par page des données modifiées à partir de la source selon l'URL spécifiée. À chaque itération, nous sauvegardons les données reçues dans l'espace local correspondant et mettons à jour la valeur row_ver (dans l'espace row_ver et dans la variable row_ver) — nous prenons la valeur row_ver de la dernière ligne des données chargées.
Pour éviter les boucles infinies accidentelles (en cas d'erreur dans le programme), la boucle while peut être remplacée par for:
for _ = 1, max_req do ... En conséquence de l'exécution de la fonction sync_goods l'espace goods dans le récepteur contiendra les dernières versions de toutes les entrées de l'espace goods dans la source.
Il est évident qu'avec cette méthode, il n'est pas possible de transcrire la suppression de données. Si cela s'avère nécessaire, on peut utiliser une indication de suppression. Nous ajoutons à l'espace goods un champ booléen is_deleted et au lieu de la suppression physique de l'entrée, nous utilisons la suppression logique — nous définissons la valeur du champ is_deleted à la valeur true. Parfois, au lieu d'un champ booléen, is_deleted il est plus pratique d'utiliser un champ supprimé, qui contient la date et l'heure de la suppression logique de l'enregistrement. Après avoir effectué la suppression logique, l'enregistrement marqué pour suppression sera transféré de la source au récepteur (selon la logique décrite ci-dessus).
La séquence row_ver peut être utilisée pour transférer les données d'autres espaces : il n'est pas nécessaire de créer une séquence distincte pour chaque espace transféré.
Nous avons examiné une méthode efficace de réplication de données de haut niveau dans les applications utilisant la base de données Tarantool.
Conclusions
- La base de données Tarantool est un produit attrayant et prometteur pour la création d'applications à forte charge.
- La réplication de données de haut niveau présente plusieurs avantages par rapport à la réplication de bas niveau.
- La méthode de réplication de haut niveau examinée dans cet article permet de minimiser la quantité de données transférées en ne transmettant que les enregistrements qui ont changé depuis la dernière session d'échange.
Source : habr.com
