

L'un des scénarios typiques dans toutes les applications que nous connaissons est la recherche de données selon certains critères et leur affichage dans un format lisible. Il peut également y avoir des fonctionnalités supplémentaires pour le tri, le regroupement et la pagination. La tâche, en théorie, est triviale, mais lors de sa réalisation, de nombreux développeurs commettent une série d'erreurs qui affectent ensuite les performances. Examinons les différentes options pour résoudre ce problème et formulons des recommandations pour choisir la mise en œuvre la plus efficace.
Option de pagination #1
La solution la plus simple qui vient à l'esprit est l'affichage des résultats de recherche page par page dans sa forme classique.
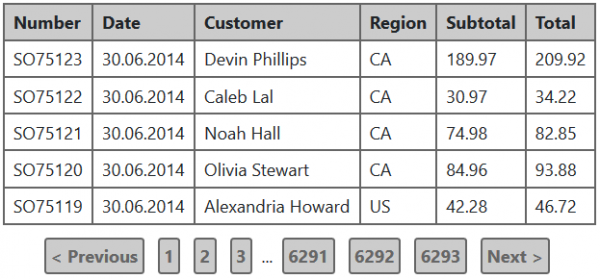
Supposons qu'une base de données relationnelle soit utilisée dans l'application. Dans ce cas, pour afficher l'information de cette manière, il faudra exécuter deux requêtes SQL :
- Obtenir les lignes pour la page actuelle.
- Compter le nombre total de lignes correspondant aux critères de recherche — cela est nécessaire pour afficher les pages.
Examinons la première requête en prenant comme exemple la base de données MS SQL de test pour le serveur 2016. Pour cela, nous utiliserons la table Sales.SalesOrderHeader :
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
La requête ci-dessus retournera les 50 premières commandes de la liste, triées par date d'ajout dans l'ordre décroissant, en d'autres termes — les 50 dernières commandes.
Elle s'exécute rapidement sur la base de données de test, mais examinons le plan d'exécution et les statistiques d'entrée-sortie :
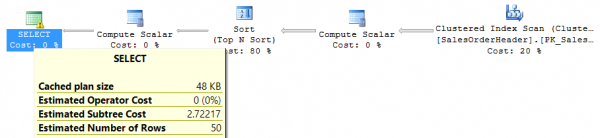
Table 'SalesOrderHeader'. Scan count 1, logical reads 698, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.Pour obtenir les statistiques d'entrée/sortie de chaque requête, vous pouvez exécuter dans l'environnement d'exécution des requêtes la commande SET STATISTICS IO ON.
Comme on peut le voir dans le plan d'exécution, l'opération la plus consommatrice de ressources est le tri de toutes les lignes de la table source par date d'ajout. Et le problème est que plus il y aura de lignes dans la table, plus le tri sera « lourd ». Dans la pratique, il faut éviter de telles situations, c'est pourquoi nous ajouterons un index sur la date d'ajout et vérifierons si la consommation de ressources a changé :
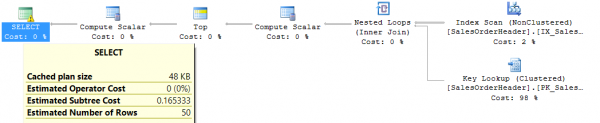
Table 'SalesOrderHeader'. Scan count 1, logical reads 165, physical reads 0, read-ahead reads 5, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.
Il est évident que c'est beaucoup mieux maintenant. Mais tous les problèmes sont-ils résolus ? Changeons la requête pour rechercher les commandes dont le montant total des produits dépasse 100 dollars :
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
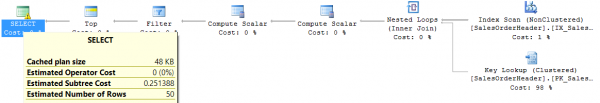
Table 'SalesOrderHeader'. Compte de scans 1, lectures logiques 1081, lectures physiques 0, lectures anticipées 0, lectures logiques lob 0, lectures physiques lob 0, lectures anticipées lob 0.Nous avons une situation amusante : le plan de la requête n'est pas beaucoup plus mauvais que le précédent, mais le nombre réel de lectures logiques est presque deux fois plus élevé que lors d'un scan complet de la table. Il existe une solution — si l'on crée un index composite à partir de l'index existant et que l'on ajoute le montant total des produits comme deuxième champ, nous obtenons à nouveau 165 lectures logiques :
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Cette série d'exemples peut être poursuivie longtemps, mais les deux idées principales que je souhaite exprimer ici sont les suivantes :
- Ajouter n'importe quel nouveau critère ou ordre de tri dans la requête de recherche peut avoir un impact important sur la vitesse de son exécution.
- Mais si nous devons ne lire qu'une partie des données, et non tous les résultats correspondant aux conditions de recherche — il existe de nombreuses façons d'optimiser une telle requête.
Passons maintenant à la deuxième requête mentionnée au début — celle qui compte le nombre d'enregistrements qui répondent au critère de recherche. Prenons le même exemple — rechercher des commandes qui coûtent plus de 100 dollars :
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Avec l'index composite mentionné ci-dessus, nous obtenons :
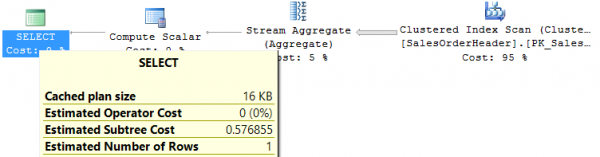
Table 'SalesOrderHeader'. Scan count 1, logical reads 698, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.Il n'est pas surprenant que la requête parcourt entièrement l'index, car le champ SubTotal n'est pas en première position, donc la requête ne peut pas en tirer parti. Le problème se résout en ajoutant un autre index sur le champ SubTotal, et cela donne finalement seulement 48 lectures logiques.
On peut donner encore quelques exemples de requêtes de comptage, mais le principe reste le même : obtenir une portion de données et compter le total sont deux requêtes fondamentalement différentes, et chacune nécessite ses propres mesures d'optimisation. En général, il n'est pas possible de trouver une combinaison d'index qui fonctionne également bien pour les deux requêtes.
Par conséquent, l'une des exigences importantes à préciser lors du développement d'une telle solution de recherche est de savoir s'il est vraiment important pour l'entreprise de voir le nombre total d'objets trouver. Souvent, ce n'est pas le cas. Quant à la navigation par numéros de page spécifiques, cela me semble être une solution à champ d'application très limité, car la plupart des scénarios de pagination ressemblent à « passer à la page suivante ».
Option de pagination #2
Supposons que les utilisateurs ne se soucient pas de connaître le nombre total d'objets trouvés. Essayons de simplifier la page de recherche :
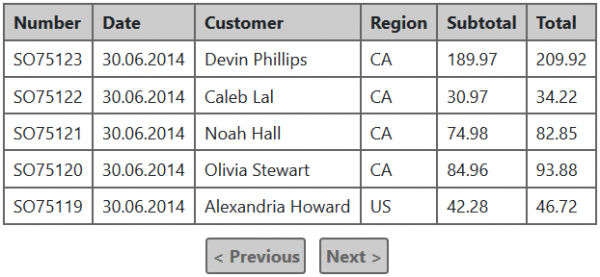
En réalité, la seule chose qui a changé est qu'il n'est plus possible de naviguer par numéros de pages spécifiques, et il n'est plus nécessaire que cette table sache combien de pages peuvent exister. Mais la question se pose : comment la table sait-elle s'il y a des données pour la page suivante (afin d'afficher correctement le lien « Suivant ») ?
La réponse est très simple : il est possible de lire dans la base une entrée de plus que ce qui est nécessaire pour l'affichage, et la présence de cette entrée « supplémentaire » indiquera s'il y a un lot suivant. Ainsi, pour obtenir une page de données, il suffira d'exécuter une seule requête, ce qui améliore considérablement les performances et facilite la maintenance de cette fonctionnalité. J'ai eu un cas dans ma pratique où l'abandon du comptage du nombre total d'enregistrements a accéléré le retour des résultats de 4 à 5 fois.
Pour cette approche, il existe plusieurs options d'interface utilisateur : les commandes « précédent » et « suivant », comme dans l'exemple ci-dessus, le bouton « charger plus », qui ajoute simplement un nouveau lot aux résultats affichés, la « défilement infini », qui fonctionne selon le principe de « charger plus », mais le signal pour obtenir le prochain lot est le défilement par l'utilisateur de tous les résultats affichés jusqu'à la fin. Quelle que soit la solution visuelle, le principe d'extraction des données reste le même.
Détails de la mise en œuvre de la pagination
Dans tous les exemples de requêtes donnés ci-dessus, nous utilisons l'approche « décalage + nombre », où la requête elle-même indique à partir de quel numéro de ligne de résultat et combien de lignes retourner. Commençons par examiner comment organiser au mieux le passage des paramètres dans ce cas. Dans la pratique, j'ai rencontré plusieurs méthodes :
- Numéro de page demandé (pageIndex), taille de la page (pageSize).
- Numéro du premier enregistrement à retourner (startIndex), nombre maximum d'enregistrements dans le résultat (count).
- Numéro du premier enregistrement à retourner (startIndex), numéro du dernier enregistrement à retourner (endIndex).
À première vue, cela peut sembler si simple qu'il n'y a pas de différence. Mais ce n'est pas le cas — la solution la plus pratique et universelle est la deuxième (startIndex, count). Cela s'explique par plusieurs raisons :
- Pour l'approche utilisant la lecture d'un enregistrement supplémentaire, le premier choix avec pageIndex et pageSize est extrêmement peu pratique. Par exemple, si nous voulons afficher 50 enregistrements par page. Selon l'algorithme ci-dessus, il faut lire un enregistrement de plus que nécessaire. Si ce « +1 » n'est pas pris en compte côté serveur, cela signifie que pour la première page, nous devrions demander les enregistrements de 1 à 51, pour la deuxième — de 51 à 101, etc. Si nous spécifions une taille de page de 51 et augmentons le pageIndex, la deuxième page renverra de 52 à 102, etc. Par conséquent, dans la première option, le seul moyen de mettre en œuvre correctement un bouton pour passer à la page suivante est de prévoir côté serveur la lecture de la ligne « supplémentaire », ce qui est une nuance très obscure.
- La troisième option n'a absolument aucun sens, car pour exécuter des requêtes dans la plupart des bases de données, il faudra quand même transmettre le nombre d'enregistrements et non l'index du dernier enregistrement. Bien que soustraire startIndex de endIndex soit une opération arithmétique élémentaire, elle est ici superflue.
Il est maintenant nécessaire de décrire les inconvénients de l'implémentation du paging via « décalage + quantité » :
- Obtenir chaque page suivante sera plus coûteux et plus lent que la précédente, car la base de données devra quand même parcourir tous les enregistrements « depuis le début » selon les critères de recherche et de tri, puis s'arrêter sur le segment requis.
- Toutes les SGBD ne peuvent pas prendre en charge cette approche.
Il existe des alternatives, mais elles ne sont pas non plus idéales. La première de ces approches est appelée « keyset paging » ou « méthode de recherche » et consiste à ce qui suit : après avoir obtenu un lot, vous pouvez mémoriser les valeurs des champs dans le dernier enregistrement de la page, puis les utiliser pour obtenir le lot suivant. Par exemple, nous avons exécuté une telle requête :
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Dans le dernier enregistrement, nous avons obtenu la date de la commande ‘2014-06-29’. Pour obtenir la page suivante, nous pourrions tenter d'exécuter ceci :
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Le problème est que OrderDate n'est pas un champ unique et la condition mentionnée ci-dessus risquerait de manquer beaucoup de lignes nécessaires. Pour rendre cette requête unique, il faut ajouter un champ unique à la condition (supposons que 75074 est la dernière valeur de la clé primaire de la première portion) :
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Cette variante fonctionnera correctement, mais en général, il sera difficile de l'optimiser car la condition contient l'opérateur OR. Si, à mesure que OrderDate augmente, la valeur de la clé primaire augmente également, alors la condition peut être simplifiée en gardant seulement le filtre sur SalesOrderID. Mais s'il n'y a pas de corrélation stricte entre les valeurs de la clé primaire et le champ selon lequel les résultats sont triés, il ne sera pas possible d'éviter cet OR dans la plupart des SGBD. Une exception que je connais est PostgreSQL, qui prend entièrement en charge la comparaison de tuples, et la condition mentionnée ci-dessus peut être formulée comme « WHERE (OrderDate, SalesOrderID) < (‘2014-06-29’, 75074) ». Avec une clé composite contenant ces deux champs, une telle requête devrait être assez simple.
Une deuxième approche alternative peut être rencontrée, par exemple, dans ou — où la requête renvoie, en plus des données, un identifiant spécial qui permet d'obtenir la prochaine portion de données. Si cet identifiant a une durée de vie illimitée (comme dans Cosmos DB), cela constitue un excellent moyen de réaliser un pagination avec un passage séquentiel entre les pages (la variante #2 mentionnée ci-dessus). Ses possibles inconvénients : elle n'est pas prise en charge dans tous les SGBD ; l'identifiant de la prochaine portion peut avoir une durée de vie limitée, ce qui, en général, ne convient pas pour réaliser une interaction avec l'utilisateur (comme, par exemple, l'ElasticSearch scroll API).
Filtrage complexe
Nous compliquons encore la tâche. Supposons qu'il y ait une exigence de réaliser ce qu'on appelle une recherche facettée, familière à tous dans les magasins en ligne. Les exemples ci-dessus basés sur la table des commandes ne sont pas très représentatifs dans ce cas, donc passons à la table Product de la base AdventureWorks :
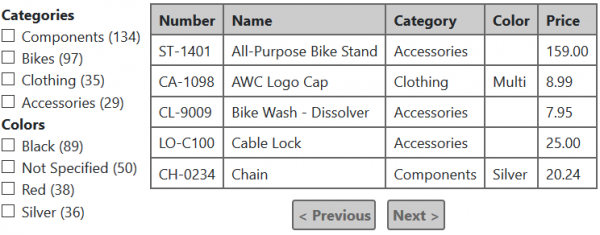
Quelle est l'idée de la recherche facettée ? Que pour chaque élément de filtre, le nombre d'enregistrements correspondant à ce critère soit affiché. en tenant compte des filtres sélectionnés dans toutes les autres catégories..
Par exemple, si nous sélectionnons dans cet exemple la catégorie Bikes et la couleur Black, la table n'affichera que les vélos de couleur noire, mais en même temps :
- Pour chaque critère du groupe « Categories », le nombre de produits de cette catégorie de couleur noire sera affiché.
- Pour chaque critère du groupe « Colors », le nombre de vélos de cette couleur sera affiché.
Voici un exemple de sortie des résultats pour de telles conditions :
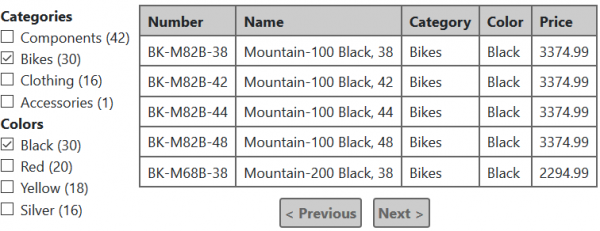
Si en plus on coche la catégorie « Clothing », la table affichera également des vêtements de couleur noire disponibles. Le nombre de produits de couleur noire dans la section « Color » sera également recalculé selon les nouvelles conditions, mais rien ne changera dans la section « Categories »... J'espère que ces exemples suffisent pour comprendre l'algorithme habituel de fonctionnement de la recherche facettée.
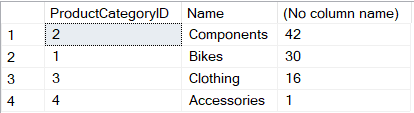
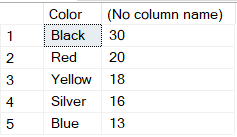
Imaginons maintenant comment cela peut être réalisé sur une base de données relationnelle. Chaque groupe de critères, comme Category et Color, nécessitera une requête distincte :
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Qu'est-ce qui ne va pas avec cette solution ? C'est très simple : elle ne se scalpe pas bien. Chaque section de filtre nécessite une requête distincte pour compter les quantités et ces requêtes ne sont pas les plus légères. Dans les magasins en ligne, certaines catégories peuvent avoir plusieurs dizaines de sections de filtre, ce qui peut poser un problème sérieux de performance.
Généralement, après ces déclarations, on me propose certaines solutions, à savoir :
- Fusionner tous les comptages en une seule requête. Techniquement, cela est possible avec le mot-clé UNION, mais cela n'aidera pas beaucoup en termes de performance — la base de données devra tout de même exécuter chaque fragment « à partir de zéro ».
- Mettre en cache les quantités. C'est ce que l'on me suggère presque à chaque fois que je décris le problème. Le détail, c'est que cela est en général impossible. Supposons que nous ayons 10 « facettes », chacune contenant 5 valeurs. C'est une situation très « modeste » par rapport à ce que l'on peut voir dans les boutiques en ligne. Le choix d'un élément de facette influence les quantités des 9 autres, en d'autres termes, pour chaque combinaison de critères, les quantités peuvent être différentes. Au total dans notre exemple, il y a 50 critères que l'utilisateur peut sélectionner, donc le nombre de combinaisons possibles sera de 250. Il n'y aurait pas assez de mémoire ni de temps pour remplir un tel tableau de données. On peut objecter que toutes les combinaisons ne sont pas réalistes et qu'un utilisateur ne choisit que rarement plus de 5 à 10 critères. Oui, on peut mettre en place un chargement paresseux et un cache des quantités uniquement pour ce qui a déjà été sélectionné, mais plus il y aura d'options de choix, moins ce cache sera efficace et plus les problèmes de temps de réponse seront perceptibles (surtout si le jeu de données change régulièrement).
Heureusement, ce type de problème possède depuis longtemps des solutions assez efficaces qui fonctionnent de manière prévisible sur de grands volumes de données. Pour chacune de ces options, il est judicieux de diviser le recalcul des facettes et l'obtention de la page de résultats en deux appels parallèles au serveur et d'organiser l'interface utilisateur de façon à ce que le chargement des données concernant les facettes « ne gêne pas » l'affichage des résultats de recherche.
- Appeler un recalcul complet des « facettes » le moins possible. Par exemple, ne pas recalculer tout à chaque changement des critères de recherche, mais plutôt trouver le nombre total de résultats correspondant aux conditions actuelles et proposer à l'utilisateur de les afficher — « 1425 enregistrements trouvés, afficher ? » L'utilisateur peut soit continuer à modifier les conditions de recherche, soit cliquer sur le bouton « afficher ». Ce n'est que dans le deuxième cas que toutes les requêtes pour obtenir des résultats et recalculer les quantités pour toutes les « facettes » seront exécutées. Il est évident que cela nécessite de gérer la requête pour obtenir le nombre total de résultats et son optimisation. Cette méthode peut être rencontrée dans de nombreux petits magasins en ligne. Évidemment, ce n'est pas une panacée pour ce problème, mais dans des cas simples, cela peut être un bon compromis.
- Utiliser un moteur de recherche pour trouver des résultats et compter les facettes, comme Solr, ElasticSearch, Sphinx et autres. Tous sont conçus pour construire des « facettes » et le font assez efficacement grâce à un index inversé. Comment fonctionnent les moteurs de recherche, pourquoi ils sont plus efficaces dans ce cas que les bases de données généralistes, quelles sont les pratiques et les écueils — c'est un sujet pour un article séparé. Ici, je veux souligner que le moteur de recherche ne peut pas remplacer le principal dépôt de données, il est utilisé comme un complément : tout changement dans la base de données principale, pertinent pour la recherche, est synchronisé avec l'index de recherche ; le mécanisme de recherche interagit généralement uniquement avec le moteur de recherche et ne s'adresse pas à la base principale. L'un des points les plus importants ici est comment organiser cette synchronisation de manière fiable. Tout dépend des exigences en matière de « temps de réponse ». Si le temps entre un changement dans la base principale et sa « manifestation » dans la recherche n'est pas critique, on peut créer un service qui, toutes les quelques minutes, cherche les enregistrements récemment modifiés et les indexe. Si un temps de réponse minimale est requise, on peut mettre en œuvre quelque chose comme pour envoyer des mises à jour au service de recherche.
Conclusions
- La mise en œuvre du paging côté serveur est une complexité sérieuse, et elle n'a de sens que pour des ensembles de données en forte croissance ou simplement volumineux. Il n'existe pas de recette précise pour évaluer ce qui est « grand » ou « en forte croissance », mais je suivrais une telle approche :
- Si l'obtention de l'ensemble complet des données, en tenant compte du temps serveur et de la transmission réseau, respecte normalement les exigences de performance, il n'est pas utile de mettre en œuvre le paging côté serveur.
- Il peut arriver qu'à court terme, il n'y ait pas de problèmes de performance, car il y a peu de données, mais que la collection de données soit en constante augmentation. Si un certain ensemble de données risque à l'avenir de ne plus satisfaire le point précédent, il est préférable de prévoir le paging dès le départ.
- S'il n'y a pas d'exigence stricte de la part des affaires concernant l'affichage du nombre total de résultats ou des numéros de pages, et que votre système n'a pas de moteur de recherche, il vaut mieux ne pas mettre en œuvre ces éléments et considérer l'option n°2.
- S'il existe une exigence claire concernant la recherche par facettes, vous avez deux options pour ne pas compromettre la performance :
- Ne pas recalculer tous les quantités à chaque modification des critères de recherche.
- Utiliser des moteurs de recherche tels que Solr, ElasticSearch, Sphinx et autres. Mais il faut comprendre qu'il ne peut pas remplacer la base de données principale et doit être utilisé comme un complément au stockage principal pour résoudre des problèmes de recherche.
- Dans le cas de la recherche par facettes, il est également judicieux de séparer l'obtention de la page des résultats de recherche et le comptage des quantités en deux requêtes parallèles. Le comptage des quantités peut prendre plus de temps que l'obtention des résultats, tandis que les résultats sont plus importants pour l'utilisateur.
- Si vous utilisez une base de données SQL pour la recherche, tout changement de code lié à cette partie doit être soigneusement testé pour la performance sur un volume de données approprié (supérieur à celui de la base « en direct »). Il est également souhaitable d'utiliser un monitoring du temps d'exécution des requêtes sur tous les instances de la base, et surtout — sur la base « en direct ». Même si, au stage de développement, les plans de requêtes semblaient bons, la situation peut changer considérablement avec l'augmentation des données.
Source : habr.com
