

Je vous propose de découvrir le compte rendu de la présentation de début 2020 de Georgy Rylov "WAL-G : nouvelles opportunités et expansion de la communauté"
Les mainteneurs d'open-source rencontrent de nombreux problèmes à mesure qu'ils se développent. Comment écrire de plus en plus de fonctionnalités requises, résoudre de plus en plus de problèmes et gérer de plus en plus de demandes de tirage ? À travers l'exemple de WAL-G (outil de sauvegarde pour PostgreSQL), je vais vous parler de la façon dont nous avons résolu ces problèmes en lançant un cours sur le développement Open-source à l'université, de ce que nous avons accompli et de la direction dans laquelle nous allons avancer.
Bonjour encore une fois ! Je suis développeur chez Yandex d'Ekaterinbourg. Et aujourd'hui, je vais vous parler de WAL-G.
Le titre de la présentation n'indiquait pas que cela concernait des sauvegardes. Quelqu'un ne sait pas ce qu'est WAL-G ? Ou tout le monde sait ? Levez la main, ceux qui ne savent pas. Incroyable, vous êtes venus à la présentation sans savoir de quoi il s'agit.
Laissez-moi vous expliquer ce qui va se passer aujourd'hui. Il se trouve que notre équipe travaille sur les sauvegardes depuis un certain temps. Et c'est une autre présentation dans une série où nous parlons de la manière dont nous stockons les données de manière sécurisée, fiable, pratique et efficace.
Dans les épisodes précédents, il y a eu de nombreuses présentations d'Andrei Borodin, Vladimir Leskov. Nous étions nombreux. Et nous avons tous parlé de WAL-G pendant de nombreuses années.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Cette présentation va un peu se distinguer des autres en ce sens qu'elle portera davantage sur la partie technique, tandis que je vais vous parler de comment nous avons été confrontés à des problèmes liés à la croissance de la communauté. Et comment nous avons imaginé une petite idée qui nous aide à y faire face.
Il y a quelques années, WAL-G était un projet assez petit que nous avons hérité de Citus Data. Et nous venons juste de le prendre. Et il était développé par une seule personne.
Et il n'y avait que dans WAL-G :
- Des sauvegardes à partir d'une réplique.
- Il n'y avait pas de sauvegardes incrémentielles.
- Il n'y avait pas de sauvegardes WAL-Delta.
- Et beaucoup d'autres choses manquaient.
Au fil des ans, WAL-G a beaucoup grandi.
Et d'ici 2020, tout ce qui précède était déjà présent. De plus, nous avons maintenant :
- Plus de 1 000 étoiles sur GitHub.
- 150 forks.
- Environ 15 demandes de tirage ouvertes.
- Et encore de nombreux contributeurs.
- Et des problèmes ouverts en permanence. Et cela alors que nous y accédons littéralement chaque jour pour faire quelque chose avec.
Et nous avons conclu que ce projet nécessite plus de notre attention, même lorsque nous n'avons pas besoin de réaliser quelque chose pour notre service Managed Databases chez Yandex.
Et quelque part à l'automne 2018, une idée nous est venue. En général, une équipe a plusieurs moyens de développer des fonctionnalités ou de corriger des bogues lorsqu'elle manque de bras. Par exemple, on peut engager un autre développeur et lui payer un salaire. Ou on peut prendre un stagiaire pour un certain temps et lui verser également un salaire. Mais il existe une autre catégorie de personnes, dont une partie sait déjà réellement écrire du code. Il est juste que vous ne savez pas toujours quelle est la qualité de ce code.
Nous avons réfléchi et décidé d'essayer d'impliquer des étudiants. Mais les étudiants ne participeront pas à tout. Ils ne feront qu'une partie du travail. Par exemple, ils rédigeront des tests, corrigeront des bogues et mettront en œuvre des fonctionnalités qui ne touchent pas à la fonctionnalité principale. La fonctionnalité principale est la création de sauvegardes et la restauration de sauvegardes. Si un bogue se produit lors de la création d'une sauvegarde, cela entraîne une perte de données. Et bien sûr, personne ne veut cela. Tout le monde veut que tout soit très fiable. C'est pourquoi nous ne voulons pas confier du code auquel nous faisons moins confiance que notre propre code. Autrement dit, tout code non critique est ce que nous aimerions obtenir de nos mains supplémentaires.
Quelles sont les conditions d'acceptation d'un PR d'étudiant ?
- Ils doivent couvrir leur code avec des tests. Tout doit passer dans le CI.
- Et nous passons également par deux revues. Une par Andreï Borodine et l'autre par moi.
- Et de plus, pour vérifier que cela ne casse rien dans notre service, je télécharge séparément la build avec ce commit. Et nous vérifions dans les tests end-to-end que rien ne s'écroule.
Cours spécial sur l'Open Source
Un peu sur l'intérêt de cela et pourquoi je pense que c'est une super idée.
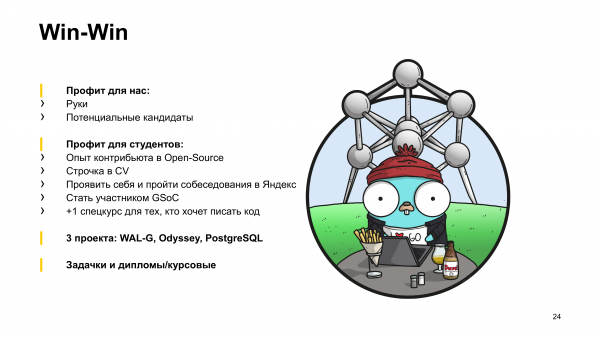
Pour nous, le profit est évident :
- Nous avons des bras supplémentaires.
- Et nous cherchons des candidats pour l'équipe parmi des étudiants talentueux qui écrivent un bon code.
Quel est le profit pour les étudiants ?
Il peut sembler moins évident, car les étudiants, au minimum, ne reçoivent pas d'argent pour le code qu'ils écrivent, mais seulement des notes sur leur livret.
Je les ai interrogés à ce sujet. Voici ce qu'ils en disent :
- L'expérience de contribution à l'Open Source.
- Obtenir une ligne sur leur CV.
- Se faire remarquer et passer un entretien chez Yandex.
- Devenir un participant à GSoC.
- +1 cours spécial pour ceux qui veulent écrire du code.
Je ne vais pas expliquer comment le cours était structuré. Je dirai juste que WAL-G était le principal projet. De plus, nous avons inclus des projets tels qu'Odyssey, PostgreSQL et ClickHouse dans ce cours.
Et nous avons donné des exercices non seulement dans ce cours, mais aussi des diplômes et des travaux de cours.
Et quel est le profit pour les utilisateurs ?
Passons maintenant à la partie qui vous intéresse probablement. Quel en est le bénéfice pour vous ? Le bénéfice est que les étudiants ont corrigé de nombreux bugs. Et ils ont fait des demandes de fonctionnalités que vous nous avez demandé de réaliser.
Et permettez-moi de parler des choses que vous attendiez depuis longtemps et qui ont été mises en œuvre.
Support des tablespaces. Le support des tablespaces dans WAL-G était probablement attendu depuis la sortie de WAL-G, car WAL-G est le successeur d'un autre outil de sauvegarde, WAL-E, qui supportait les backups des bases de données avec des tablespaces.
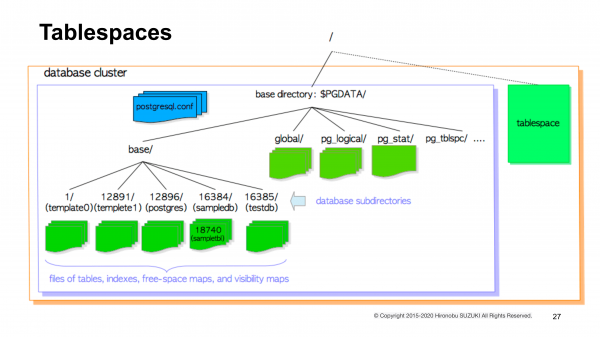
Pour résumer, qu'est-ce que c'est et pourquoi est-ce nécessaire ? En général, toutes vos données Postgres occupent un répertoire dans le système de fichiers, appelé répertoire de base. Et ce répertoire contient déjà tous les fichiers et sous-répertoires nécessaires à Postgres.
Les tablespaces sont des répertoires où se trouvent les données Postgres, mais ils ne se trouvent pas en dehors du répertoire de base. Sur la diapositive, on voit que les tablespaces se situent en dehors du répertoire de base.
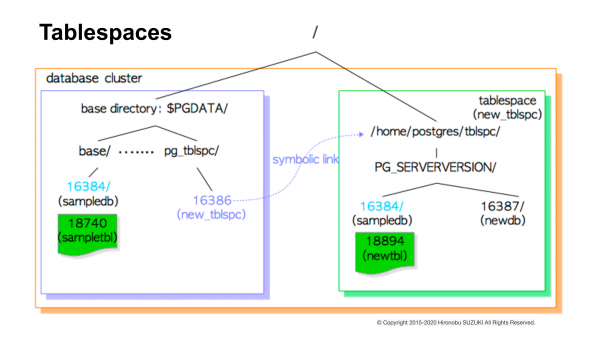
À quoi cela ressemble-t-il pour Postgres lui-même ? Dans le répertoire de base, il existe un sous-répertoire distinct pg_tblspc. Et à l'intérieur se trouvent des liens symboliques vers des répertoires contenant réellement les données Postgres en dehors du répertoire de base.
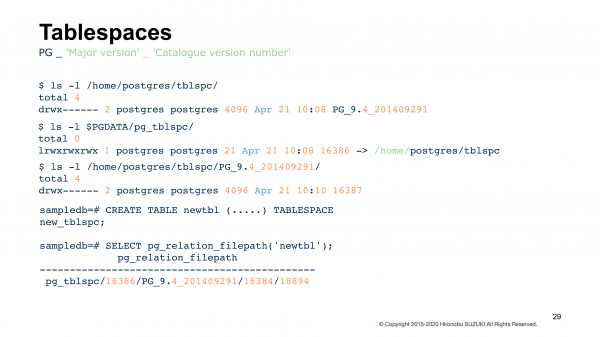
Lorsque vous utilisez tout cela, ces commandes peuvent ressembler à ceci. C'est-à-dire que vous créez une table dans un tablespace spécifié et vous vérifiez où elle se trouve maintenant. Voici ces deux dernières lignes, les deux dernières commandes appelées. Et là, on peut voir qu'il y a un certain chemin. Mais en réalité, ce n'est pas un vrai chemin. C'est un chemin avec un préfixe du répertoire de base vers le tablespace. Et de là, il est mappé par un lien symbolique qui mène à vos données réelles.
Nous n'utilisons pas cela dans notre équipe, mais de nombreux autres utilisateurs de WAL-E qui nous ont écrit qu'ils voulaient migrer vers WAL-G, mais que cela leur posait problème. Maintenant, cela est supporté.
Une autre fonctionnalité que notre cours spécial nous a apportée est le catchup. Les personnes qui ont probablement plus travaillé avec Oracle qu'avec Postgres connaissent catchup.
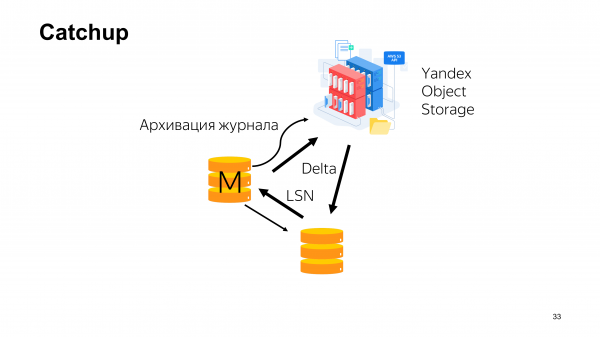
En résumé, voilà ce que c'est. Voici à quoi peut généralement ressembler la topologie d'un cluster dans notre service. Nous avons un maître. Il y a une réplique qui se synchronise avec lui via le write-ahead log. La réplique informe le maître de la position actuelle de son LSN. Parallèlement, le journal peut être archivé. De plus, des sauvegardes sont envoyées vers le cloud, ainsi que des sauvegardes delta.
Quel pourrait être le problème ? Lorsque vous avez une base de données assez volumineuse, il peut arriver que votre réplique commence à se désynchroniser considérablement par rapport au maître. Et elle est à un point tel qu'elle ne pourra jamais le rattraper. Ce problème doit généralement être résolu d'une manière ou d'une autre.
La manière la plus simple est de retirer la réplique et de la réinitialiser, car elle ne pourra jamais rattraper le maître, et il faut s'attaquer au problème. Mais cela prend assez de temps, car restaurer une sauvegarde complète d'une base de données de 10 To est très, très long. Nous souhaiterions que cela soit fait aussi vite que possible lorsque de tels problèmes surviennent. C'est précisément l'objectif de catchup.
Catchup permet d'utiliser des sauvegardes delta, qui sont stockées dans le cloud de cette manière. Vous indiquez à quel LSN se trouve actuellement la réplique en retard et vous le spécifiez dans la commande catchup pour créer une sauvegarde delta entre ce LSN et celui où se trouve actuellement votre cluster. Après cela, vous restaurez cette sauvegarde sur la réplique en retard.
Autres bases
De plus, nos étudiants nous ont apporté de nombreuses fonctionnalités. Comme nous développons non seulement Postgres chez Yandex, mais également MySQL, MongoDB, Redis, ClickHouse, à un moment donné, nous avons eu besoin de pouvoir réaliser des sauvegardes avec une récupération à un instant donné pour MySQL, et de pouvoir les charger dans le cloud.
Nous souhaitions le faire d'une manière similaire à celle utilisée par WAL-G. Nous avons donc décidé d'expérimenter et de voir à quoi cela pourrait ressembler.
Au début, sans séparer cette logique, nous avons écrit du code dans un fork. Nous avons constaté que nous avions un modèle fonctionnel et que cela pouvait fonctionner. Ensuite, nous avons pensé que notre principale communauté était composée d'utilisateurs de Postgres, qui utilisent WAL-G. Il était donc nécessaire de séparer ces parties. En d'autres termes, lorsque nous corrigeons le code pour Postgres, nous ne brisons pas MySQL, et vice versa.
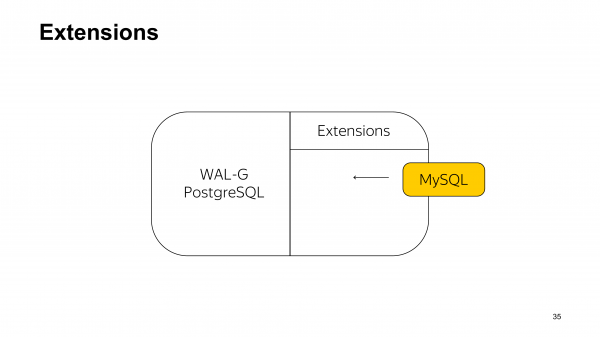
La première idée pour séparer cela était d'utiliser la même approche que celle utilisée dans les extensions PostgreSQL. En fait, pour faire une sauvegarde MySQL, vous deviez installer une certaine bibliothèque dynamique.
Mais ici, on voit tout de suite l'asymétrie de cette approche. Lorsque vous sauvegardez Postgres, vous installez un outil de sauvegarde normal pour Postgres et tout va bien. En revanche, pour MySQL, vous devez installer un outil de sauvegarde pour Postgres, puis ajouter une bibliothèque dynamique pour MySQL. Cela semble un peu étrange. Nous avons également pensé cela et avons décidé que ce n'était pas la solution dont nous avions besoin.
Différentes versions pour Postgres, MySQL, MongoDB, Redis
Mais cela nous a permis, semble-t-il, d'arriver à la bonne solution : créer différentes versions pour différentes bases. Cela permettait d'isoler la logique liée aux sauvegardes de différentes bases de données, qui allaient accéder à une API commune mise en œuvre par WAL-G.
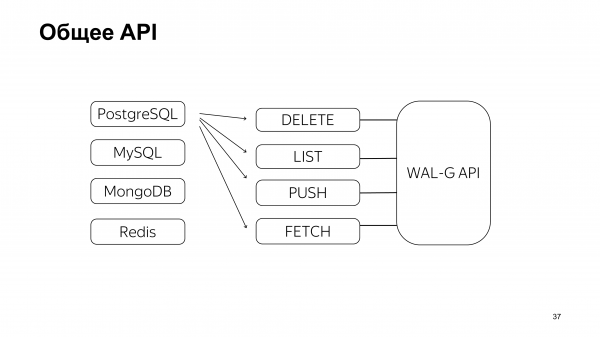
C'est la partie que nous avons écrite nous-mêmes – avant de donner des exercices aux étudiants. C'est-à-dire que c'est précisément la partie où ils pouvaient faire quelque chose de travers, donc nous avons décidé qu'il valait mieux que nous fassions quelque chose correctement et que tout soit parfait.
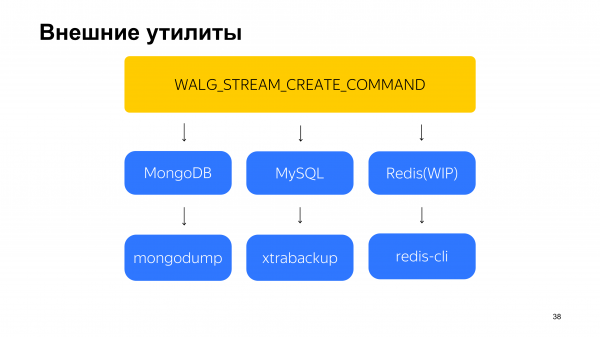
Après cela, nous avons donné des exercices. Ils ont été immédiatement pris d'assaut. Les étudiants devaient prendre en charge trois bases.
C'est MySQL, que nous sauvegardons avec WAL-G de cette manière depuis plus d'un an.
Et maintenant, MongoDB se rapproche de la production, où il est perfectionné. En fait, nous avons écrit le cadre de tout cela. Ensuite, les étudiants ont produit certaines choses qui fonctionnent. Et après, nous les peaufinons jusqu'à un état que nous pouvons accepter en production.
Ces exercices ne consistaient pas à demander aux étudiants d'écrire des outils de sauvegarde complets pour chacune de ces bases. Cela n'a pas été notre problème. Notre problème était que nous voulions un point-in-time recovery et que nous souhaitions sauvegarder dans le cloud. Nous avons demandé aux étudiants d'écrire un code qui résoudrait cela. Les étudiants ont utilisé des outils de sauvegarde déjà existants qui prennent des sauvegardes d'une certaine manière, puis assemblez tout cela avec WAL-G, qui envoyait tout dans le cloud. Ils ont également ajouté la fonctionnalité de point-in-time recovery.
Qu'est-ce que les étudiants ont également apporté ? Ils ont ajouté à WAL-G le support du chiffrement Libsodium.
Nous avons également mis en place des politiques de conservation des sauvegardes. Maintenant, les sauvegardes peuvent être marquées comme permanentes. Il est donc plus pratique pour votre service d'automatiser le processus de leur conservation.
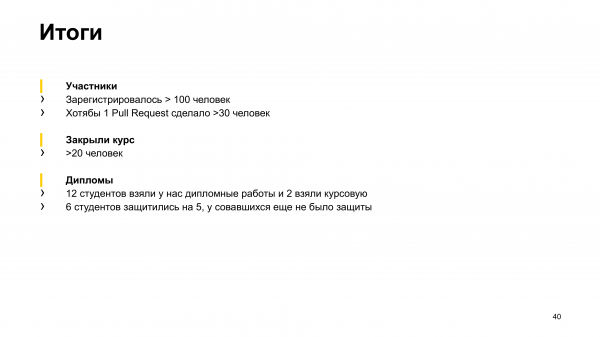
Quels sont les résultats de cette expérience ?
Au départ, plus de 100 personnes se sont inscrites au cours. Je n'ai pas mentionné que l'université à Ekaterinbourg est l'Université fédérale de l'Oural. C'est là que nous avons tout annoncé. 100 personnes se sont inscrites. En réalité, beaucoup moins ont commencé à participer, environ 30 personnes.
Encore moins de personnes ont terminé le cours, car il fallait écrire des tests pour les codes existants. De plus, il fallait corriger un bug ou ajouter une fonctionnalité. Cependant, certains étudiants ont tout de même réussi à terminer le cours.
À ce jour, les étudiants ont corrigé environ 14 problèmes pour ce cours et ont réalisé 10 fonctionnalités de tailles variées. Cela me semble être un remplacement solide d'un ou deux développeurs.
En plus de cela, nous avons délivré des diplômes et des travaux de cours. 12 d'entre eux ont reçu leur diplôme. 6 d'entre eux ont déjà soutenu leur projet avec la note « 5 ». Pour les autres, il n'y a pas encore eu de soutenance, mais je pense qu'ils réussiront aussi.
Plans pour l'avenir
Quels sont nos plans pour l'avenir ?
Au moins, les demandes de fonctionnalités que nous avons déjà reçues des utilisateurs et que nous souhaitons réaliser. Cela inclut :
- Le suivi de l'exactitude du suivi de la timeline dans l'archive des sauvegardes du cluster HA. Cela peut être fait avec WAL-G. Et je pense que nous trouverons des étudiants qui s'y attacheront.
- Nous avons déjà une personne responsable du transfert des sauvegardes et du WAL entre les clouds.
- Nous avons récemment publié l'idée que nous pouvons encore accélérer WAL-G en décompressant les sauvegardes incrémentales sans écraser les pages et en optimisant les archives que nous y envoyons.
Vous pouvez les partager ici
Quel était l'objectif de cette présentation ? C'est que maintenant, à part nous quatre qui gérons ce projet, nous avons d'autres personnes prêtes à aider, et elles sont nombreuses. Surtout si on leur écrit en message privé. Et si vous sauvegardez vos données avec WAL-G ou souhaitez passer à WAL-G, nous pouvons facilement prendre vos souhaits en compte.
Voici le code QR et le lien. Vous pouvez les utiliser pour donner toutes vos suggestions. Par exemple, si nous ne corrigeons pas un bug ou si vous attendez une fonctionnalité qui n'est pas encore dans aucune solution de sauvegarde, y compris la nôtre. N'hésitez pas à en parler.
Questions
Bonjour ! Merci pour la présentation ! J'ai une question sur WAL-G, mais pas sur Postgres. WAL-G prend en charge les sauvegardes MySQL et appelle des sauvegardes supplémentaires. Si on prend des installations modernes sur CentOS et que vous effectuez un yum install MySQL, MariaDB sera installé. À partir de la version 10.3, les sauvegardes supplémentaires ne sont plus prises en charge, seul le backup MariaDB l'est. Comment avancez-vous avec cela ?
Pour l'instant, nous n'avons pas essayé de sauvegarder MariaDB. Nous avons reçu des demandes de support pour FoundationDB, mais en général, si une telle demande existe, nous pouvons trouver des personnes pour le faire. Ce n'est pas si long et pas si compliqué, à ce qu'il me semble.
Bonjour ! Merci pour la présentation ! J'ai une question sur de potentielles nouvelles fonctionnalités. Êtes-vous prêts à faire fonctionner WAL-G avec des bandes pour effectuer des sauvegardes sur bandes ?
Vous parlez de sauvegarde sur un stockage à bandes, n'est-ce pas ?
Oui.
Il y a Andrey Borodin qui peut mieux répondre à cette question que moi.
(Andrey) Oui, merci pour la question ! Nous avons eu une demande pour déplacer les sauvegardes vers des bandes depuis un stockage cloud. Et pour cela, le transfert entre les clouds. Parce que le transfert entre les clouds est une version généralisée du transfert vers les bandes. De plus, nous avons une architecture extensible en ce qui concerne les Stockages. À propos, de nombreux Stockages ont été écrits par des étudiants. Et si vous écrivez un Storage pour des bandes, il sera bien sûr pris en charge. Nous sommes prêts à considérer un pull request. Il faut écrire un fichier, lire un fichier. Si ces choses sont codées en Go, cela représente généralement 50 lignes de code. Et alors les bandes seront prises en charge dans WAL-G.
Merci pour la présentation ! Intéressant processus de développement. La sauvegarde est une partie essentielle des fonctionnalités qui doit être bien couverte par des tests. Lorsque vous avez réalisé des fonctionnalités pour de nouvelles bases, les tests ont-ils également été écrits par des étudiants ou avez-vous écrit les tests vous-même puis confié la mise en œuvre aux étudiants ?
Les tests ont également été écrits par des étudiants. Mais les étudiants écrivaient principalement des tests pour des fonctionnalités telles que les nouvelles bases. Ils écrivaient des tests d'intégration. Et ils écrivaient des tests unitaires. Si les tests d'intégration passent, c'est-à-dire à l'heure actuelle – c'est un scénario que vous exécutez manuellement ou que vous faites faire par cron, par exemple. C'est un scénario assez compréhensible.
Les étudiants n'ont pas beaucoup d'expérience. Combien de temps passez-vous en revue ?
Oui, la revue prend beaucoup de temps. C’est-à-dire qu’en général, quand plusieurs contributeurs arrivent et disent que j'ai fait ça, j'ai fait cela, il faut réfléchir et dégager environ une demi-journée pour comprendre ce qu'ils ont écrit. Parce que le code doit être lu attentivement. Ils n'ont pas passé d'entretien. Nous ne les connaissons pas très bien, donc cela prend un temps considérable.
Merci pour la présentation ! Plus tôt, Andreï Borodine avait déclaré que la commande archive_command dans WAL-G devait être appelée directement. Mais dans le cas d'un cluster patron, nous avons besoin d'une logique supplémentaire pour déterminer le nœud à partir duquel envoyer les journaux. Comment résolvez-vous ce problème chez vous ?
Quel est le problème ici ? Avez-vous une réplique synchronisée à partir de laquelle vous faites une sauvegarde ? Ou quoi ?
(Andreï) Le fait est que WAL-G suppose réellement une utilisation sans scripts shell. Si quelque chose manque, alors écrivons la logique qui doit être intégrée dans WAL-G. Concernant la source de l'archivage, nous pensons que l'archivage doit se faire depuis le maître actuel dans le cluster. L'archivage depuis une réplique est une mauvaise idée. Divers scénarios avec des problèmes peuvent survenir. En particulier, des problèmes d'archivage de timelines et d'autres informations supplémentaires. Merci pour la question !
(Précision : Nous avons éliminé l'utilisation de scripts shell. )
Bonsoir ! Merci pour la présentation ! J'ai été intéressé par la fonctionnalité catchup dont vous avez parlé. Avez-vous déjà rencontré une situation où une réplique était en retard et ne pouvait pas rattraper son retard ? Et je n'ai pas trouvé de description de cette fonctionnalité dans la documentation de WAL-G.
Catchup est apparu littéralement vers le 20 janvier 2020. Peut-être qu'il faudrait mieux travailler sur la documentation. Nous l'écrivons nous-mêmes et nous ne le faisons pas de manière super-excellente. Et il faudrait peut-être commencer à exiger des étudiants qu'ils l'écrivent.
Est-ce déjà dans la version ?
La demande de tirage a déjà été fusionnée, c’est-à-dire que je l'ai vérifiée. Je l'ai testée sur un cluster de test. Pour l’instant, nous n'avons pas eu de situation où nous aurions pu le vérifier sur un cas pratique.
Quand s'attendre à cela ?
Je ne sais pas. Attendez un mois, nous vérifierons certainement.
Source : habr.com
