

Depuis 2019, une loi sur la traçabilité obligatoire est en vigueur en Russie. Cette loi ne s'applique pas à toutes les catégories de produits, et les délais d'entrée en vigueur de la traçabilité obligatoire varient selon les groupes de produits. Les premiers à être soumis à la traçabilité obligatoire sont le tabac, les chaussures, les médicaments, suivis plus tard d'autres produits tels que les parfums, les textiles et le lait. Cette nouveauté législative a incité le développement de nouvelles solutions informatiques permettant de suivre l'ensemble du cycle de vie des produits, de la production à l'achat par le consommateur final, impliquant tous les participants au processus : tant l'État que toutes les organisations vendant des produits soumis à la traçabilité obligatoire.
Chez X5, le système qui suivra les produits marqués et échangera des données avec l'État et les fournisseurs a été nommé « Markus ». Nous expliquerons dans l'ordre comment et qui l'a développé, quelle est sa stack technologique, et pourquoi nous avons de quoi être fiers.
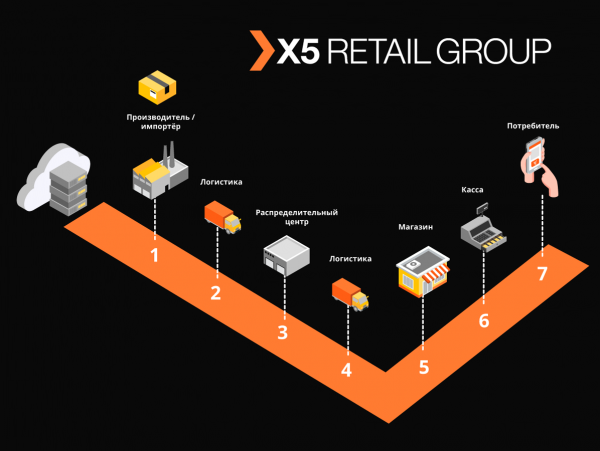
Un véritable HighLoad
« Markus » résout de nombreuses tâches, la principale étant l'interaction d'intégration entre les systèmes d'information de X5 et le système d'information public pour la traçabilité des produits marqués (GIS MP) afin de suivre le mouvement des produits marqués. De plus, la plateforme conserve tous les codes de marquage qui nous parviennent ainsi que l'historique de mouvement de ces codes entre les objets, aidant à éviter les erreurs de tri des produits marqués. Prenons l'exemple des produits du tabac, qui figurent dans les premiers groupes de marchandises marquées : un seul camion de cigarettes contient environ 600 000 paquets, chacun ayant son propre code unique. La tâche de notre système est de suivre et de vérifier la légalité de chaque mouvement de ces paquets entre les entrepôts et les magasins, et de vérifier enfin leur légitimité pour être vendus au consommateur final. Nous enregistrons environ 125 000 opérations de caisse par heure, et il faut également enregistrer comment chacun de ces paquets a atterri dans le magasin. Ainsi, en tenant compte de tous les mouvements entre les objets, nous prévoyons des dizaines de milliards d'enregistrements par an.
L'équipe M
Bien que « Markus » soit considéré comme un projet dans le cadre de X5, sa mise en œuvre suit une approche produit. L'équipe travaille selon la méthode Scrum. Le projet a été lancé à l'été dernier, mais les premiers résultats n'ont été observés qu'en octobre : une équipe dédiée a été entièrement constituée, l'architecture du système a été développée et le matériel a été acquis. Actuellement, l'équipe compte 16 personnes, dont six se consacrent au développement backend et frontend, et trois à l'analyse système. Six autres personnes gèrent les tests manuels, de charge, automatisés, ainsi que le suivi du produit. De plus, nous avons un spécialiste SRE.
Dans notre équipe, non seulement les développeurs écrivent du code, mais presque tous les membres savent programmer et rédigent des tests automatisés, des scripts de charge et des scripts d'automatisation. Nous accordons une attention particulière à cela, car même le support du produit nécessite un haut niveau d'automatisation. Pour les collègues qui n'ont jamais programmé auparavant, nous essayons toujours de donner des conseils et de les aider, en leur confiant des petites tâches.
En raison de la pandémie de coronavirus, nous avons transféré toute l'équipe en télétravail. La disponibilité de tous les outils pour gérer le développement, le workflow établi dans Jira et GitLab ont permis de passer cette étape facilement. Les mois passés en télétravail ont montré que la productivité de l'équipe n'en a pas souffert; pour beaucoup, le confort de travail s'est même amélioré, la seule chose qui manque, c'est la communication en personne.
Réunion d'équipe avant le télétravail
Réunions pendant le télétravail
Pile technologique de la solution
Le référentiel standard et l'outil CI/CD pour X5 est GitLab. Nous l'utilisons pour stocker le code, effectuer des tests continus et déployer sur des serveurs de test et de production. Nous pratiquons également le code review, où au moins 2 collègues doivent approuver les modifications de code apportées par le développeur. Les analyseurs statiques de code SonarQube et JaCoCo nous aident à maintenir la propreté du code et à garantir un niveau de couverture requis par les tests unitaires. Toutes les modifications de code doivent passer par ces contrôles. Tous les scénarios de test exécutés manuellement sont par la suite automatisés.
Pour mener à bien les processus d'affaires de « Markus », nous avons dû résoudre plusieurs problèmes technologiques, dont nous parlerons un par un.
Tâche 1. La nécessité d'une évolutivité horizontale du système
Pour répondre à ce besoin, nous avons choisi une approche microservices pour l'architecture. Il était très important de comprendre les domaines de responsabilité des services. Nous avons essayé de les diviser par opérations commerciales en tenant compte des spécificités des processus. Par exemple, la réception en entrepôt n'est pas une opération très fréquente, mais elle est très volumineuse, car il faut obtenir le plus rapidement possible des informations auprès du régulateur sur les unités de produit reçues, dont le nombre dans une seule livraison peut atteindre 600 000, vérifier l'acceptabilité de la réception de ce produit en entrepôt et transmettre toutes les informations nécessaires au système d'automatisation de l'entrepôt. En revanche, l'expédition depuis les entrepôts a une intensité beaucoup plus élevée, mais opère avec de petits volumes de données.
Tous les services sont développés selon le principe de stateless et nous essayons même de diviser les opérations internes en étapes, en utilisant ce que nous appelons des sous-thèmes Kafka. C'est lorsque le microservice envoie un message à lui-même, ce qui permet d'équilibrer la charge lors d'opérations plus gourmandes en ressources et facilite la maintenance du produit, mais nous en reparlerons plus tard.
Nous avons décidé de distinguer les modules d'interaction avec les systèmes externes en tant que services séparés. Cela a permis de résoudre le problème des API externes souvent changeantes, quasiment sans impact sur les services avec des fonctionnalités commerciales.
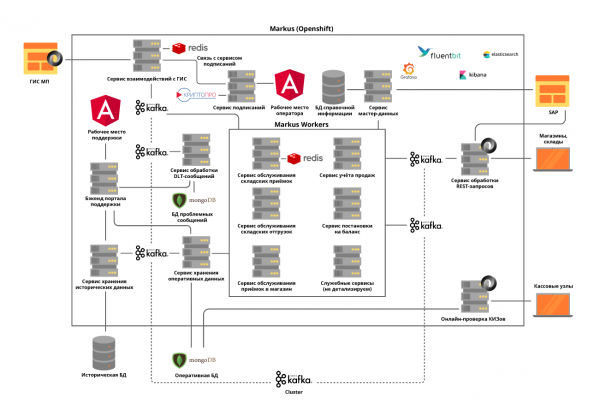
Tous les microservices sont déployés dans un cluster OpenShift, qui résout à la fois le problème de l'évolutivité de chaque microservice et nous permet d'éviter d'utiliser des outils tiers de découverte de services.
Tâche 2. La nécessité de maintenir une charge élevée et un échange de données très intensif entre les services de la plateforme : seulement au début du projet, environ 600 opérations sont réalisées par seconde. Nous prévoyons une augmentation de cette valeur à 5000 op/sec au fur et à mesure que les objets commerciaux se connectent à notre plateforme.
Nous avons résolu cette tâche en déployant un cluster Kafka et en abandonnant presque complètement l'interaction synchrone entre les microservices de la plateforme. Cela nécessite une analyse très attentive des exigences du système, car toutes les opérations ne peuvent pas être asynchrones. De plus, nous ne nous contentons pas de transmettre des événements via le broker, mais nous incluons également toutes les informations commerciales requises dans le message. Ainsi, la taille du message peut atteindre plusieurs centaines de kilo-octets. La limite de taille des messages dans Kafka exige de nous une prévision précise de la taille des messages, et, si nécessaire, nous les divisons, mais cette division est logique, liée aux opérations commerciales.
Par exemple, pour les produits arrivés en voiture, nous les divisons par caisses. Des microservices distincts sont affectés aux opérations synchrones et des tests de charge rigoureux sont effectués. L'utilisation de Kafka a posé un nouveau défi : vérifier le fonctionnement de notre service en tenant compte de l'intégration de Kafka rend tous nos tests unitaires asynchrones. Nous avons résolu cette tâche en écrivant nos propres méthodes utilitaires en utilisant un broker Kafka embarqué. Cela n'annule pas la nécessité d'écrire des tests unitaires pour chaque méthode, mais pour les cas complexes, nous privilégions les tests utilisant Kafka.
Nous avons accordé beaucoup d'attention à la traçabilité des logs, afin que leurs TraceId ne soient pas perdus en cas d'exceptions lors du fonctionnement des services ou lors du traitement de lots Kafka. Et si le premier cas n'a pas posé de problèmes particuliers, dans le second cas, nous devons enregistrer dans le log tous les TraceId associés à un batch et en sélectionner un pour continuer la traçabilité. Ainsi, lors de la recherche par le TraceId initial, l'utilisateur pourra facilement découvrir où la traçabilité a continué.
Tâche 3. La nécessité de stocker une grande quantité de données : plus d'un milliard d'étiquetages par an uniquement pour le tabac est reçu par X5. Un accès constant et rapide est nécessaire. En tout, le système doit traiter environ 10 milliards d'enregistrements concernant l'historique des mouvements des produits étiquetés.
Pour résoudre cette troisième tâche, une base de données NoSQL MongoDB a été choisie. Nous avons construit un shard de 5 nœuds, et pour chaque nœud, un ensemble de réplicas de 3 serveurs. Cela permet de scaler le système horizontalement en ajoutant de nouveaux serveurs dans le cluster et garantir sa résilience. Ici, nous avons rencontré un autre problème : assurer la transactionnalité dans le cluster mongo en tenant compte de l'utilisation de microservices horizontalement scalables. Par exemple, l'une des tâches de notre système est d'identifier les tentatives de revente de produits avec des codes d'étiquetage identiques. Cela engendre des problèmes liés à des numérisations erronées ou à des opérations incorrectes des caissiers. Nous avons constaté que ces doublons pouvaient se produire aussi bien à l'intérieur d'un batch Kafka traité que dans deux batches parallèles. Ainsi, la vérification des doublons en interrogeant la base de données ne donnait rien. Pour chaque microservice, nous résolvions le problème séparément, en fonction de la logique métier de ce service. Par exemple, pour les reçus, nous avons ajouté une vérification au sein du batch et un traitement distinct pour la détection des doublons lors de l'insertion.
Pour que le travail des utilisateurs avec l'historique des opérations n'affecte en rien ce qui est essentiel — le fonctionnement de nos processus métier, toutes les données historiques ont été isolées dans un service distinct avec une base de données séparée, qui reçoit également des informations via Kafka. Ainsi, les utilisateurs interagissent avec un service isolé, sans influencer les services traitant les données des opérations en cours.
Tâche 4. Re-traitement des files d'attente et surveillance :
Dans les systèmes distribués, il y a inévitablement des problèmes et des erreurs d'accessibilité des bases de données, des files d'attente et des sources de données externes. Dans le cas de « Markus », la source de ces erreurs est l'intégration avec des systèmes externes. Il était nécessaire de trouver une solution permettant de réémettre des requêtes en réponse à des réponses erronées avec un certain délai défini, tout en poursuivant le traitement des requêtes réussies dans la file principale. Pour ce faire, le concept dit de « topic based retry » a été choisi. Pour chaque topic principal, un ou plusieurs topics de réessai sont créés, dans lesquels sont dirigés les messages erronés, tout en excluant un délai pour le traitement des messages du topic principal. Le schéma d'interaction —
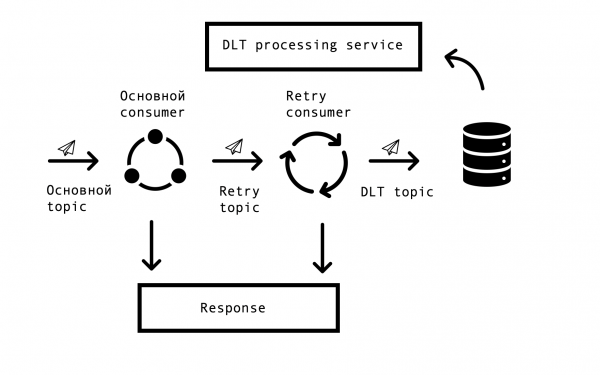
Pour mettre en œuvre un tel schéma, nous avions besoin de la solution suivante : intégrer cette solution avec Spring tout en évitant la duplication de code. Sur Internet, nous sommes tombés sur une solution similaire basée sur Spring BeanPostProcessor, mais elle nous a semblé trop encombrante. Notre équipe a proposé une solution plus simple, permettant de s'intégrer au cycle de Spring pour la création de consumers et d'ajouter des Retry Consumers. Le prototype de notre solution a été soumis à l'équipe Spring, et il est possible de le consulter. Le nombre de Retry Consumers et le nombre de tentatives pour chaque consumer peuvent être configurés via des paramètres, selon les besoins du processus métier, et pour que tout fonctionne, il suffit d'ajouter l'annotation bien connue de tous les développeurs Spring : org.springframework.kafka.annotation.KafkaListener.
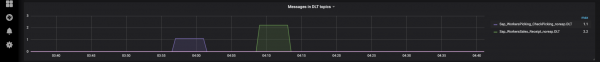
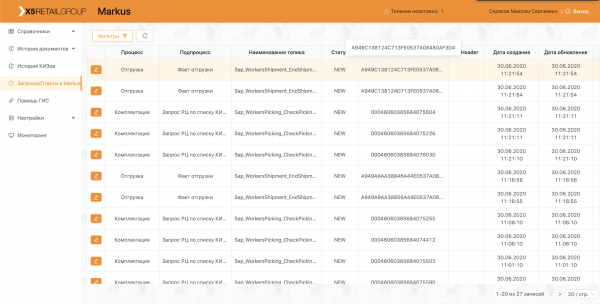
Si un message ne peut pas être traité après toutes les tentatives de retry, il est dirigé vers le DLT (dead letter topic) à l'aide de Spring DeadLetterPublishingRecoverer. À la demande du support, nous avons élargi cette fonctionnalité et mis en place un service distinct permettant de visualiser les messages tombés dans le DLT, le stackTrace, le traceId et d'autres informations utiles à leur sujet. De plus, des surveillances et des alertes ont été ajoutées pour tous les topics DLT, et actuellement, l'apparition d'un message dans le topic DLT est un motif d'examen et de création d'un défaut. C'est très pratique : grâce au nom du topic, nous comprenons immédiatement à quelle étape du processus le problème est survenu, ce qui accélère considérablement la recherche de sa cause profonde.
Récemment, nous avons mis en place une interface permettant de renvoyer des messages par l'intermédiaire de notre support, après avoir résolu leurs causes (par exemple, la restauration du bon fonctionnement d'un système externe) et, bien sûr, d'ouvrir un défaut correspondant pour analyse. Nos self-topics ont été utiles ici, car il est possible de redémarrer la chaîne de traitement à partir de l'étape souhaitée, sans avoir à la relancer entièrement.
Exploitation de la plateforme
La plateforme est déjà en exploitation productive, chaque jour nous effectuons des livraisons et des expéditions, et connectons de nouveaux centres de distribution et magasins. Dans le cadre du pilote, le système fonctionne avec des groupes de produits tels que "Tabac" et "Chaussures".
Toute notre équipe participe à la réalisation des pilotes, analyse les problèmes émergents et propose des améliorations pour notre produit, allant de l'amélioration des journaux à des modifications des processus.
Pour ne pas répéter mes erreurs, tous les cas trouvés lors du pilote sont reflétés dans les tests automatisés. La présence d'un grand nombre de tests automatiques et de tests unitaires permet de réaliser des tests de régression et de déployer des correctifs en l'espace de quelques heures.
Nous continuons actuellement à développer et à perfectionner notre plateforme, et nous sommes constamment confrontés à de nouveaux défis. Si cela vous intéresse, nous vous parlerons de nos solutions dans les prochains articles.
Source : habr.com
