

Les journaux sont une partie importante du système permettant de comprendre si celui-ci fonctionne (ou ne fonctionne pas) comme prévu. Dans le cadre d'une architecture de microservices, la gestion des journaux devient une discipline à part entière, un véritable défi. Il faut résoudre plusieurs questions à la fois :
- comment écrire des journaux depuis l'application ;
- où écrire les journaux ;
- comment acheminer les journaux pour stockage et traitement ;
- comment traiter et stocker les journaux.
L'adoption des technologies de conteneurisation populaires ajoute encore une couche de complexité dans la recherche de solutions pour ce problème.
C'est précisément de cela qu'il s'agit dans l'exposé de Yuri Bushmelev intitulé « La carte des défis dans la collecte et la livraison des journaux ».
Pour ceux que cela intéresse, je vous invite à lire la suite.
Je m'appelle Yuri Bushmelev. Je travaille chez Lazada. Aujourd'hui, je vais parler de la manière dont nous avons géré nos journaux, comment nous les avons collectés, et ce que nous y écrivons.
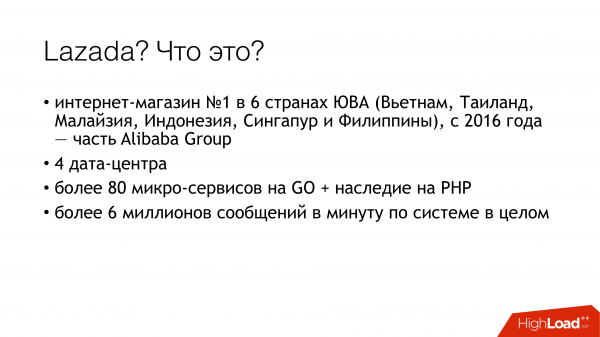
D'où venons-nous ? Qui sommes-nous ? Lazada est le numéro 1 des magasins en ligne dans six pays d'Asie du Sud-Est. Tous ces pays sont répartis sur plusieurs centres de données. Actuellement, nous avons quatre centres de données. Pourquoi est-ce important ? Parce que certaines solutions ont été influencées par le fait qu'il existe un lien très faible entre ces centres. Nous avons une architecture de microservices. J'ai été surpris de constater que nous avons déjà 80 microservices. Lorsque j'ai commencé à travailler sur la gestion des journaux, nous n'en avions que 20. De plus, il y a une portion assez importante de code PHP hérité avec laquelle nous devons également composer. Tout cela génère actuellement plus de 6 millions de messages par minute à l’échelle du système. Je vais maintenant montrer comment nous tentons de gérer cela, et pourquoi c'est ainsi.
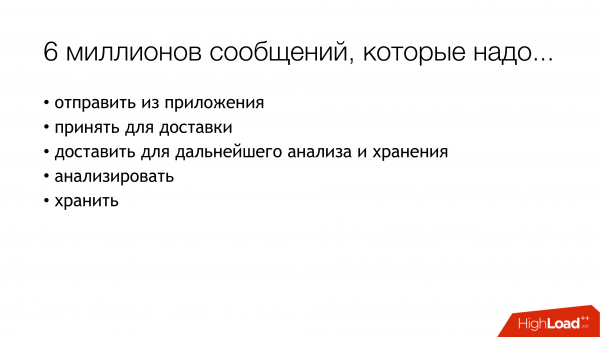
Avec ces 6 millions de messages, il faut bien vivre. Que devons-nous en faire ? 6 millions de messages qui doivent :
- être envoyés depuis l'application,
- être reçus pour livraison,
- être livrés pour analyse et stockage.
- analyser
- être stockés d'une certaine manière.
Lorsque trois millions de messages ont été générés, j'avais à peu près cette même apparence. Car nous avons commencé avec quelques centimes. Il est clair que des journaux d'applications y sont écrits. Par exemple, impossible de se connecter à la base de données, connexion réussie à la base de données, mais impossible de lire quelque chose. Mais en plus de cela, chaque microservice écrit également un journal d'accès. Chaque requête arrivée au microservice est enregistrée dans le journal. Pourquoi faisons-nous cela ? Les développeurs veulent avoir la possibilité de traçage. Dans chaque journal d'accès, il y a un champ traceid, qui permet à une interface spéciale de déballer toute la chaîne et de montrer joliment le traçage. Le traçage montre comment la requête a été traitée, ce qui aide nos développeurs à gérer plus rapidement toutes les anomalies non identifiées.
Comment vivre avec ça ? Je vais brièvement vous présenter les options — comment ce problème est généralement résolu. Comment aborder la tâche de collecte, de transmission et de stockage des journaux.
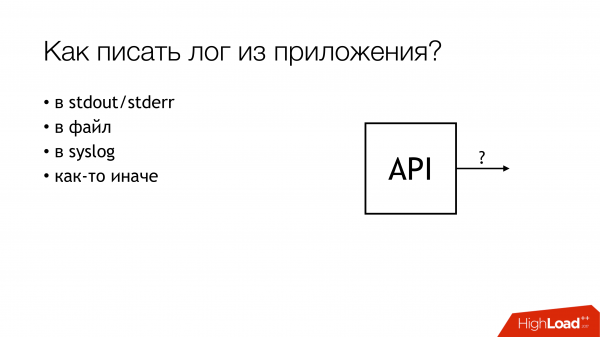
Comment écrire à partir de l'application ? Il est clair qu'il existe différentes méthodes. En particulier, il y a les meilleures pratiques, comme le disent les amis à la mode. Il y a l'approche old school en deux versions, comme l'ont raconté nos aïeux. Il existe aussi d'autres méthodes.
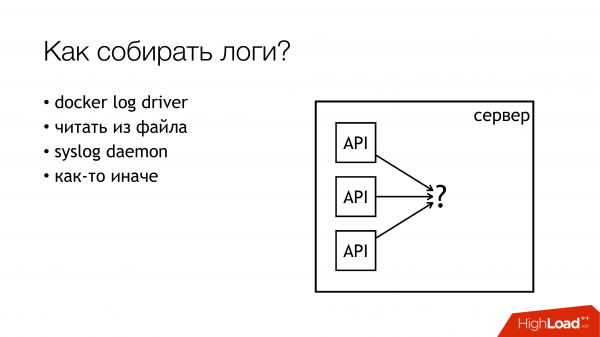
La situation est à peu près la même pour la collecte des journaux. Les options pour résoudre cette partie spécifique ne sont pas si nombreuses. Il y en a plus maintenant, mais elles restent encore limitées.
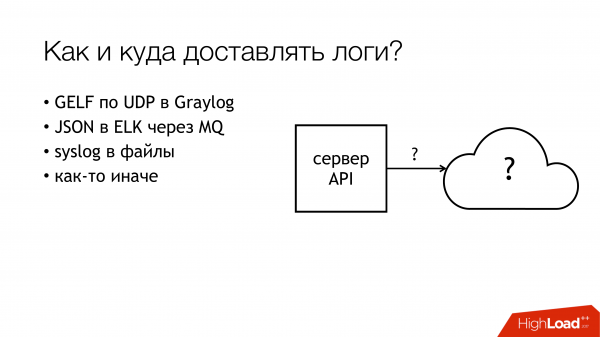
En revanche, à propos de la livraison et de l'analyse ultérieure — le nombre de variations commence à exploser. Je ne vais pas décrire chaque option maintenant. Je pense que les principales variantes sont bien connues de ceux qui s'intéressent au sujet.
Je vais vous montrer comment nous avons fait cela chez Lazada, et comment tout cela a commencé.
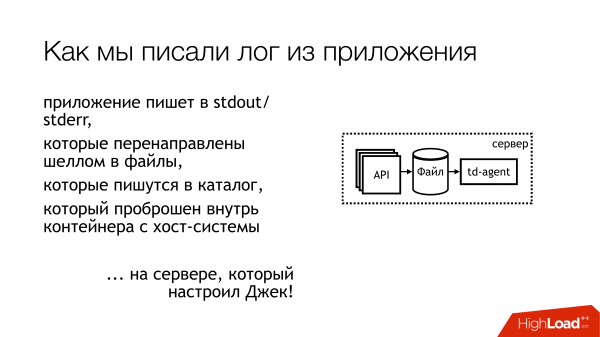
Il y a un an, je suis arrivé chez Lazada, et on m'a envoyé sur un projet concernant les journaux. C'était à peu près comme ça. Le journal de l'application était écrit dans stdout et stderr. Tout a été fait à la mode. Mais ensuite, les développeurs l'ont sorti des flux standards, puis, d'une manière ou d'une autre, les spécialistes de l'infrastructure s'en occupaient. Entre les spécialistes de l'infrastructure et les développeurs, il y a également des release managers, qui ont dit : « euh… bon d'accord, enveloppons simplement cela dans un fichier avec un shell, et c'est tout ». Étant donné que tout cela est dans un conteneur, ils l'ont enveloppé directement à l'intérieur du conteneur, ont mappé le répertoire et l'ont déposé là. Je pense qu'il est à peu près évident pour tout le monde ce que cela a donné.
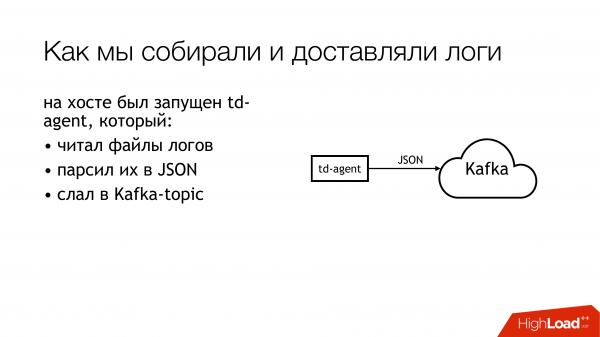
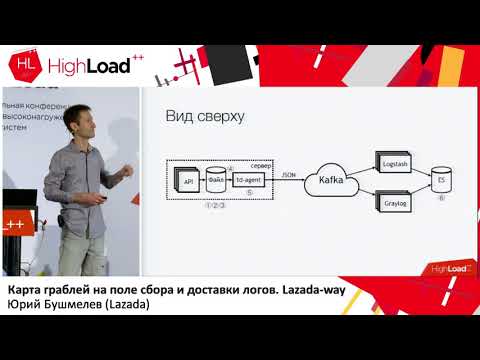
Regardons un peu plus loin. Comment nous avons livré ces journaux. Quelqu'un a choisi td-agent, qui est en fait fluentd, mais pas tout à fait fluentd. Je n'ai jamais compris la relation entre ces deux projets, mais ils semblent parler de la même chose. Ce fluentd, écrit en Ruby, lisait des fichiers journaux, les analysait en JSON selon certaines expressions régulières. Puis il les envoyait dans Kafka. En fait, dans Kafka, chaque API avait 4 sujets distincts. Pourquoi 4 ? Parce qu'il y a le live, le staging, et parce qu'il y a stdout et stderr. Les développeurs en créent beaucoup, et les responsables de l'infrastructure doivent les créer dans Kafka. De plus, Kafka était contrôlé par un autre service. Il fallait donc créer un ticket pour qu'ils créent ces 4 sujets pour chaque API. Tout le monde oubliait cela. En gros, c'était le chaos.
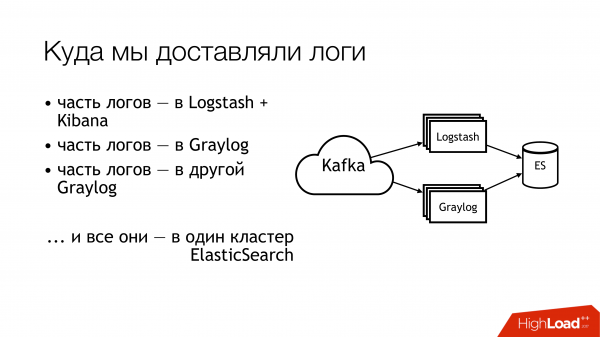
Que faisions-nous ensuite avec ça ? Nous l'envoyions dans Kafka. Ensuite, la moitié des journaux partaient pour Logstash. L'autre moitié des journaux se divisait. Une partie allait dans un Graylog, l'autre dans un autre Graylog. Au final, tout cela partait dans un seul cluster Elasticsearch. Donc, tout ce fouillis finissait là. Il ne faut pas faire ça !
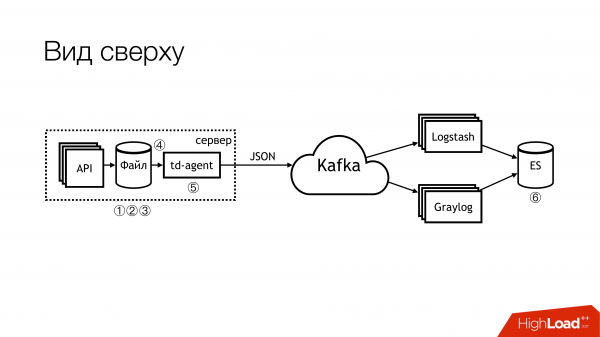
Voilà à quoi cela ressemble, si l'on regarde rapidement d'en haut. Il ne faut pas faire ça ! Ici, les chiffres marquent immédiatement les endroits problématiques. Il y en a en réalité plus, mais 6 sont vraiment critiques, avec lesquels il faut agir. Je vais maintenant en parler séparément.
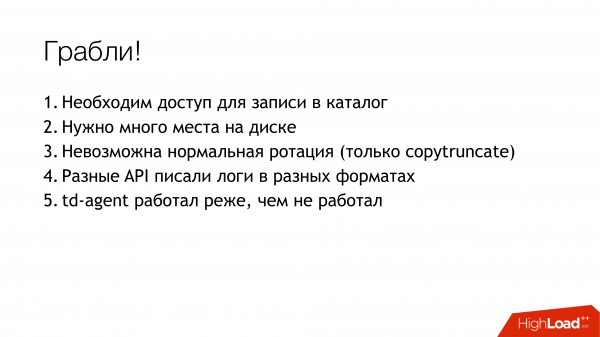
Ici (1,2,3), nous écrivons des fichiers et, par conséquent, il y a directement trois pièges.
Le premier (1) — c'est que nous devons les écrire quelque part. On ne veut pas toujours donner à l'API la possibilité d'écrire directement dans un fichier. Il est préférable que l'API soit isolée dans un conteneur, et encore mieux – qu'elle soit en lecture seule. Je suis administrateur système, donc j’ai un point de vue un peu alternatif sur ces choses.
Le deuxième point (2,3) — nous recevons beaucoup de requêtes dans l'API. L'API écrit beaucoup de données dans un fichier. Les fichiers augmentent. Nous devons les faire tourner. Sinon, il n'y aura pas assez d'espace disque. Les faire tourner est compliqué, car ils sont redirigés via un shell vers un répertoire. Nous ne pouvons pas les faire tourner. On ne peut pas dire à l'application de rouvrir les descripteurs. Parce que les développeurs vont te regarder comme si tu étais fou : « Quels descripteurs ? Nous écrivons simplement dans stdout ». Les ingénieurs en infrastructure ont créé un copytruncate dans logrotate, qui fait simplement une copie du fichier et tronque l'original. Par conséquent, c'est souvent pendant ces processus de copie que l'espace disque se termine.
(4) Nous avions différents formats dans différentes API. Ils étaient légèrement différents, mais il fallait écrire des regexp variés. Comme tout cela était géré par Puppet, il y avait un gros ensemble de classes avec leurs propres problèmes. De plus, td-agent pouvait consommer beaucoup de mémoire la plupart du temps, ralentir ou simplement faire semblant de fonctionner sans rien faire. Il était impossible de savoir de l'extérieur qu'il ne faisait rien. Dans le meilleur des cas, il plantait, et quelqu'un le redémarrait ensuite. En fait, une alerte arrivait et quelqu'un devait le relancer à la main.
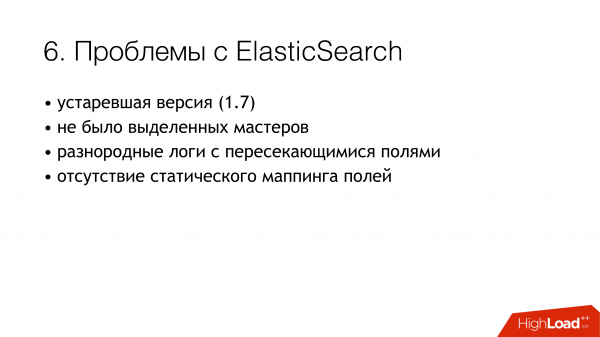
(6) Et le plus chaotique, c'était elasticsearch. Parce que c'était une ancienne version. À l'époque, nous n'avions pas de maîtres dédiés. Nous avions des journaux hétéroclites, avec des champs qui pouvaient se chevaucher. Différents journaux d'applications pouvaient avoir les mêmes noms de champs, mais à l'intérieur, les données pouvaient être différentes. Par exemple, un journal arrive avec un Integer dans le champ level. Un autre arrive avec une String dans le champ level. En l'absence de mappage statique, cela crée une situation intéressante. Si après la rotation de l'index dans elasticsearch, le premier message arrive avec une chaîne de caractères, tout fonctionne normalement. Mais si le premier est un Integer, tous les messages suivants qui arrivent avec une String sont simplement rejetés. Parce que le type de champ ne correspond pas.
Nous avons commencé à nous poser ces questions. Nous avons décidé de ne pas chercher de responsables.
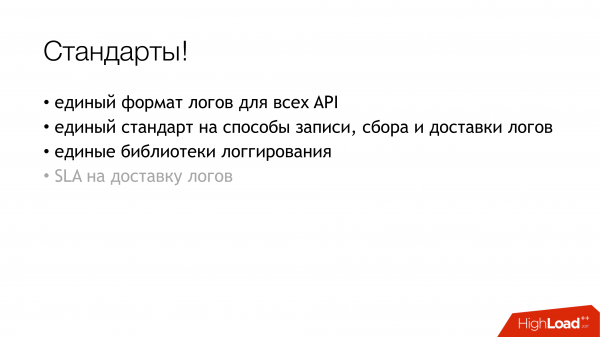
Il faut faire quelque chose ! Il est évident qu'il faut établir des normes. Certaines normes existaient déjà chez nous. D'autres ont été établies un peu plus tard. Heureusement, un format unique de journaux pour toutes les API avait déjà été approuvé à ce moment-là. Il est spécifié dans les normes d'interaction des services. Par conséquent, ceux qui souhaitent recevoir des journaux doivent les rédiger dans ce format. Si quelqu'un ne rédige pas des journaux dans ce format, cela signifie que nous ne garantissons rien.
Ensuite, nous aimerions établir une norme unique pour les méthodes d'enregistrement, de livraison et de collecte des journaux. En gros, où les écrire et comment les livrer. La situation idéale serait que tous les projets utilisent la même bibliothèque. Il existe une bibliothèque de journalisation distincte pour Go, et une autre pour PHP. Tous ceux qui sont avec nous doivent les utiliser. Actuellement, je dirais que nous y arrivons à 80 %. Mais certains continuent à manger des cactus.
Et là (sur la diapositive), on commence à peine à entrevoir le « SLA pour la livraison des journaux ». Il n'y en a pas encore, mais nous y travaillons. Parce que c'est très pratique lorsque l'infrastructure dit que si vous écrivez dans un certain format à un certain endroit et pas plus de N messages par seconde, nous allons les livrer avec une telle probabilité là-bas. Cela enlève beaucoup de maux de tête. Si le SLA existe, c'est vraiment formidable !
Comment avons-nous commencé à résoudre le problème ? Le principal obstacle était avec td-agent. On ne savait pas où allaient nos journaux. Sont-ils livrés ? Sont-ils collectés ? Où sont-ils en fait ? Par conséquent, le premier point a été de remplacer td-agent. J'ai brièvement esquissé les options pour le remplacer ici.
Fluentd. Premièrement, j'ai eu à l'utiliser dans mon emploi précédent, et il tombait aussi périodiquement en panne là-bas. Deuxièmement, c'est à peu près la même chose, mais en mieux.
Filebeat. Pourquoi était-il pratique pour nous ? Parce qu'il est écrit en Go, et nous avons une grande expertise en Go. Par conséquent, si nécessaire, nous pourrions l'adapter à nos besoins. C'est pourquoi nous ne l'avons pas choisi. Pour qu'il n'y ait même pas la tentation de commencer à le réécrire pour nous.
Une solution évidente pour un administrateur système reste divers syslogs en grande quantité (syslog-ng/rsyslog/nxlog).
Ou écrire quelque chose de spécifique, mais nous avons écarté cela, tout comme filebeat. Si nous devons écrire quelque chose, il vaut mieux que ce soit utile pour l'entreprise. Pour la livraison des journaux, il vaut mieux utiliser quelque chose de déjà prêt.
Par conséquent, le choix s'est essentiellement résumé à celui entre syslog-ng et rsyslog. Je me suis décidé en faveur de rsyslog simplement parce que nous avions déjà des classes pour rsyslog dans Puppet, et je n'ai pas trouvé de différence évidente entre les deux. Que ce soit pour syslog ici ou là. Oui, la documentation de certains est moins bonne, celle d'autres est meilleure. L'un sait faire cela, et l'autre — cela différemment.
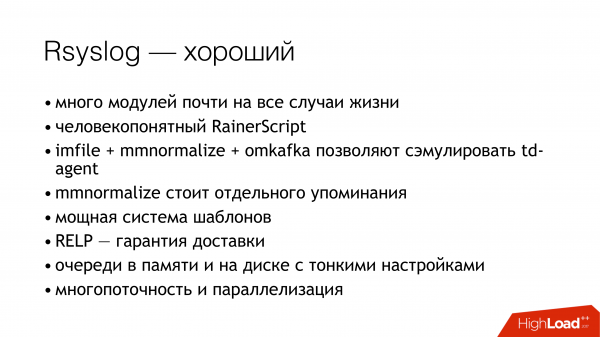
Et un peu sur rsyslog. Tout d'abord, il est génial, car il a de nombreux modules. Il dispose d'un RainerScript compréhensible par l'homme (un langage de configuration moderne). Un avantage fantastique est que nous avons pu simuler le comportement de td-agent avec des moyens standard, et pour les applications, rien n'a changé. C'est-à-dire que nous remplaçons td-agent par rsyslog, et tout le reste reste inchangé. Et nous avons immédiatement une livraison fonctionnelle. De plus, mmnormalize est une fonctionnalité impressionnante de rsyslog. Elle permet de parser les logs, mais pas avec Grok et regexp. Elle crée un arbre de syntaxe abstrait. Elle parse les logs de la même manière qu'un compilateur parse des sources. Cela permet de travailler très rapidement, de consommer peu de CPU, et c'est vraiment quelque chose de génial. Il y a plein d'autres avantages. Je ne vais pas m'arrêter dessus.
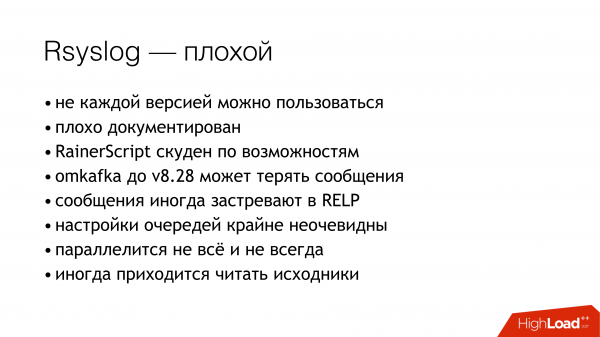
Rsyslog a aussi plein de défauts. Ils sont à peu près les mêmes que les avantages. Les principaux problèmes sont qu'il faut savoir le configurer, et qu'il faut choisir la bonne version.
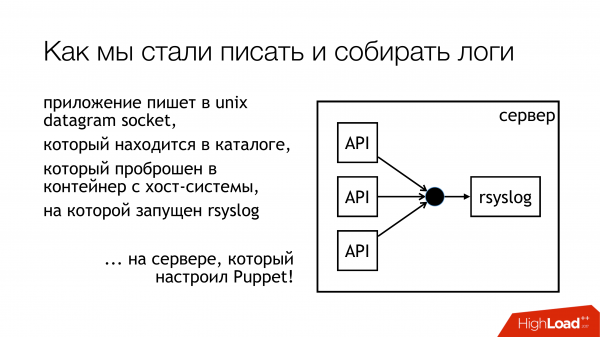
Nous avons décidé d'écrire les logs dans un socket unix. D'ailleurs, pas dans /dev/log, car là nous avons un mélange de logs système, il y a journald dans ce pipeline. Donc, écrivons dans un socket personnalisé. Nous allons le connecter à un ruleset séparé. Nous ne ferons rien d'obscur. Ce sera tout transparent et compréhensible. En fait, c'est ce que nous avons fait. Le répertoire de ces sockets est standardisé et est rendu accessible dans tous les conteneurs. Les conteneurs peuvent voir le socket dont ils ont besoin, l'ouvrir et y écrire.
Pourquoi pas un fichier ? Parce que tout le monde a lu , qui tentait de transférer un fichier dans docker, et se rendait compte qu'après le redémarrage, rsyslog changeait le descripteur de fichier, et docker perdait ce fichier. Il garde ouvert quelque chose d'autre, mais ce n'est plus le socket où l'on écrit. Nous avons décidé que nous contournerions ce problème, et, en même temps, nous contournerions le problème de verrouillage.
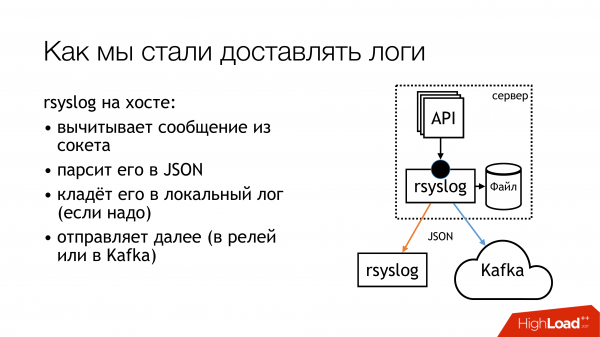
Rsyslog effectue les actions indiquées sur la diapositive et envoie les logs soit à un relais, soit à Kafka. Kafka correspond à l'ancienne méthode. Le relais — c'est moi qui ai essayé d'utiliser uniquement rsyslog pour la livraison des logs. Sans Message Queue, avec les moyens standards de rsyslog. En principe, cela fonctionne.
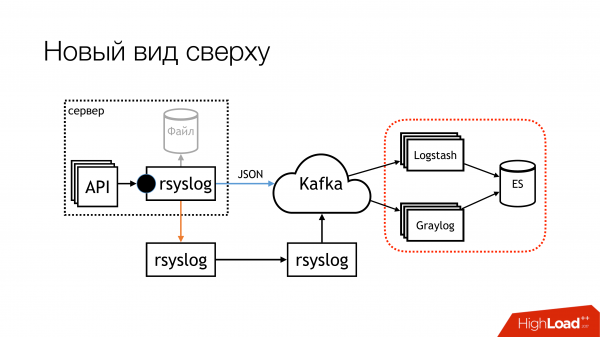
Mais il y a des nuances sur la manière de les intégrer dans cette partie (Logstash/Graylog/ES). Cette partie (rsyslog-rsyslog) est utilisée entre les centres de données. Ici, il y a un lien TCP compressé, qui permet d'économiser de la bande passante et, par conséquent, d'augmenter la probabilité que nous recevions des logs d'un autre centre de données lorsque le canal est saturé. Parce que, nous avons l'Indonésie, où tout va mal. Là-bas, c'est un problème constant.
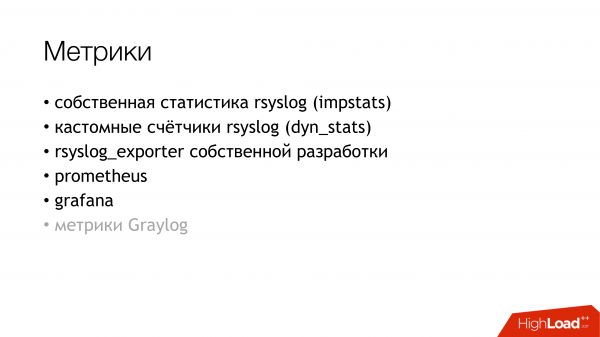
Nous avons réfléchi à comment surveiller, avec quelle probabilité les logs que nous avons enregistrés depuis l'application atteignent leur destination. Nous avons décidé d'établir des métriques. Rsyslog a son propre module de collecte de statistiques, qui contient certains compteurs. Par exemple, il peut vous montrer la taille de la file d'attente, ou combien de messages sont arrivés dans telle ou telle action. À partir de là, nous pouvons tirer quelque chose. De plus, il a des compteurs personnalisés que l'on peut configurer, et il vous montrera, par exemple, le nombre de messages qu'un certain API a enregistrés. Ensuite, j'ai écrit un rsyslog_exporter en Python, et nous avons tout envoyé vers Prometheus et construit des graphiques. Les métriques de Graylog étaient très souhaitées, mais pour l'instant, nous n'avons pas eu le temps de les configurer.
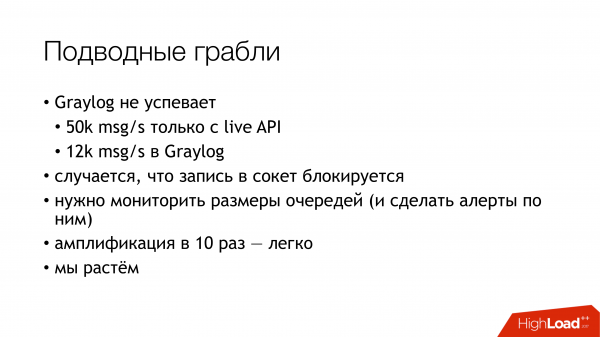
Quels problèmes avons-nous rencontrés ? Les problèmes sont survenus lorsque nous avons découvert (SURPRISE !) que nos API Live écrivent 50 000 messages par seconde. C'est seulement l'API Live sans staging. Et Graylog ne nous montre que 12 000 messages par seconde. La question légitime s'est posée : où sont les restes ? D'où nous avons déduit que Graylog ne s'en sortait tout simplement pas. Nous avons regardé, et en effet, Graylog avec Elasticsearch ne géraient pas ce flux.
Ensuite, d'autres découvertes que nous avons faites pendant le processus.
Les écritures dans le socket sont bloquées. Comment cela s'est-il produit ? Lorsque j'ai utilisé rsyslog pour la livraison, à un moment donné, notre canal entre les centres de données s'est cassé. La livraison s'est arrêtée à un endroit, et à un autre endroit également. Tout cela a impacté la machine avec l'API, qui écrit dans le socket rsyslog. La file d'attente a été remplie. Ensuite, la file d'attente d'écriture dans le socket Unix, qui par défaut est de 128 paquets, s'est remplie. Et le prochain write() dans l'application est bloqué. Lorsque nous avons regardé dans la bibliothèque que nous utilisons dans nos applications Go, il était écrit que l'écriture dans le socket se fait en mode non-bloquant. Nous étions sûrs que rien n'était bloqué. Parce que nous avons lu. , qui en a parlé. Mais il y a un moment. Autour de cet appel, il y avait aussi une boucle infinie, où une tentative continue d'insérer un message dans le socket se produisait. C'est cela que nous n'avons pas remarqué. Nous avons dû réécrire la bibliothèque. Depuis lors, elle a été modifiée plusieurs fois, mais maintenant nous avons éliminé les blocages dans tous les sous-systèmes. Donc, nous pouvons arrêter rsyslog, et rien ne tombera.
Nous devons surveiller la taille des files d'attente, ce qui aide à éviter ces pièges. Premièrement, nous pouvons surveiller quand nous commençons à perdre des messages. Deuxièmement, nous pouvons surveiller si nous avons des problèmes de livraison en général.
Et un autre point désagréable — l'amplification de 10 fois dans une architecture microservices — c'est très facile. Nous n'avons pas tant de demandes entrantes, mais à cause du graphe sur lequel ces messages se déplacent, en raison des logs d'accès, nous augmentons réellement la charge des logs d'environ dix fois. Malheureusement, je n'ai pas eu le temps de calculer les chiffres exacts, mais les microservices — c'est comme ça. Il faut en tenir compte. Il s'avère qu'actuellement, le sous-système de collecte des logs est le plus sollicité chez Lazada.
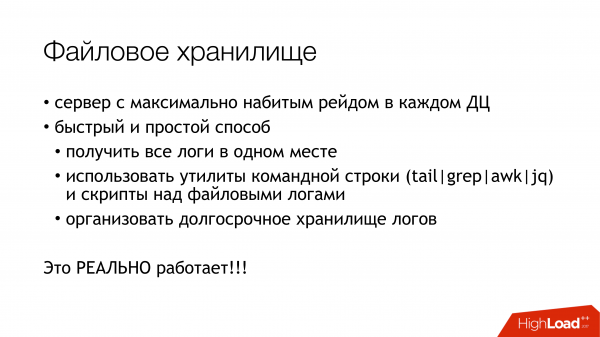
Comment résoudre le problème d'elasticsearch ? Si vous devez rapidement obtenir les logs en un seul endroit, sans courir à travers toutes les machines, et ne pas les collecter là-bas, utilisez un stockage de fichiers. Cela fonctionne de manière garantie. Cela peut se faire à partir de n'importe quel serveur. Il suffit de brancher des disques et de mettre en place syslog. Après cela, vous aurez tous les logs garantis en un seul endroit. Ensuite, vous pourrez configurer tranquillement elasticsearch, graylog ou autre chose. Mais vous aurez déjà tous les logs, et vous pourrez les conserver aussi longtemps que l'espace disque le permet.
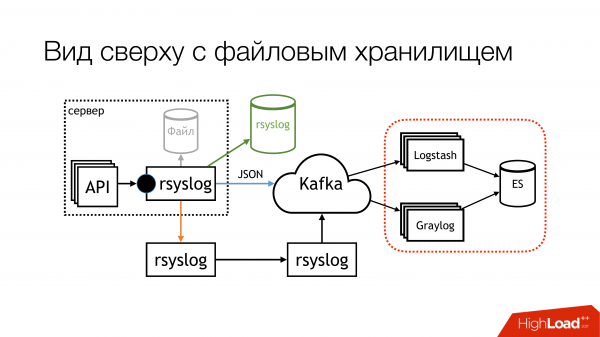
Au moment de ma présentation, le schéma est devenu comme ça. Nous avons presque cessé d'écrire dans le fichier. Maintenant, nous allons probablement désactiver les restes. Sur les machines locales, sur lesquelles les API sont lancées, nous cesserons d'écrire dans les fichiers. Premièrement, il existe un stockage de fichiers qui fonctionne très bien. Deuxièmement, sur ces machines, l'espace finit constamment, il faut le surveiller en permanence.
Cette partie avec Logstash et Graylog, elle est vraiment gênante. Donc, il faut s'en débarrasser. Il faut choisir quelque chose d'unique.
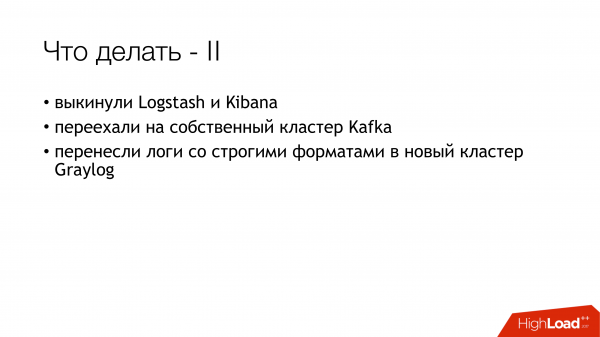
Nous avons décidé de nous débarrasser de Logstash et de Kibana. Pourquoi ? Parce que nous avons un département de sécurité. Quel rapport ? Le lien est que Kibana sans X-Pack et sans Shield ne permet pas de restreindre les droits d'accès aux logs. C'est pourquoi nous avons choisi Graylog. Tout cela est compris. Je n'aime pas, mais cela fonctionne. Nous avons acheté un nouveau matériel, installé une version récente de Graylog et transféré tous les logs avec des formats stricts dans un Graylog séparé. Nous avons résolu le problème des différents types de champs identiques organisationnellement.
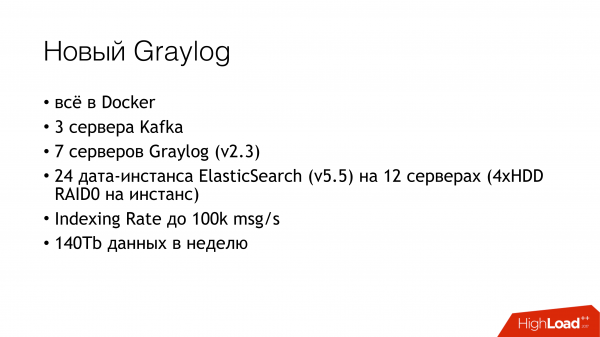
Que contient donc le nouveau Graylog ? Nous avons simplement tout enregistré dans Docker. Nous avons pris une multitude de serveurs, déployé trois instances de Kafka, 7 serveurs Graylog version 2.3 (car nous voulions la version 5 d'Elasticsearch). Tout cela a été mis en place sur des RAID avec des HDD. Nous avons observé un taux d'indexation allant jusqu'à 100 000 messages par seconde. Nous avons constaté que nous avions 140 téraoctets de données par semaine.
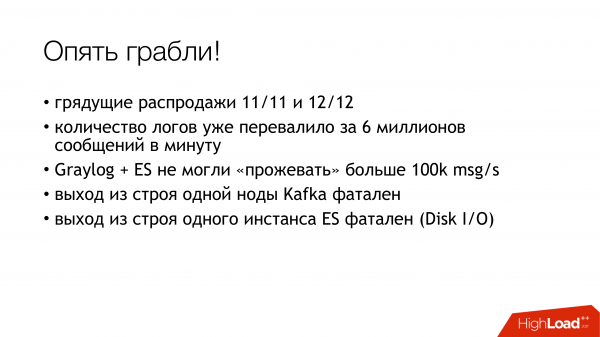
Et encore des obstacles ! Nous avons deux ventes à venir. Nous avons dépassé les 6 millions de messages. Graylog n'arrive pas à suivre. Il faut encore survivre.
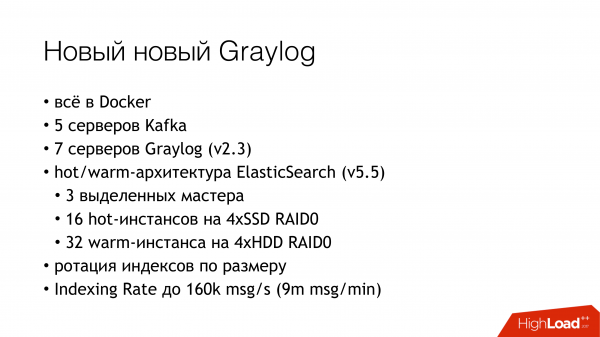
Nous avons survécu de cette manière. Nous avons ajouté un peu plus de serveurs et de SSD. Actuellement, nous vivons comme cela. Nous traitons déjà 160 000 messages par seconde. Nous ne sommes pas encore arrivés au plafond, donc nous ne savons pas combien nous pourrons réellement tirer de tout cela.
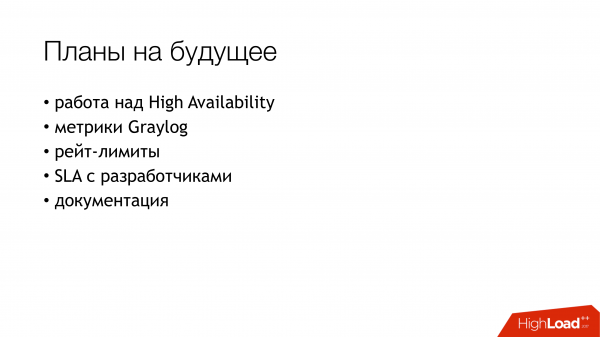
Voici nos projets pour l'avenir. Parmi eux, la haute disponibilité est peut-être la plus importante. Nous ne l'avons pas encore. Plusieurs machines sont configurées de la même manière, mais tout passe pour l'instant par une seule machine. Il faut prendre le temps de configurer un basculement entre elles.
Collecter des métriques avec Graylog.
Mettre en place une limite de taux afin qu'une API défaillante ne déséquilibre pas notre bande passante et tout le reste.
Et enfin, signer un SLA avec les développeurs, stipulant que nous pouvons gérer un certain volume. Si vous en écrivez plus, navré.
Et rédiger de la documentation.
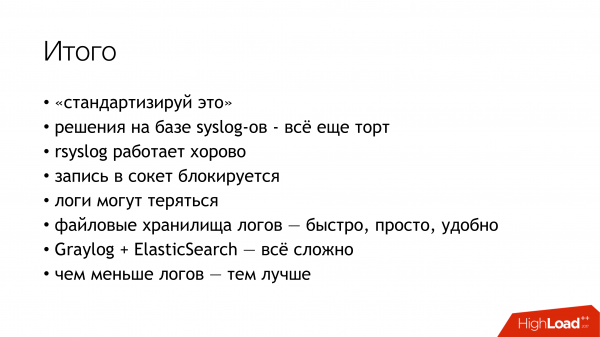
En résumé, voici les points clés de tout ce que nous avons traversé. Tout d'abord, les normes. Deuxièmement, le syslog — c'est le meilleur. Troisièmement, rsyslog fonctionne exactement comme indiqué sur la diapositive. Et passons aux questions.
Questions.
Question: Pourquoi, en fin de compte, n'avez-vous pas décidé de prendre… (filebeat ?)
Réponse: Il faut écrire dans un fichier. Je n'étais vraiment pas en faveur. Lorsque votre API envoie des milliers de messages par seconde, même si vous effectuez une rotation toutes les heures, ce n'est pas une option. On pourrait écrire dans un pipe. À quoi les développeurs m'ont demandé : « Que se passe-t-il si le processus dans lequel nous écrivons s'arrête ? » Je n'ai tout simplement pas trouvé de réponse et j'ai dit : « D'accord, abandonnons cette idée. »
Question: Pourquoi ne vous écrivez-vous pas simplement des journaux dans HDFS ?
Réponse: C'est la prochaine étape. Nous y avons pensé au tout début, mais comme nous n'avons actuellement pas les ressources pour nous en occuper, cela reste une solution à long terme.
Question: Un format en colonnes serait plus approprié.
Réponse: Je comprends tout. Nous sommes « pour » à 100 %.
Question: Vous écrivez dans rsyslog. Cela fonctionne avec TCP et UDP. Mais si c'est UDP, comment garantissez-vous la livraison ?
Réponse: Il y a deux aspects. D'abord, je dis toujours à tout le monde que nous ne garantissons pas la livraison des journaux. Quand les développeurs arrivent et disent : « Que diriez-vous d'écrire des données financières là-bas, et vous les stockez pour nous au cas où quelque chose se produirait », nous leur répondons : « Excellent ! Commencez par bloquer l'écriture dans le socket et faites-le en transactions, pour vous assurer que vous nous l'avez bien mis dans le socket et que nous l'avons reçu de l'autre côté. » À ce moment-là, tout le monde se rend compte que c'est compliqué. Si ce n’est pas nécessaire, alors pourquoi aurait-on des questions ? Si vous ne voulez pas garantir l'écriture dans le socket, pourquoi devrions-nous garantir la livraison ? Nous faisons de notre mieux. Nous essayons réellement de livrer autant que possible, mais nous ne donnons pas de garantie à 100 %. Donc évitez d'écrire des données financières là-dedans. Il y a des bases de données pour cela, avec des transactions.
Question: Lorsque l'API génère un message dans les journaux et transmet le contrôle aux microservices, avez-vous rencontré le problème que les messages de différents microservices arrivent dans le désordre ? Cela crée de la confusion.
Réponse: C'est normal qu'ils arrivent dans un ordre différent. Il faut s'y préparer. En effet, toute livraison réseau ne garantit pas l'ordre, ou il faut consacrer des ressources spécifiquement à cela. Si nous parlons de systèmes de fichiers, chaque API sauvegarde les journaux dans son propre fichier. En fait, rsyslog les range par répertoire. Chaque API a ses propres journaux, où l’on peut aller voir, et ensuite les comparer par timestamp. S'ils vont consulter Graylog, là ils seront triés par timestamp. Tout ira bien.
Question: Le timestamp peut varier de quelques millisecondes.
Réponse: Le timestamp est généré par l’API elle-même. C'est toute l'idée. Nous avons un NTP. L’API génère le timestamp directement dans le message. Ce n'est pas rsyslog qui l'ajoute.
Question: Il n'est pas très clair comment se fait l'interaction entre les centres de données. Au sein d'un centre de données, il est clair comment les journaux sont collectés et traités. Comment se passe l'interaction entre les centres de données ? Chaque centre de données vit-il sa propre vie ?
Réponse: Presque. Chaque pays est situé dans un seul centre de données. Actuellement, nous n'avons pas de répartition où un pays serait hébergé dans différents centres de données. Donc, il n'est pas nécessaire de les combiner. À l'intérieur de chaque centre, il y a un Log Relay. C'est un serveur Rsyslog. En fait, il y a deux machines de gestion. Elles sont configurées de la même manière. Mais pour l'instant, le trafic passe par l'une d'elles. Elle agrège tous les journaux. Elle a une file d'attente sur disque au cas où. Elle compresse les journaux et les envoie au centre de données central (de Singapour), où ils sont ensuite envoyés à Graylog. Et chaque centre de données a son propre stockage de fichiers. En cas de perte de connexion, nous avons tous les journaux là-bas. Ils y resteront. Ils seront sauvegardés.
Question: Recevez-vous des journaux de là en cas de situations exceptionnelles ?
Réponse: On peut y aller (dans le stockage de fichiers) et les vérifier.
Question: Comment surveillez-vous le fait de ne pas perdre des journaux ?
Réponse: En réalité, nous en perdons, et nous le surveillons. La surveillance a été lancée il y a un mois. Dans la bibliothèque utilisée par l'API Go, il y a des métriques. Elle permet de compter combien de fois elle n'a pas pu écrire dans le socket. Actuellement, il y a une heuristique astucieuse. Il y a un tampon. Il essaie d'écrire un message dans le socket à partir de celui-ci. Si le tampon déborde, il commence à les jeter. Et il compte combien il a jeté. Si les compteurs commencent à déborder, nous en serons informés. Ils arrivent maintenant également dans Prometheus, et dans Grafana, on peut voir les graphiques. Des alertes peuvent être configurées. Mais pour l'instant, il n'est pas clair à qui les envoyer.
Question: Dans Elasticsearch, vous stockez les journaux avec redondance. Combien de répliques avez-vous ?
Réponse: Une réplique.
Question: C'est uniquement une réplique ?
Réponse: C'est un maître et une réplique. Les données sont stockées en deux exemplaires.
Question: Avez-vous ajusté la taille du tampon Rsyslog d'une manière ou d'une autre ?
Réponse: Nous écrivons des datagrammes dans un socket Unix personnalisé. Cela nous impose immédiatement une limitation de 128 Ko. Nous ne pouvons pas y écrire plus. Nous avons consigné cela dans la norme. Ceux qui veulent accéder aux stockages écrivent 128 Ko. Les bibliothèques, d'ailleurs, coupent et mettent un drapeau indiquant que le message a été tronqué. Dans notre standard de message, il y a un champ spécial qui indique s'il a été tronqué lors de l'écriture ou non. Ainsi, nous avons la possibilité de suivre ce moment.
Question: Écrivez-vous des JSON corrompus ?
Réponse: Un JSON corrompu sera rejeté soit lors du relais, car le paquet est trop gros. Soit il sera rejeté par Graylog, car il ne pourra pas parser le JSON. Mais il y a des nuances à corriger, et elles sont principalement liées à rsyslog. J'y ai déjà rempli plusieurs problèmes qui doivent encore être traités.
Question: Pourquoi Kafka ? Avez-vous essayé RabbitMQ ? Graylog ne fonctionne pas avec cette charge ?
Réponse: Nous avons des difficultés avec Graylog. Mais Graylog fonctionne pour nous. Il est vraiment problématique. C'est une chose particulière. Et, en réalité, il n'est pas nécessaire. Je préférerais écrire directement depuis rsyslog dans Elasticsearch et ensuite voir dans Kibana. Mais il faut résoudre la question avec les personnes de la sécurité. C'est une option possible pour notre développement, lorsque nous abandonnerons Graylog et utiliserons Kibana. Il n'y a pas de sens à utiliser Logstash. Parce que, je peux faire tout cela avec rsyslog. Et il a un module pour écrire dans Elasticsearch. Avec Graylog, nous essayons de vivre d'une manière ou d'une autre. Nous l'avons même un peu optimisé. Mais il y a encore de la place pour des améliorations.
Concernant Kafka. Historiquement, c'était comme ça. Quand je suis arrivé, elle existait déjà, et les logs y étaient déjà écrits. Nous avons simplement configuré notre cluster et y avons transféré les logs. Nous le gérons, nous savons comment il fonctionne. Concernant RabbitMQ... ça ne fonctionne pas avec RabbitMQ. En revanche, RabbitMQ fonctionne bien chez nous. Il est en production et nous avons eu des problèmes avec. Avant cette vente, il a été réglé et il fonctionne correctement maintenant. Mais auparavant, je n'étais pas prêt à le déployer en production. Il y a un autre point. Graylog peut lire la version AMQP 0.9, tandis que rsyslog peut écrire la version AMQP 1.0. Il n'y a pas de solution qui gère les deux. Il faut choisir l'un ou l'autre. Donc pour le moment, c'est uniquement Kafka. Mais il y a aussi des nuances. Parce que omkafka de la version de rsyslog que nous utilisons peut perdre tout le buffer de messages récupérés de rsyslog. Pour l'instant, nous faisons avec.
Question: Vous utilisez Kafka parce qu'elle était déjà là ? N'est-elle pas utilisée à d'autres fins ?
Réponse: Kafka, qui était là, est utilisée par l'équipe Data Science. C'est un projet totalement séparé, dont je suis désolé de ne rien savoir. Je ne suis pas au courant. Elle était sous la gestion de l'équipe Data Science. Lorsqu'ils ont commencé à enregistrer les logs, ils ont décidé de l'utiliser plutôt que d'en installer une nouvelle. Maintenant, nous avons mis à jour Graylog et nous avons perdu la compatibilité car il y a une ancienne version de Kafka. Nous avons dû créer la nôtre. En même temps, nous avons éliminé ces quatre topics pour chaque API. Nous avons créé un large topic pour tout le live, un autre large topic pour tout le staging et nous envoyons simplement tout là-dedans. Graylog en extrait tout cela en parallèle.
Question: Pourquoi ce besoin de magie avec les sockets ? Avez-vous essayé d'utiliser le log-driver syslog pour les conteneurs ?
Réponse: À l'époque où nous nous posions cette question, notre relation avec Docker était tendue. C'était Docker 1.0 ou 0.9. Docker en lui-même était étrange. Deuxièmement, si nous y incluons aussi les logs... J'ai un soupçon non vérifié qu'il fait passer tous les logs par lui, par le démon Docker. Si une API devient folle, les autres APIs se retrouvent coincées car elles ne peuvent pas envoyer stdout et stderr. Je ne sais pas ce que cela va entraîner. J'ai un sentiment intuitif qu'il ne faut pas utiliser le driver syslog de Docker à cet endroit. Notre département de tests fonctionnels a son propre petit cluster Graylog avec des logs. Ils utilisent les drivers de logs de Docker et il semble que tout va bien de leur côté. Mais ils envoient directement les GELF dans Graylog. À l'époque où nous avons lancé tout ça, nous avions juste besoin que cela fonctionne. Peut-être qu'un jour quelqu'un viendra nous dire qu'il fonctionne correctement depuis longtemps, et alors nous essayerons.
Question: Vous faites la livraison entre les centres de données avec rsyslog. Pourquoi pas avec Kafka ?
Réponse: Nous faisons en fait les deux. Pour deux raisons. Si le canal est vraiment défaillant, même nos logs compressés ne passent pas. Kafka permet simplement de les perdre en cours de route. Avec cette méthode, nous évitons que ces logs ne s'accumulent. Dans ce cas, nous utilisons directement Kafka. Si notre canal est bon et que nous souhaitons le libérer, nous utilisons rsyslog. Mais en réalité, il est possible de le configurer pour qu'il supprime ce qui ne passe pas. Actuellement, nous utilisons directement rsyslog à certains endroits, et parfois Kafka.
Source : habr.com
