

Pavel Selivanov, architect des solutions chez Southbridge et instructeur de Slurm, a présenté une conférence à DevOpsConf 2019. Cette conférence fait partie d'un des sujets approfondis du cours sur Kubernetes « Slurm Mega ».
se déroule à Moscou du 18 au 20 novembre.
— Moscou, du 22 au 24 novembre.
sont toujours disponibles.
Sous le lien — transcription de la conférence.
Bonjour à tous, collègues et sympathisants. Aujourd'hui, je vais parler de la sécurité.
Je constate qu'il y a beaucoup de spécialistes de la sécurité dans la salle aujourd'hui. Je m'excuse à l'avance si j'utilise des termes du domaine de la sécurité qui ne sont pas conformes à vos habitudes.
Il se trouve qu'il y a environ six mois, j'ai eu entre les mains un cluster Kubernetes public. Public — cela signifie qu'il y a un certain nombre d'espaces de noms, dans lesquels il y a des utilisateurs, isolés dans leur propre espace de noms. Tous ces utilisateurs appartiennent à différentes entreprises. Eh bien, il était prévu d'utiliser ce cluster comme CDN. C'est-à-dire qu'on vous donne un cluster, on vous attribue un utilisateur, vous arrivez dans votre espace de noms et déployez vos frontaux.
Ma précédente entreprise a tenté de vendre un tel service. Et on m'a demandé de tester le cluster pour voir si cette solution convenait ou non.
Je suis donc arrivé dans ce cluster. On m'a donné des droits limités, un espace de noms limité. Les personnes là-bas comprenaient ce qu'était la sécurité. Ils savaient ce qu'était le contrôle d'accès basé sur les rôles (RBAC) dans Kubernetes — et ils l'ont configuré de telle sorte que je ne pouvais pas exécuter des pods séparément des déploiements. Je ne me souviens pas de la tâche que j'essayais de résoudre en lançant un pod sans déploiement, mais j'avais très envie de lancer simplement un pod. J'ai décidé par chance de vérifier quels droits j'avais dans le cluster, ce que je pouvais faire, ce que je ne pouvais pas faire, ce qu'ils avaient configuré. J'en profiterai aussi pour expliquer ce qui n'est pas configuré correctement dans leur RBAC.
Il s'est avéré qu'après deux minutes, j'ai obtenu les droits d'administrateur sur leur cluster, j'ai regardé dans tous les espaces de noms voisins et j'ai vu des frontaux de production en cours d'exécution, provenant d'entreprises qui avaient déjà acheté le service et s'étaient déployées. J'ai failli me retenir de venir sur le front de quelqu'un et de mettre un mot vulgaire sur la page d'accueil.
Je vais expliquer avec des exemples comment j'ai fait cela et comment s'en protéger.
Mais d'abord, permettez-moi de me présenter. Je m'appelle Pavel Selivanov. Je suis architecte chez Southbridge. Je m'y connais en Kubernetes, DevOps et dans les dernières technologies tendances. Mes collègues ingénieurs chez Southbridge s'occupent de tout cela, et je fais office de consultant.
En plus de notre activité principale, nous avons récemment lancé des projets appelés Slurm. Nous essayons de partager notre expertise sur Kubernetes avec le grand public et d'apprendre à d'autres à utiliser K8s.
De quoi je vais parler aujourd'hui. Le sujet de ma présentation est évident — la sécurité des clusters Kubernetes. Mais je tiens à préciser que c'est un sujet très vaste — et donc je vais tout de suite dire ce dont je ne parlerai pas. Je ne vais pas aborder les termes déjà mille fois vus sur Internet, comme le RBAC et les certificats.
Je vais parler de ce qui nous préoccupe, mes collègues et moi, en ce qui concerne la sécurité des clusters Kubernetes. Nous voyons ces problèmes chez les fournisseurs de clusters Kubernetes et chez les clients qui viennent à nous. Même chez les clients qui viennent d'autres entreprises de consulting en administration. En réalité, l'ampleur du problème est énorme.
Je vais aborder trois points aujourd'hui :
- Les droits des utilisateurs vs les droits des pods. Les droits des utilisateurs et les droits des pods ne sont pas la même chose.
- Collecte d'informations sur le cluster. Je montrerai comment il est possible de recueillir toutes les informations nécessaires sur un cluster sans avoir de droits particuliers.
- Attaque DoS sur le cluster. Si nous ne pouvons pas collecter d'informations, nous pouvons néanmoins rendre le cluster inutilisable. Je parlerai des attaques DoS sur les composants de gestion du cluster.
Une autre chose générale que je mentionnerai — sur quoi j'ai testé tout ça, sur quoi je peux affirmer que cela fonctionne.
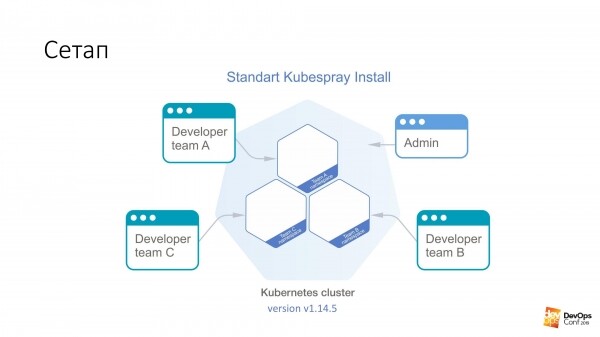
Nous prenons comme base l'installation d'un cluster Kubernetes via Kubespray. Pour ceux qui ne le savent pas, c'est en fait un ensemble de rôles pour Ansible. Nous l'utilisons constamment dans notre travail. C'est bien car on peut l'installer n'importe où — que ce soit sur du matériel ou dans le cloud. Une méthode d'installation convient en principe à tout.
Dans ce cluster, j'aurai Kubernetes v1.14.5. L'ensemble du cluster Kube que nous allons examiner est divisé en espaces de noms, chaque espace de noms appartenant à une équipe distincte, avec accès uniquement pour les membres de cette équipe. Ils ne peuvent pas entrer dans d'autres espaces de noms, seulement dans le leur. Il existe cependant un compte administrateur qui a des droits sur l'ensemble du cluster.
J'avais promis que notre première étape serait d'obtenir les droits d'administration sur le cluster. Nous avons besoin d'un pod spécialement préparé qui va compromettre le cluster Kubernetes. Tout ce que nous avons à faire, c'est de l'appliquer au cluster Kubernetes.
kubectl apply -f pod.yamlCe pod atterrira sur l'un des maîtres du cluster Kubernetes. Ensuite, le cluster nous renverra joyeusement un fichier nommé admin.conf. Ce fichier contient tous les certificats de l'administrateur, ainsi que la configuration de l'API du cluster. Voilà comment on peut facilement obtenir un accès administratif, je pense que cela fonctionne pour 98 % des clusters Kubernetes.
Je le répète, ce pod a été créé par un développeur dans votre cluster, qui a la possibilité de déployer ses propositions dans un petit espace de noms, tout en étant limité par RBAC. Il n'avait aucun droit particulier. Cependant, le certificat est quand même revenu.
À présent, parlons du pod spécialement préparé. Nous le lançons sur n'importe quelle image. Par exemple, utilisons debian:jessie.
Nous avons cette configuration :
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Qu'est-ce qu'une tolérance ? Les maîtres dans le cluster Kubernetes sont généralement marqués par une caractéristique appelée taint ("contamination" en anglais). L'idée de cette "contamination" est qu'aucun pod ne peut être affecté aux nœuds maîtres. Mais rien n'empêche un pod d'indiquer qu'il est tolérant à cette "contamination". La section Toleration indique justement que si un certain nœud a NoSchedule, alors notre pod est tolérant à cette contamination - et il n'y a aucun problème.
Ensuite, nous précisons que notre pod n'est pas seulement tolérant, mais qu'il souhaite en fait être affecté spécifiquement à un maître. Parce que sur les maîtres se trouvent les éléments les plus précieux dont nous avons besoin - tous les certificats. Nous spécifions donc nodeSelector - et nous avons une étiquette standard sur les maîtres qui permet de sélectionner parmi tous les nœuds du cluster ceux qui sont des maîtres.
Avec ces deux sections, le pod arrivera certainement sur le maître. Et il sera autorisé à y résider.
Mais simplement arriver sur le maître ne suffit pas. Cela ne nous apportera rien. Donc, plus loin, nous avons ces deux éléments :
hostNetwork: true
hostPID: true
Nous indiquons que notre pod, que nous déployons, vivra dans l'espace de noms du nœud, dans l'espace de noms réseau et dans l'espace de noms PID. Une fois le pod lancé sur le maître, il pourra voir toutes les interfaces réelles et vivantes de ce nœud, écouter tout le trafic et voir les PID de tous les processus.
Ensuite, il ne reste plus qu'à prendre etcd et à lire ce que vous voulez.
Le plus intéressant est cette fonctionnalité de Kubernetes qui est présente par défaut.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Et l'essence de cette fonctionnalité est que nous pouvons, dans le pod que nous lançons, même sans droits sur ce cluster, spécifier que nous voulons créer un volume de type hostPath. Cela signifie prendre un chemin depuis l'hôte sur lequel nous allons nous exécuter — et le prendre comme volume. Et ensuite, nous le nommons name: host. Ce hostPath est monté à l'intérieur du pod. Dans cet exemple, dans le répertoire /host.
Je répète encore une fois. Nous avons dit au pod d'arriver sur le maître, d'obtenir hostNetwork et hostPID — et de monter tout le root du maître à l'intérieur de ce pod.
Vous comprenez qu'au niveau de Debian, nous avons un bash qui s'exécute en tant que root. Cela signifie que nous venons d'obtenir les privilèges root sur le maître, sans avoir de droits dans le cluster Kubernetes.
La tâche suivante consiste à entrer dans le pod dans le répertoire /host /etc/kubernetes/pki, si je ne me trompe pas, et à récupérer tous les certificats du maître du cluster et, par conséquent, à devenir l'administrateur du cluster.
Si on y regarde de plus près, ce sont quelques-unes des permissions les plus dangereuses dans les pods — peu importe les droits de l'utilisateur :
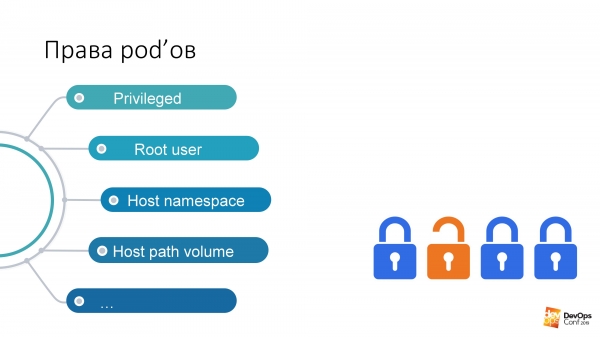
Si j'ai le droit de lancer un pod dans un espace de noms du cluster, alors ce pod a ces droits par défaut. Je peux lancer des pods privilégiés, et cela signifie pratiquement avoir tous les droits, presque un accès root sur le nœud.
Mon préféré — l'utilisateur root. Et Kubernetes a cette option Exécuter En Tant Que Non-Root. C'est une sorte de protection contre les hackers. Savez-vous ce qu'est un « virus moldave » ? Si vous êtes un hacker et que vous venez dans mon cluster Kubernetes, alors nous, pauvres administrateurs, vous demandons : « Veuillez indiquer, s'il vous plaît, dans vos pods, par lesquels vous allez pirater mon cluster, exécuter en tant que non-root. Sinon, vous risquez de lancer un processus dans votre pod sous root, et il vous sera très facile de me pirater. Protégez-vous, s'il vous plaît, vous-même ».
Le volume host path — à mon avis, c'est le moyen le plus rapide d'obtenir le résultat souhaité du cluster Kubernetes.
Mais que faire avec tout cela ?
Une réflexion qui devrait venir à l'esprit de tout administrateur normal confronté à Kubernetes : « Ah, je l'avais dit, Kubernetes ne fonctionne pas. Il a des failles. Et tout ça, c'est nul ». En réalité, il existe un truc qu'on appelle la documentation, et si l'on y jette un coup d'œil, il y a une section .
C'est un objet yaml — que nous pouvons créer dans un cluster Kubernetes — qui contrôle les aspects de sécurité spécifiquement dans la description des pods. Autrement dit, il contrôle effectivement les droits d'utilisation de divers hostNetwork, hostPID, et certains types de volumes qui existent dans les pods lors du démarrage. Avec la Pod Security Policy, tout cela peut être décrit.
Ce qui est intéressant dans la Pod Security Policy, c'est que dans le cluster Kubernetes, tous les installateurs de PSP ne sont pas définis, ils sont tout simplement désactivés par défaut. La Pod Security Policy s'active grâce à un plugin d'admission.
D'accord, déployons la Pod Security Policy dans le cluster, disons que nous avons certains pods de service dans un namespace, auxquels seuls les administrateurs ont accès. Disons que dans tous les autres pods, les droits sont limités. Parce qu'il est probable que les développeurs n'ont pas besoin de lancer des pods privilégiés dans votre cluster.
Et il semblerait que tout va bien. Et notre cluster Kubernetes ne peut pas être compromis en deux minutes.
Il y a un problème. Très probablement, si vous avez un cluster Kubernetes, un système de surveillance est installé dans votre cluster. Je parie même que si votre cluster a une surveillance, elle s'appelle Prometheus.
Ce que je vais dire maintenant sera valable aussi bien pour l'opérateur Prometheus que pour Prometheus installé dans sa forme pure. La question est que si je ne peux pas obtenir rapidement un administrateur dans le cluster, cela signifie que je dois chercher davantage. Et je peux chercher à l'aide de votre surveillance.
Il est probable que tout le monde ait lu les mêmes articles sur Habré, et que la surveillance se trouve dans le namespace monitoring. Le chart Helm de tout le monde s'appelle à peu près de la même manière. Je suppose que si vous faites helm install stable/prometheus, vous obtiendrez des noms à peu près similaires. Et il est même probable que je n'aurai pas à deviner le nom DNS dans votre cluster. Parce qu'il est standard.
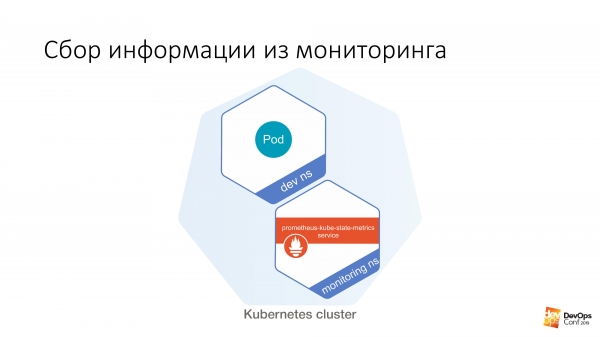
Ensuite, nous avons un namespace dev, dans lequel nous pouvons lancer un pod. Et ensuite, à partir de ce pod, il est très facile de faire cela :
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics est l'un des exporters de Prometheus, qui collecte des métriques depuis l'API de Kubernetes lui-même. Il y a beaucoup de données sur ce qui est en cours d'exécution dans votre cluster, ce que c'est, et quels problèmes vous pourriez rencontrer.
Prenons un exemple simple :
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
En effectuant une simple requête curl depuis un pod non privilégié, vous pouvez obtenir ce genre d'informations. Si vous ne savez pas quelle version de Kubernetes vous exécutez, elle vous le dira facilement.
Et ce qui est le plus intéressant, c'est qu'en plus d'appeler kube-state-metrics, vous pouvez également vous adresser directement à Prometheus. Vous pouvez collecter des métriques de là-bas. Théoriquement, vous pouvez même construire une requête depuis le cluster vers Prometheus qui pourrait simplement le désactiver. Et votre surveillance cesserait complètement de fonctionner dans le cluster.
La question se pose alors : est-ce qu'une surveillance externe surveille votre surveillance ? Je viens d'acquérir la possibilité d'agir dans le cluster Kubernetes sans aucune conséquences. Vous ne saurez même pas que j'agis là-bas, car la surveillance n'existe déjà plus.
Tout comme avec les PSP, on a l'impression que le problème vient de ces technologies à la mode — Kubernetes, Prometheus — qui semblent ne pas fonctionner et être pleines de failles. En réalité, ce n'est pas le cas.
Il existe une chose — .
Si vous êtes un administrateur raisonnable, vous savez probablement que Network Policy est un autre yaml, qu'il y en a déjà beaucoup dans le cluster. Et certaines politiques de réseau ne sont sûrement pas nécessaires. Et même si vous avez lu ce qu'est une Network Policy, que c'est un pare-feu yaml de Kubernetes qui permet de restreindre les droits d'accès entre les namespaces, entre les pods, vous avez sûrement décidé que le pare-feu au format yaml dans Kubernetes relève simplement d'abstractions supplémentaires... Non, ce n'est définitivement pas nécessaire.
Même si vos experts en sécurité ne vous ont pas informé qu'il est très facile de construire un pare-feu avec votre Kubernetes, et qu'il peut être très granulaire. S'ils ne le savent pas encore et ne vous sollicitent pas : « Allez, donnez, donnez… » Dans tous les cas, vous aurez besoin des Network Policies pour restreindre l'accès à certains espaces serveurs qui peuvent être sollicités depuis votre cluster sans aucune autorisation.
Comme dans l'exemple que j'ai donné, il est possible d'accéder aux kube state metrics de n'importe quel namespace dans le cluster Kubernetes sans avoir de droits. Les politiques réseau ont bloqué l'accès depuis tous les autres namespaces vers le namespace de surveillance, et voilà : pas d'accès, pas de problème. Dans tous les charts disponibles, tant dans le Prometheus standard que dans celui dédié à l'opérateur, il suffit d'activer l'option pour les policies réseau dans les valeurs Helm. Il suffit d'activer cela, et elles fonctionneront.
Il y a néanmoins un problème. En tant qu'administrateur raisonnable, vous avez probablement décidé que les policies réseau n'étaient pas nécessaires. Et après avoir lu plusieurs articles sur des ressources comme Habr, vous avez conclu que flannel, surtout en mode host-gateway, est la meilleure option que vous puissiez choisir.
Que faire ?
Vous pouvez essayer de redéployer la solution réseau que vous avez dans votre cluster Kubernetes et la remplacer par quelque chose de plus fonctionnel. Par exemple, Calico. Mais je veux tout de suite dire que changer la solution réseau dans un cluster Kubernetes en fonctionnement est assez complexe. Je l'ai résolu deux fois (dans les deux cas, cependant, théoriquement), mais nous avons même montré comment le faire lors des Slurm. Pour nos étudiants, nous avons montré comment changer la solution réseau dans un cluster Kubernetes. En principe, vous pouvez essayer de le faire de telle manière qu'il n'y ait pas de temps d'arrêt sur le cluster de production. Mais il est probable que cela ne fonctionne pas.
Et le problème se résout en fait très simplement. Il y a des certificats dans le cluster, et vous savez que vos certificats vont expirer dans un an. Eh bien, la solution normale avec les certificats dans le cluster est : pourquoi s'embêter, nous allons simplement mettre en place un nouveau cluster à côté, laissant l'ancien expirer, et nous déploierons tout de nouveau. Certes, lorsque l'ancien expirera, il sera hors service pendant une journée, mais au moins, nous aurons un nouveau cluster.
Lorsque vous mettrez en place un nouveau cluster, n’oubliez pas d’intégrer Calico au lieu de flannel.
Que faire si vos certificats sont valables pour cent ans et que vous ne prévoyez pas de redéployer le cluster ? Il existe un outil appelé Kube-RBAC-Proxy. C'est un développement très intéressant qui permet de s'intégrer, en tant que conteneur sidecar, à n'importe quel pod dans un cluster Kubernetes. Il ajoute en fait une autorisation via RBAC de Kubernetes à ce pod.
Il y a un problème. Auparavant, dans l'opérateur Prometheus, cette solution Kube-RBAC-Proxy était intégrée. Mais ce n'est plus le cas. Les versions modernes reposent sur le fait que vous avez une politique réseau et que vous les utilisez pour bloquer l'accès. Par conséquent, il faudra légèrement modifier le chart. En fait, si vous allez dans , il y a des exemples d'utilisation en tant que sidecars, et il faudra modifier le chart au minimum.
Il y a aussi un petit autre problème. Ce n'est pas seulement Prometheus qui expose ses métriques à tout le monde. Tous nos composants du cluster Kubernetes peuvent également fournir leurs propres métriques.
Mais comme je l'ai déjà dit, si vous ne pouvez pas accéder au cluster et collecter des informations, vous pouvez au moins causer des problèmes.
Je vais donc rapidement vous montrer deux façons de nuire à la santé d'un cluster Kubernetes.
Vous allez rire lorsque je vais vous en parler, ce sont deux cas de la vie réelle.
Première méthode. Épuisement des ressources.
Nous allons lancer un autre pod spécial. Il aura une section comme celle-ci.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Comme vous le savez, les requests correspondent à la quantité de CPU et de mémoire qui est réservée pour des pods spécifiques avec des requests. Si nous avons un hôte à quatre cœurs dans le cluster Kubernetes, et qu'un pod arrive avec des requests de quatre CPUs, cela signifie qu'aucun autre pod avec des requests ne pourra arriver sur cet hôte.
Si je lance un tel pod, puis que je fais la commande :
$ kubectl scale special-pod --replicas=...Alors personne ne pourra se déployer dans le cluster Kubernetes. Parce que toutes les nodes seront à court de requests. De cette manière, j'arrêterai votre cluster Kubernetes. Si je fais cela le soir, je peux arrêter les déploiements pendant un bon moment.
Si nous consultons à nouveau la documentation de Kubernetes, nous y trouverons un concept appelé Limit Range. Il définit les ressources pour les objets du cluster. Vous pouvez écrire un objet Limit Range en YAML, l'appliquer à certains espaces de noms — et ensuite, dans cet espace de noms, vous pouvez spécifier que vous avez des ressources par défaut, maximales et minimales pour les pods.
Avec cette fonctionnalité, nous pouvons limiter les utilisateurs dans des espaces de noms de produits spécifiques en ce qui concerne leurs capacités à indiquer certaines choses sur leurs pods. Mais malheureusement, même si vous dites à l'utilisateur qu'il ne doit pas lancer de pods avec des requêtes supérieures à un CPU, il existe une commande fantastique pour le scale, ou bien à travers le tableau de bord, ils peuvent effectuer un scale.
Et de là découle la deuxième méthode. Lançons 11 111 111 111 111 pods. C'est onze milliards. Ce n'est pas que j'ai inventé ce nombre, c'est quelque chose que j'ai réellement vu.
Une histoire réelle. Tard dans la soirée, je m'apprêtais à quitter le bureau. Je vois dans un coin un groupe de développeurs qui s'affairent devant leurs ordinateurs portables. Je m'approche d'eux et je demande : « Que vous est-il arrivé ? »
Un peu plus tôt, vers neuf heures du soir, l'un des développeurs se préparait à rentrer chez lui. Il a décidé : « Je vais faire un scale de mon application à un ». Il a appuyé sur un, et internet a légèrement ralenti. Il a de nouveau appuyé sur un, a appuyé sur un, a cliqué sur Entrée. Il a essayé tout ce qu'il pouvait. À ce moment-là, internet s'est réveillé — et tout a commencé à se mettre à l'échelle jusqu'à ce nombre.
En réalité, cette histoire ne se passait pas sur Kubernetes, à l'époque c'était Nomad. Cela s'est terminé par des heures de tentatives pour arrêter Nomad de ses tentatives obstinées de scalabilité, Nomad a répondu qu'il ne cesserait pas de scaler et qu'il ne ferait rien d'autre. « Je suis fatigué, je pars. » Et il s'est replié.
Naturellement, j'ai essayé de faire la même chose sur Kubernetes. Onze milliards de pods n'ont pas ravi Kubernetes, il a dit : « Je ne peux pas. Ça dépasse les limites internes. » Mais un milliard de pods a fonctionné.
En réponse à un milliard de pods, il n'est pas entré dans Kubernetes. Il a vraiment commencé à s'étendre. Plus le processus avançait, plus il lui fallait de temps pour créer de nouveaux pods. Mais le processus avançait toujours. Le seul problème est que si je peux lancer des pods à volonté dans mon espace de noms, même sans requêtes ni limites, je pourrais lancer avec certaines tâches un nombre de pods tel que ces tâches commenceront à saturer les nœuds en mémoire et en CPU. Lorsque je lance autant de pods, les informations doivent être stockées, c'est-à-dire dans etcd. Et quand trop d'informations y entrent, le stockage commence à répondre beaucoup trop lentement — et Kubernetes commence à ralentir.
Et il y a un autre problème... Comme vous le savez, les composants de gestion de Kubernetes ne sont pas une seule pièce centrale, mais plusieurs composants. Parmi eux se trouvent le contrôleur de gestion, le planificateur, etc. Tous ces éléments commenceront à travailler simultanément sur des tâches inutiles et peu productives, ce qui prendra de plus en plus de temps à mesure que le temps passe. Le contrôleur de gestion créera de nouveaux pods. Le planificateur tentera de leur trouver un nouveau nœud. Les nouveaux nœuds dans votre cluster seront probablement bientôt épuisés. Le cluster Kubernetes commencera à fonctionner de plus en plus lentement.
Mais j'ai décidé d'aller encore plus loin. Comme vous le savez, dans Kubernetes, il existe une chose appelée service. Eh bien, par défaut, dans vos clusters, le service fonctionne probablement avec des IP tables.
Si vous lancez un milliard de pods, par exemple, puis que vous forcez Kubernetes à créer de nouveaux services avec un script :
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
Sur tous les nœuds du cluster, de nouvelles règles iptables seront générées presque simultanément. En effet, pour chaque service, un milliard de règles iptables seront générées.
J'ai testé cela sur quelques milliers, jusqu'à une dizaine. Et le problème est qu'à ce stade, il devient assez problématique de se connecter en SSH à un nœud. Parce que les paquets, en passant par un tel nombre de chaînes, ne se comportent pas très bien.
Et tout cela peut également être résolu à l'aide de Kubernetes. Il existe un objet appelé Resource quota. Il définit le nombre de ressources et d'objets disponibles pour un namespace dans le cluster. Nous pouvons créer un objet yaml dans chaque namespace du cluster Kubernetes. Grâce à cet objet, nous pouvons définir qu'un certain nombre de requêtes et de limites sont alloués à ce namespace, et nous pouvons ensuite indiquer qu'il est possible de créer 10 services et 10 pods dans ce namespace. Et le développeur peut même se faire des soucis en soirée. Kubernetes lui dira : « Vous ne pouvez pas augmenter vos pods à ce nombre, car cela dépasse le quota de ressources ». Voilà, le problème est résolu. .
Un problème se pose à ce sujet. Vous ressentez à quel point il devient difficile de créer un namespace dans Kubernetes. Pour le créer, nous devons tenir compte de beaucoup de choses.
Resource quota + Limit Range + RBAC
• Création du namespace
• Création d'une limitrange à l'intérieur
• Création d'un resourcequota à l'intérieur
• Création d'un serviceaccount pour CI
• Création d'un rolebinding pour CI et utilisateurs
• Lancement optionnel des pods de service nécessaires
C'est pourquoi, profitant de l'occasion, je voudrais partager mes développements. Il existe un outil appelé opérateur SDK. C'est une façon d'écrire des opérateurs pour Kubernetes dans le cluster. Vous pouvez écrire des opérateurs en utilisant Ansible.
Au départ, nous avions écrit sur Ansible, puis j'ai vu qu'il existait un opérateur SDK et j'ai réécrit le rôle Ansible en opérateur. Cet opérateur permet de créer dans le cluster Kubernetes un objet appelé commande. À l'intérieur de cette commande, il permet de décrire en yaml l'environnement pour cette commande. Et à l'intérieur de l'environnement de la commande, il permet de décrire combien de ressources nous allouons.
Petite .
Et en conclusion. Que faire de tout cela ?
D'abord. La Pod Security Policy - c'est bien. Et même si aucun des installateurs de Kubernetes ne les utilise encore à ce jour, il est néanmoins nécessaire de les utiliser dans vos clusters.
La Network Policy - ce n'est pas une autre fonctionnalité inutile. C'est quelque chose dont on a réellement besoin dans le cluster.
LimitRange/ResourceQuota - il est temps de les utiliser. Nous avons commencé à les utiliser depuis longtemps, et j'étais convaincu que tout le monde les appliquait. Il s'est avéré que c'est assez rare.
En plus de ce que j'ai mentionné lors de mon discours, il y a des fonctionnalités non documentées qui permettent d'attaquer le cluster. Cela a été récemment publié. .
Certaines choses sont tellement tristes et choquantes. Par exemple, dans certaines conditions, les kubelets dans le cluster Kubernetes peuvent exposer le contenu du répertoire des warlocks à un utilisateur non autorisé.
Il y a des instructions sur la façon de reproduire tout ce que j'ai présenté. Il y a des fichiers avec des exemples de production, montrant à quoi ressemblent ResourceQuota et Pod Security Policy. Et tout cela peut être exploré.
Merci à tous.
Source : habr.com
