

Je partage mon expérience personnelle sur où, quand et comment cela a été utile. De manière sommaire et sous forme de points clés, pour que ce soit clair sur quoi et où explorer davantage — mais ici, il s'agit uniquement de mon expérience subjective, qui pourrait être très différente de la vôtre.
Pourquoi est-il important de connaître et de savoir utiliser les langages de requêtes ? Fondamentalement, dans le domaine de la Data Science, il y a plusieurs étapes cruciales, et la première et la plus importante (sans elle, rien ne fonctionnera !) est l'obtention ou l'extraction des données. Le plus souvent, les données sont quelque part sous une forme quelconque et il faut les « extraire ».
Les langages de requêtes permettent justement d'extraire ces données ! Aujourd'hui, je vais vous parler des langages de requêtes qui m'ont été utiles et voir où et comment — pourquoi c'est nécessaire pour l'apprentissage.
Nous allons aborder trois blocs principaux de types de requêtes de données dans cet article :
- Les langages de requêtes « standards » — ceux auxquels on pense généralement en parlant de langages de requêtes, tels que l'algèbre relationnelle ou SQL.
- Les langages de requêtes par scripts : par exemple, des outils Python comme pandas, numpy ou le shell scripting.
- Les langages de requêtes pour les graphes de connaissances et les bases de données graphiques.
Tout ce qui est écrit ici est simplement une expérience personnelle sur ce qui a été utile, avec des descriptions de situations et « pourquoi cela était nécessaire » — chacun peut se projeter dans la mesure où de telles situations peuvent se présenter à vous et essayer de s'y préparer à l'avance, en se familiarisant avec ces langages avant d'être contraint de les utiliser en (urgence) dans un projet ou de se retrouver sur un projet où ils sont nécessaires.
Langages de requêtes « standards »
Les langages de requêtes standards sont ceux auxquels nous pensons généralement lorsque nous parlons de requêtes.
Algèbre relationnelle
Pourquoi l'algèbre relationnelle est-elle nécessaire aujourd'hui ? Pour avoir une bonne compréhension de pourquoi les langages de requêtes sont conçus d'une certaine manière et les utiliser de manière consciente, il est nécessaire de comprendre le noyau qui les sous-tend.
Qu'est-ce que l'algèbre relationnelle ?
La définition formelle est la suivante : l'algèbre relationnelle est un système fermé d'opérations sur des relations dans un modèle de données relationnel. En des termes plus accessibles, c'est un système d'opérations sur des tables, de sorte que le résultat est toujours également une table.
Voir toutes les opérations relationnelles dans article de Habr — ici, nous décrivons pourquoi il est important de connaître et où cela peut être utile.
Pourquoi ?
Vous commencez à comprendre sur quoi se basent en réalité les langages de requêtes et quelles opérations sous-tendent les expressions de langages de requêtes spécifiques — cela donne souvent une compréhension plus approfondie de ce qui fonctionne et comment cela fonctionne dans les langages de requêtes.
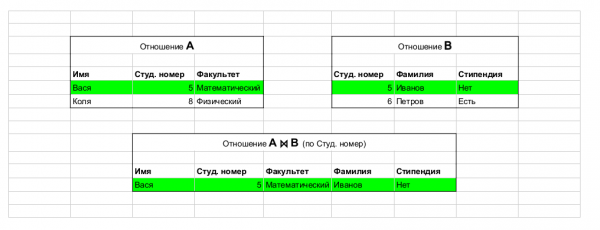
Extrait de articles. Exemple d'opération : join, qui combine des tables.
Matériaux pour l'étude :
. Il existe en général une vaste quantité de matériels sur l'algèbre relationnelle et la théorie — Coursera, Udacity. Il y a aussi une énorme quantité de ressources en ligne, y compris de bons . Mon conseil personnel : il est essentiel de bien comprendre l'algèbre relationnelle — c'est la base.
SQL
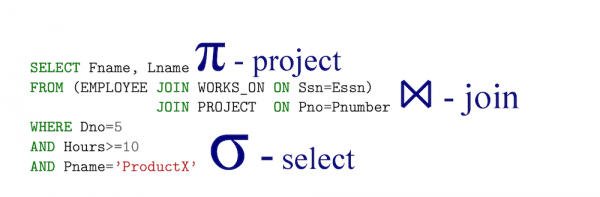
Extrait de articles.
SQL est essentiellement une implémentation de l'algèbre relationnelle — avec une importante précision, SQL est déclaratif ! Cela signifie qu'en écrivant une requête dans le langage de l'algèbre relationnelle, vous indiquez en réalité comment il faut calculer — tandis qu'avec SQL, vous spécifiez ce que vous voulez extraire, et ensuite le SGBD génère (efficacement) des expressions dans le langage de l'algèbre relationnelle (leur équivalence est connue sous le ).
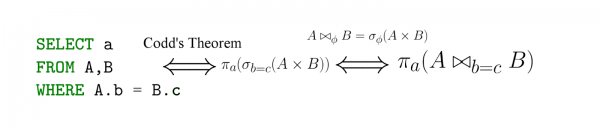
Extrait de articles.
Pourquoi ?
SGBD relationnels : Oracle, Postgres, SQL Server, etc. — ils sont encore omniprésents et il y a de fortes chances que vous deviez interagir avec eux, ce qui signifie que vous devrez soit lire du SQL (ce qui est très probable), soit écrire en SQL (ce qui est également assez probable).
Que lire et étudier
Dans les mêmes liens ci-dessus (sur l'algèbre relationnelle), il y a une incroyable quantité de matériel, par exemple, .
Au fait, qu'est-ce que NoSQL ?
« Il convient de souligner une fois de plus que le terme « NoSQL » a une origine absolument spontanée et n'a pas de définition largement acceptée ni d'institution académique derrière lui. » Correspondant sur Habr.
Essentiellement, les gens ont réalisé que le modèle relationnel complet n'est pas nécessaire pour résoudre de nombreux problèmes, en particulier pour ceux où, par exemple, la performance est cruciale et où dominent certaines requêtes simples avec agrégation — il est essentiel de calculer rapidement des métriques et de les enregistrer dans la base de données, tandis que la plupart des fonctionnalités relationnelles se sont révélées non seulement inutiles, mais même nuisibles — pourquoi normaliser quelque chose si cela compromet ce qui est le plus important pour nous (pour une tâche particulière) — la performance ?
Il faut souvent des schémas flexibles plutôt que des schémas mathématiques fixes du modèle relationnel classique - et cela simplifie énormément le développement d'applications, lorsqu'il est crucial de déployer un système et de commencer à travailler rapidement, en traitant les résultats - ou le schéma et les types de données stockées ne sont pas si importants.
Par exemple, nous créons un système d'expertise et souhaitons stocker des informations sur un domaine spécifique avec certaines métainformations - nous pouvons ne pas connaître tous les champs et simplement stocker des JSON pour chaque enregistrement - cela nous offre un environnement très flexible pour étendre le modèle de données et itérer rapidement - donc dans ce cas, NoSQL sera même préféré et plus lisible. Un exemple d'enregistrement (d'un de mes projets, où NoSQL était exactement là où il le fallait).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Vous pouvez en lire plus sur NoSQL.
Que doit-on étudier ?
Ici, il faut plutôt bien analyser votre tâche, quelles sont ses propriétés et quels systèmes NoSQL peuvent correspondre à cette description - et ensuite étudier ce système.
Langages de script pour les requêtes
Au début, il semble que Python n'ait rien à voir avec cela - c'est un langage de programmation, pas vraiment des requêtes.
- Pandas est véritablement un couteau suisse de la Data Science, un grand nombre de transformations de données, d'agrégations, etc. se fait en lui.
- Numpy - calculs vectoriels, matrices et algèbre linéaire s'y trouvent.
- Scipy - beaucoup de mathématiques dans ce package, surtout statistiques.
- Jupyter lab - beaucoup d'exploration de données se prêtent bien aux notebooks - il est utile de savoir faire.
- Requests - travail avec le réseau.
- Pyspark - très populaire parmi les ingénieurs de données, vous serez probablement amené à interagir avec cela ou Spark, simplement en raison de leur popularité.
- *Selenium - très utile pour collecter des données de sites et de ressources, parfois il n'y a tout simplement pas d'autre moyen d'obtenir les données.
Mon principal conseil : apprenez Python !
Pandas
Prenons comme exemple le code suivant :
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Calculer et renommer les agrégations
all_together = (df[df['trip_type'] == "return"]
    .groupby(['start_station_name','end_station_name'])
                   	    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': 'min_duration_seconds',
           'amax': 'max_duration_seconds'}))
En essence, nous voyons que le code s'inscrit dans un motif SQL classique.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Mais l'élément clé est que ce code fait partie d'un script et d'un pipeline, en fait, nous intégrons des requêtes dans le pipeline Python. Dans cette situation, le langage des requêtes nous vient de bibliothèques comme Pandas ou pySpark.
Dans l'ensemble, dans pySpark, nous voyons un type similaire de transformation des données à travers un langage de requêtes dans l'esprit de :
df.filter(df.trip_type = "return")
  .groupby("day")
  .agg({duration: 'mean'})
  .sort()
Où et quoi lire
À propos de Python en général de trouver des matériaux pour l'apprentissage. Il y a une énorme quantité de tutoriels en ligne sur , et des cours sur (ainsi que sur le propre ). En général, les matériaux se trouvent très facilement sur Google, et si je devais choisir un paquet sur lequel me concentrer, ce serait certainement pandas. Il y a aussi beaucoup de matériaux sur la combinaison DS+Python .
Shell comme langage de requêtes
De nombreux projets de traitement et d'analyse de données avec lesquels j'ai dû travailler sont en fait des scripts shell qui appellent du code Python, Java et les commandes shell elles-mêmes. Par conséquent, on peut considérer les pipelines dans bash/zsh/etc. comme une sorte de requête de haut niveau (on peut y intégrer des boucles, bien sûr, mais cela n'est pas typique pour le code DS dans les langages shell). Prenons un exemple simple — j'avais besoin de faire un mappage du QID de Wikidata et d'un lien complet vers les versions russe et anglaise de Wikipedia, pour cela j'ai écrit une simple requête à partir de commandes dans bash et pour la sortie j'ai écrit un simple script en Python que j'ai assemblé comme ça :
pv "data/latest-all.json.gz" |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py "output.csv"
où
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' C'était en fait tout le pipeline qui créait le mappage nécessaire, comme nous le voyons, tout fonctionnait en mode flux :
- pv filepath — donne une barre de progression basée sur la taille du fichier et passe son contenu plus loin
- unpigz -c lisait une partie de l'archive et la transmettaient à jq
- jq avec l'option — stream produisait immédiatement le résultat et le passait au post-processeur (tout comme avec le tout premier exemple) en Python
- le post-processeur lui-même — c'est une simple machine à états qui formate la sortie
Au total, un pipeline complexe fonctionnant en mode flux sur de grandes données (0,5 To), sans ressources substantielles et réalisé à partir d'un pipeline simple et de quelques outils.
Un autre conseil important : sachez travailler efficacement dans le terminal et écrire en bash/zsh/etc.
Où cela sera-t-il utile ? Pratiquement partout — les matériaux d'apprentissage sont d'ailleurs TRÈS nombreux en ligne. En particulier, voici mon précédent article.
R scripting
Encore une fois, le lecteur peut s'exclamer — mais c'est un langage de programmation complet ! Et il a bien raison. Cependant, j'ai généralement rencontré R dans un contexte tel que, en substance, cela ressemblait beaucoup à un langage de requêtes.
R est un environnement de calcul statistique et un langage de calcul et de visualisation statistiques (selon ).
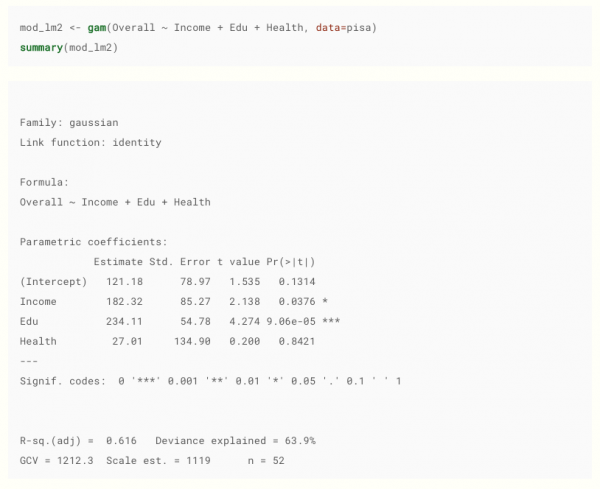
Pris de . Au fait, je recommande, c'est un bon matériel.
Pourquoi un data scientist doit-il connaître R ? Au moins parce qu'il y a un grand nombre de personnes en dehors de l'IT qui analysent des données en R. Je l'ai rencontré dans les domaines suivants :
- Le secteur pharmaceutique.
- Les biologistes.
- Le secteur financier.
- Des personnes ayant une formation purement mathématique, travaillant sur des statistiques.
- Des modèles statistiques spécialisés et des modèles d'apprentissage machine (qui se trouvent souvent uniquement dans une version auteur sous forme de package R).
Pourquoi est-ce en fait un langage de requêtes ? Dans la forme dans laquelle il est souvent rencontré - c'est en fait une requête pour créer un modèle, y compris la lecture des données et le réglage des paramètres de la requête (du modèle), et la visualisation des données dans des packages comme ggplot2 - c'est aussi une forme d'écriture de requêtes.
Exemple de requêtes pour la visualisation
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Dans l'ensemble, de nombreuses idées de R ont été intégrées dans des packages python, tels que pandas, numpy ou scipy, comme dataframes et vectorisation des données - donc en général, beaucoup de choses en R vous sembleront familières et pratiques.
Il y a beaucoup de ressources pour apprendre, par exemple, .
Graphes de connaissances (Knowledge graph)
Ici, j'ai une expérience un peu particulière, car je suis en fait souvent amené à travailler avec des graphes de connaissances et des langages de requêtes pour les graphes. Donc, nous passerons brièvement en revue les bases, car cette partie est un peu plus exotique.
Dans les bases de données relationnelles classiques, nous avons un schéma fixe — ici, le schéma est flexible, chaque prédicat est en fait une « colonne » et même plus.
Imaginez que vous deviez modéliser une personne et que vous vouliez décrire des choses clés, prenons comme exemple la description de Douglas Adams.
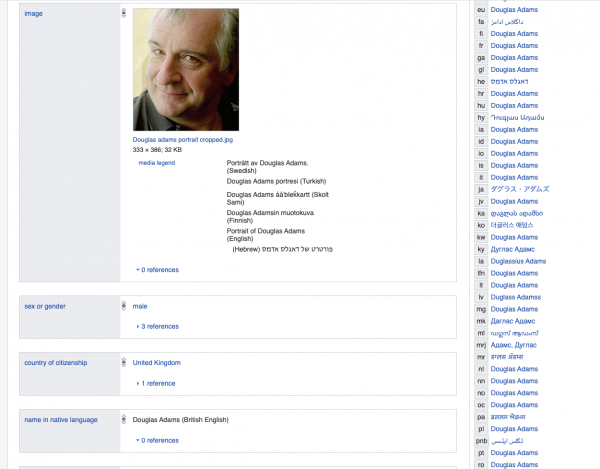
Si nous avions utilisé une base de données relationnelle, nous aurions dû créer une énorme table ou plusieurs tables avec un grand nombre de colonnes, dont la plupart seraient NULL ou remplies d'une valeur par défaut, par exemple, il est peu probable que beaucoup d'entre nous aient un enregistrement à la bibliothèque nationale coréenne — bien sûr, nous pourrions les extraire dans des tables séparées, mais cela serait en fin de compte une tentative de modéliser un schéma logique flexible avec des prédicats, à l'aide d'une base relationnelle fixe.
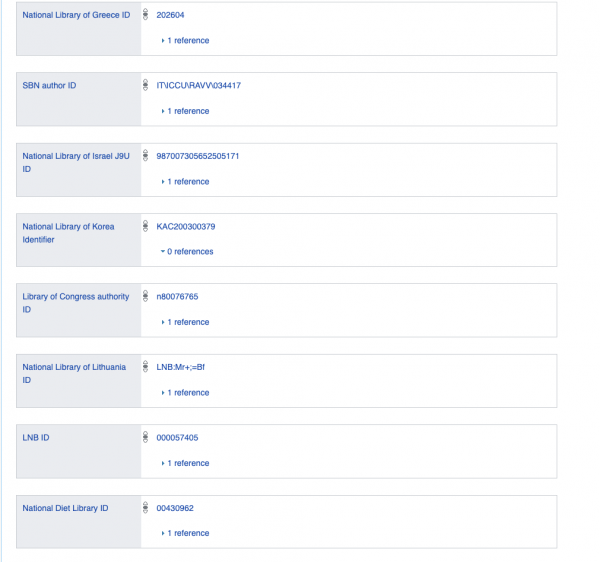
Donc, imaginez que toutes les données sont stockées sous forme de graphe ou sous forme d'expressions logiques binaires et unaires.
Où pouvez-vous être confronté à cela ? Tout d'abord, en travaillant avec , ainsi qu'avec n'importe quelle base de données graphique ou des données liées.
Voici les principaux langages de requête que j'ai dû utiliser et avec lesquels j'ai dû travailler.
SPARQL
Wiki :
SPARQL ( à partir de SPARQL Protocol and RDF Query Language) — , présentées selon le modèle , ainsi que pour transmettre ces requêtes et les réponses. SPARQL est une recommandation et l'une des technologies .
En réalité, c'est un langage de requête pour des prédicats logiques unaires et binaires. Il indique simplement ce qui est fixé dans l'expression logique et ce qui ne l'est pas (de manière très simplifiée).
La base RDF (Resource Description Framework), sur laquelle s'exécutent les requêtes SPARQL, est un triplet objet, prédicat, sujet — et la requête sélectionne les triples souhaités en fonction des contraintes spécifiées : trouver un X tel que p_55(X, q_33) est vrai — où, bien sûr, p_55 est une certaine relation avec l'identifiant 55, et q_33 est un objet avec l'identifiant 33 (c'est tout, en laissant encore de côté diverses détails).
Exemple de représentation de données :
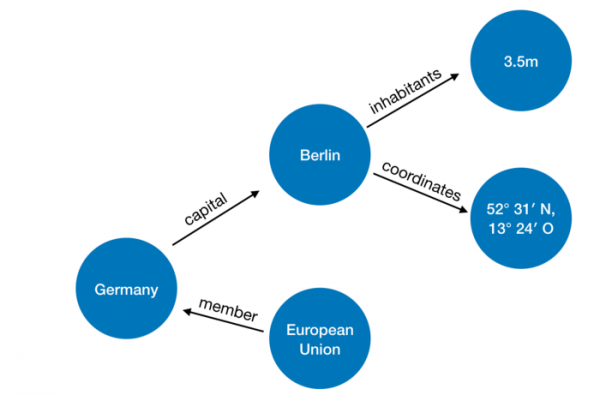
Images et exemple avec des pays ici .
Exemple d'une requête de base
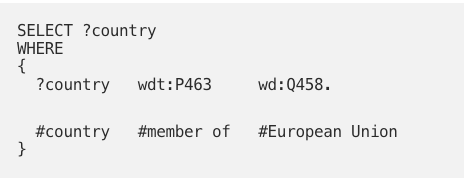
En fait, nous voulons trouver la valeur de la variable ?country, telle que pour le prédicat
member_of, il est vrai que member_of(?country,q458), et q458 est l'ID de l'Union européenne.
Exemple de requête SPARQL réelle dans le moteur python :
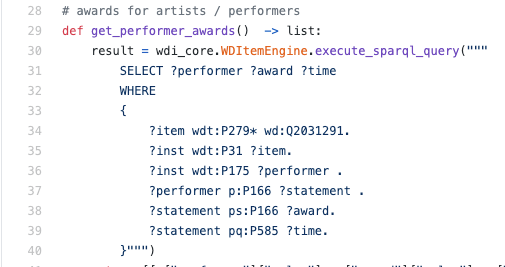
En général, je devais lire du SPARQL plutôt que d'écrire — dans cette situation, comprendre le langage au moins à un niveau de base peut s'avérer utile pour saisir comment les données sont extraites.
Il y a beaucoup de matériel en ligne pour apprendre : par exemple, voici et . J'utilise généralement Google pour rechercher des constructions et des exemples spécifiques, et pour l'instant, cela me suffit.
Langages de requêtes logiques
Pour en savoir plus sur le sujet, vous pouvez lire mon article . Ici, nous allons simplement examiner brièvement pourquoi les langages logiques sont particulièrement adaptés à l'écriture de requêtes. En fait, RDF est simplement un ensemble d'assertions logiques de la forme p(X) et h(X,Y), et une requête logique a la forme suivante :
output(X) :- country(X), member_of(X, "EU").
Ici, nous parlons de la création d'un nouveau prédicat output/1 (/1 signifie qu'il est unitaire), à condition que pour X, il soit vrai que country(X) — c'est-à-dire que X est un pays et aussi member_of(X, "EU").
Cela signifie que nos données et nos règles sont présentées de la même manière dans ce cas, ce qui permet de modéliser facilement et efficacement les tâches.
Où cela a été rencontré dans l'industrie: un grand projet avec une entreprise qui rédige des requêtes dans ce langage, ainsi que dans le projet actuel au cœur du système — cela semble assez exotique, mais cela se rencontre parfois.
Exemple d'un fragment de code dans un langage logique, traitant wikidata :
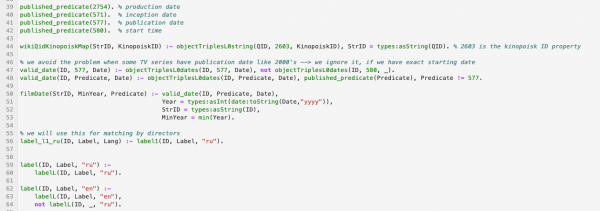
Matériaux : je vais ici fournir quelques liens vers le langage de programmation logique moderne Answer Set Programming — je recommande d'étudier celui-ci :
Source : habr.com
