

Dans mon travail, je suis souvent confronté à de nouvelles solutions techniques ou produits logiciels pour lesquels il existe peu d'informations sur Internet en langue française. Cet article vise à combler une telle lacune en prenant un exemple de ma pratique récente, où il a été nécessaire de configurer l'envoi d'événements CDC à partir de deux bases de données populaires (PostgreSQL et MongoDB) vers un cluster Kafka à l'aide de Debezium. J'espère que cet article de synthèse, rédigé suite à ce travail, sera utile à d'autres.
Qu'est-ce que Debezium et le CDC ?
est un représentant de la catégorie des logiciels CDC (), plus précisément, c'est un ensemble de connecteurs pour diverses bases de données compatibles avec le framework Apache Kafka Connect.
C'est sous licence Apache License v2.0 et sponsorisé par la société Red Hat. Le développement a débuté en 2016 et à ce jour, il soutient officiellement les bases de données suivantes : MySQL, PostgreSQL, MongoDB, SQL Server. Il existe également des connecteurs pour Cassandra et Oracle, mais actuellement, ils sont en statut « accès anticipé », et les nouvelles versions ne garantissent pas la compatibilité avec les anciennes.
Comparé à l'approche traditionnelle (où l'application lit directement les données de la base de données), les principaux avantages du CDC incluent la mise en œuvre d'un streaming des modifications de données au niveau des lignes avec une faible latence, une haute fiabilité et une disponibilité accrue. Ces deux derniers points sont réalisés grâce à l'utilisation d'un cluster Kafka comme stockage des événements CDC.
Parmi les autres avantages, on peut noter que la même représentation est utilisée pour stocker les événements, donc l'application finale n'a pas à se soucier des nuances d'exploitation de différentes bases de données.
Enfin, grâce à l'utilisation d'un courtier de messages, il devient possible d'évoluer horizontalement les applications qui surveillent les changements de données. L'impact sur la source de données est minimisé, car l'obtention des données ne se fait pas directement à partir de la base de données, mais à partir du cluster Kafka.
Concernant l'architecture de Debezium
L'utilisation de Debezium se résume à un schéma simple :
Base de données (comme source de données) → connecteur dans Kafka Connect → Apache Kafka → consommateur
À titre d'illustration, voici un schéma fourni sur le site du projet :
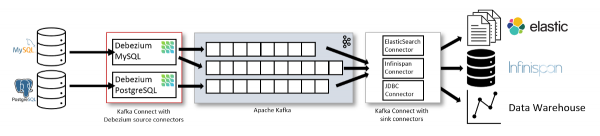
Cependant, ce schéma ne me plaît pas beaucoup, car il donne l'impression qu'il n'est possible d'utiliser que le connecteur sink.
En réalité, la situation est différente : le remplissage de votre Data Lake (le dernier maillon du schéma ci-dessus) — ce n'est pas le seul moyen d'utiliser Debezium. Les événements envoyés à Apache Kafka peuvent être utilisés par vos applications pour résoudre diverses situations. Par exemple :
- la suppression des données obsolètes du cache ;
- l'envoi de notifications ;
- les mises à jour des index de recherche ;
- une sorte de journaux d'audit ;
- …
Si vous avez une application Java et qu'il n'est pas nécessaire/possible d'utiliser un cluster Kafka, il existe également la possibilité de travailler via le . L'avantage évident est que vous pouvez vous passer d'infrastructures supplémentaires (sous la forme d'un connecteur et de Kafka). Cependant, cette solution est déclarée obsolète (deprecated) depuis la version 1.1 et n'est plus recommandée pour une utilisation (son support pourrait être retiré dans de futures versions).
Dans cet article, nous aborderons l'architecture recommandée par les développeurs, qui garantit la tolérance aux pannes et la capacité d'évoluer.
Configuration du connecteur
Pour commencer à suivre les changements de la valeur la plus importante — les données — nous aurons besoin de :
- une source de données, qui peut être MySQL à partir de la version 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- un cluster Apache Kafka ;
- une instance Kafka Connect (versions 1.x, 2.x) ;
- un connecteur Debezium configuré.
Les travaux sur les deux premiers points, c'est-à-dire le processus d'installation de la DBMS et d'Apache Kafka, ne sont pas abordés dans cet article. Toutefois, pour ceux qui souhaitent tout déployer dans un bac à sable, le dépôt officiel contenant des exemples propose un .
Nous allons nous concentrer davantage sur les deux derniers points.
0. Kafka Connect
Ici et dans la suite de l'article, tous les exemples de configuration sont examinés dans le contexte de l'image Docker distribuée par les développeurs de Debezium. Elle contient tous les fichiers de plugins nécessaires (connecteurs) et prévoit la configuration de Kafka Connect via des variables d'environnement.
Si l'utilisation de Kafka Connect de Confluent est envisagée, il faudra ajouter vous-même les plugins des connecteurs nécessaires dans le répertoire spécifié dans plugin.path ou défini via la variable d'environnement CLASSPATH. Les paramètres du worker Kafka Connect et des connecteurs sont définis via des fichiers de configuration, qui sont passés en tant qu'arguments à la commande de démarrage du worker. Pour plus de détails, voir .
L'ensemble du processus de configuration de Debezium avec un connecteur se fait en deux étapes. Examinons chacune d'elles :
1. Configuration du framework Kafka Connect
Pour le streaming de données vers un cluster Apache Kafka, des paramètres spécifiques doivent être définis dans le framework Kafka Connect, tels que :
- les paramètres de connexion au cluster,
- les noms des topics où sera stockée la configuration du connecteur,
- le nom du groupe dans lequel le connecteur est exécuté (en cas d'utilisation du mode distribué).
L'image Docker officielle du projet prend en charge la configuration via des variables d'environnement — et c'est ce que nous allons utiliser. Donc, téléchargeons l'image :
docker pull debezium/connectL'ensemble minimal de variables d'environnement nécessaire au démarrage du connecteur est le suivant :
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— liste de départ des serveurs du cluster Kafka pour obtenir la liste complète des membres du cluster ; -
OFFSET_STORAGE_TOPIC=connector-offsets— topic pour stocker les positions où se trouve actuellement le connecteur ; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— topic pour stocker l'état du connecteur et de ses tâches ; -
CONFIG_STORAGE_TOPIC=connector-config— topic pour stocker les données de configuration du connecteur et de ses tâches ; -
GROUP_ID=1— identifiant du groupe de workers sur lesquels la tâche du connecteur peut être exécutée ; nécessaire lors de l'utilisation du mode distribué (distribué) mode.
Nous lançons le conteneur avec ces variables :
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Remarque sur Avro
Par défaut, Debezium écrit des données au format JSON, ce qui est acceptable pour les environnements de test et les petits volumes de données, mais cela peut poser problème dans des bases de données à forte charge. Une alternative au convertisseur JSON est la sérialisation des messages à l'aide de en format binaire, ce qui permet de réduire la charge sur le sous-système I/O d'Apache Kafka.
Pour utiliser Avro, il est nécessaire de déployer un (pour stocker les schémas). Les variables pour le convertisseur seront comme suit :
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Les détails sur l'utilisation d'Avro et la configuration du registre dépassent le cadre de cet article — pour plus de clarté, nous utiliserons JSON.
2. Configuration du connecteur lui-même
Nous pouvons maintenant passer à la configuration du connecteur proprement dit, qui lira les données à partir de la source.
Prenons comme exemple des connecteurs pour deux SGBD : PostgreSQL et MongoDB, sur lesquels j'ai de l'expérience et qui présentent des différences (même petites, mais dans certains cas — significatives !)
La configuration est décrite dans la notation JSON et est chargée dans Kafka Connect par une requête POST.
2.1. PostgreSQL
Exemple de configuration du connecteur pour PostgreSQL :
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname": "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Le principe de fonctionnement du connecteur après cette configuration est plutôt simple :
- Lors du premier démarrage, il se connecte à la base de données indiquée dans la configuration et fonctionne en mode initial snapshot, envoyant dans Kafka l'ensemble initial des données récupérées par une requête
SELECT * FROM table_name. - Une fois l'initialisation terminée, le connecteur passe en mode lecture des changements à partir des fichiers WAL de PostgreSQL.
Concernant les options utilisées :
-
nom— nom du connecteur utilisé pour la configuration décrite ci-dessous ; ce nom sera ensuite utilisé pour interagir avec le connecteur (c'est-à-dire vérifier le statut / redémarrer / mettre à jour la configuration) via l'API REST de Kafka Connect ; -
connector.class— classe du connecteur SGBD qui sera utilisée par le connecteur configuré ; -
plugin.name— nom du plugin pour le décodage logique des données à partir des fichiers WAL. Les options disponibles sontwal2json,decoderbuffsetpgoutput. Les deux premiers nécessitent l'installation des extensions correspondantes dans le SGBD, tandis quepgoutputpour PostgreSQL version 10 et supérieure, aucune manipulation supplémentaire n'est nécessaire ; -
database.*— options pour se connecter à la base de données, oùdatabase.server.name— nom de l'instance PostgreSQL, utilisé pour former le nom du sujet dans le cluster Kafka ; -
table.include.list— liste des tables dont nous souhaitons suivre les modifications ; elle est spécifiée au formatschema.table_name; ne peut pas être utilisée avectable.exclude.list; -
heartbeat.interval.ms— intervalle (en millisecondes) avec lequel le connecteur envoie des messages heartbeat dans un sujet spécial ; -
heartbeat.action.query— requête qui sera exécutée lors de l'envoi de chaque message heartbeat (option introduite avec la version 1.1) ; -
slot.name— nom du slot de réplication qui sera utilisé par le connecteur ; publication.name— nom dans PostgreSQL, utilisée par le connecteur. Si elle n'existe pas, Debezium essaiera de la créer. Si l'utilisateur sous lequel la connexion est établie n'a pas suffisamment de droits pour cette action — le connecteur se terminera avec une erreur ;-
transformsdéfinit comment modifier le nom du sujet cible :-
transforms.AddPrefix.typeindique que nous allons utiliser des expressions régulières ; -
transforms.AddPrefix.regex— motif par lequel le nom du sujet cible est redéfini ; -
transforms.AddPrefix.replacement— ce à quoi nous redéfinissons effectivement.
-
En savoir plus sur le heartbeat et les transforms
Par défaut, le connecteur envoie des données vers Kafka à chaque transaction validée, et son LSN (Log Sequence Number) est enregistré dans un sujet de service offset. Mais que se passe-t-il si le connecteur est configuré pour lire non pas l'ensemble de la base de données, mais seulement certaines de ses tables (où les mises à jour des données ne se produisent pas souvent) ?
- Le connecteur lira les fichiers WAL et ne détectera pas de validation des transactions dans les tables qu'il surveille.
- Par conséquent, il ne mettra pas à jour sa position actuelle ni dans le sujet, ni dans le slot de réplication.
- Cela, à son tour, conduira à la "rétention" des fichiers WAL sur le disque et au risque d'épuiser tout l'espace disque.
Et ici, les options viennent à la rescousse. heartbeat.interval.ms et heartbeat.action.queryL'utilisation de ces options en tandem permet, à chaque fois qu'un message heartbeat est envoyé, d'exécuter une requête de modification des données dans une table séparée. Cela permet de mettre à jour en permanence le LSN sur lequel le connecteur se trouve actuellement (dans le slot de réplication). Cela permet à la SGBD de supprimer les fichiers WAL qui ne sont plus nécessaires. Pour en savoir plus sur le fonctionnement des options, vous pouvez consulter .
Une autre option, qui mérite une attention particulière, est transforms. Bien qu'elle concerne plutôt la commodité et l'esthétique…
Par défaut, Debezium crée des topics en se basant sur la politique de nommage suivante : serverName.schemaName.tableName. Cela peut ne pas toujours être pratique. Les options transforms permettent de définir à l'aide d'expressions régulières la liste des tables dont les événements doivent être routés vers un topic portant un nom spécifique.
Dans notre configuration, grâce à Pour conclure la description de la configuration du connecteur PostgreSQL, il convient d'aborder les fonctionnalités/limitations suivantes de son fonctionnement : Ainsi, nous chargerons notre configuration dans le connecteur : Nous vérifions que le chargement s'est effectué avec succès et que le connecteur est lancé : Excellent : il est configuré et prêt à l'emploi. Jouons maintenant le consommateur et connectons-nous à Kafka, puis ajoutons et modifions une entrée dans la table : Dans notre topic, cela se manifestera comme suit : Un JSON très long avec nos modifications Dans les deux cas, les enregistrements se composent de la clé (PK) de l'enregistrement qui a été modifié, et directement de la nature des changements : quel était l'enregistrement avant et quel est le résultat après. Ce connecteur utilise le mécanisme standard de réplication de MongoDB, en lisant les informations du oplog du nœud principal de la base de données. De la même manière que le connecteur pour PgSQL décrit précédemment, ici aussi, lors du premier démarrage, un instantané primaire des données est effectué, après quoi le connecteur passe en mode de lecture du oplog. Exemple de configuration : Comme vous pouvez le constater, il n'y a pas de nouvelles options par rapport à l'exemple précédent, mais le nombre d'options liées à la connexion à la base de données et leurs préfixes a été réduit. Paramètres La question de la tolérance aux pannes et de la haute disponibilité est plus cruciale que jamais dans notre époque — surtout quand nous parlons de données et de transactions, et le suivi des changements de données ne doit pas rester à l'écart de cette question. Examinons ce qui pourrait mal se passer et ce qui arrivera à Debezium dans chacun des cas. Il existe trois scénarios de pannes : Cependant, il existe des exceptions. Si le connecteur a été désactivé pendant une longue période (ou n'a pas pu se connecter à l'instance MongoDB), et que l'oplog a été tourné pendant ce temps, alors, lors de la rétablissement de la connexion, le connecteur continuera impassiblement à lire les données depuis la première position disponible, ce qui signifie qu'une partie des données arrivera dans Kafka. ne . Debezium — c'est ma première expérience avec les systèmes CDC et dans l'ensemble, elle est très positive. Le projet est attirant grâce à la prise en charge des principales bases de données, la simplicité de configuration, le support de la mise en cluster et une communauté active. Pour ceux qui s'intéressent à la pratique, je recommande de consulter les guides pour et . Comparé au connecteur JDBC pour Kafka Connect, le principal avantage de Debezium est que les modifications sont lues à partir des journaux de la SGBD, ce qui permet d'obtenir des données avec un minimum de latence. Le connecteur JDBC (fourni par Kafka Connect) effectue des requêtes sur la table suivie à des intervalles fixes et (pour cette même raison) ne génère pas de messages lors de la suppression de données (comment peut-on demander des données qui n'existent pas ?). Pour des tâches similaires, vous pouvez considérer les solutions suivantes (en plus de Debezium) : Lisez aussi dans notre blog : Source : habr.comtransforms , il se passe ce qui suit : tous les événements CDC de la base de données suivie iront dans un topic nommé data.cdc.dbname. Sinon (sans ces paramètres), Debezium créerait par défaut un topic pour chaque table sous la forme : pg-dev.public..
Restrictions du connecteur
Application de la configuration
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: la valeur avant (before) est égale à null, et après, c'est la chaîne qui a été insérée. UPDATE: dans payload.before l'état précédent de la ligne est affiché, et dans payload.after — le nouvel état avec la nature des changements.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms cette fois-ci font ce qui suit : transforment le nom du sujet cible selon le schéma <server_name>.<db_name>.<collection_name> dans data.cdc.mongo_<db_name>.Résilience
Conclusion
P.S.

 Russian Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish