

est un outil simple et efficace pour la sauvegarde de PostgreSQL dans le cloud. En termes de fonctionnalités principales, il est l'héritier de l'outil populaire , mais réécrit en Go. Cependant, WAL-G a une nouvelle fonctionnalité importante : les copies delta. Les copies delta stockent les pages de fichiers qui ont changé par rapport à la version précédente de la sauvegarde. WAL-G utilise de nombreuses technologies pour le parallélisme des sauvegardes. WAL-G fonctionne beaucoup plus vite que WAL-E.
Vous pouvez lire les détails du fonctionnement de WAL-G dans l'article :
Le protocole de stockage S3 est devenu populaire pour le stockage de données. Un des avantages du S3 est la possibilité d'accès via API, permettant une interaction flexible avec le stockage, y compris un accès public en lecture, tandis que la mise à jour des informations dans le stockage ne peut être effectuée que par des utilisateurs authentifiés.
Il existe plusieurs implémentations, tant ouvertes que privées, de stockage fonctionnant selon le protocole S3. Aujourd'hui, nous allons examiner une solution populaire pour l'organisation de petits stockages : Minio.
Pour tester WAL-G, un serveur PostgreSQL suffira, et nous utiliserons Minio comme remplacement du S3.
Serveur Minio
Installation de Minio
yum -y install yum-plugin-copr
yum copr enable -y lkiesow/minio
yum install -y minio
Modifiez AccessKey et SecretKey dans /etc/minio/minio.conf
vi /etc/minio/minio.confSi vous n'utilisez pas nginx devant Minio, vous devez changer
--address 127.0.0.1:9000--address 0.0.0.0:9000Démarrez Minio
systemctl start minioAccédez à l'interface web de Minio et créez un bucket (par exemple, pg-backups).
Serveur de DB
Je compile WAL-G en rpm (Anton Patsev). , .
Pour ceux qui n'ont pas de système basé sur RPM, utilisez le guide officiel pour l'installation.
Avec le binaire de WAL-G en rpm, il y a des scripts qui importent des variables depuis le fichier /etc/wal-g.d/server-s3.conf.
backup-fetch.sh
backup-list.sh
backup-push.sh
wal-fetch.sh
wal-g-run.sh
wal-push.sh
Installez wal-g.
yum -y install yum-plugin-copr
yum copr enable -y antonpatsev/wal-g
yum install -y wal-g
Vérifiez la version de wal-g.
wal-g --version
wal-g version v0.2.14
Modifiez /etc/wal-g.d/server-s3.conf selon vos besoins.
Les fichiers de configuration et les fichiers de données utilisés par le cluster de base de données sont traditionnellement stockés ensemble dans le répertoire de données du cluster, généralement appelé PGDATA
#!/bin/bash

export PG_VER="9.6"

export WALE_S3_PREFIX="s3://pg-backups" # бакет, который мы создали в S3
export AWS_ACCESS_KEY_ID="xxxx" # AccessKey из /etc/minio/minio.conf
export AWS_ENDPOINT="http://ip-адрес-сервера-minio:9000"
export AWS_S3_FORCE_PATH_STYLE="true"
export AWS_SECRET_ACCESS_KEY="yyyy" # SecretKey из /etc/minio/minio.conf

export PGDATA=/var/lib/pgsql/$PG_VER/data/
export PGHOST=/var/run/postgresql/.s.PGSQL.5432 # Сокет для подключения к PostgreSQL

export WALG_UPLOAD_CONCURRENCY=2 # Кол-во потоков для закачки
export WALG_DOWNLOAD_CONCURRENCY=2 # Кол-во потоков для скачивания
export WALG_UPLOAD_DISK_CONCURRENCY=2 # Кол-во потоков на диске для закачки
export WALG_DELTA_MAX_STEPS=7
export WALG_COMPRESSION_METHOD=brotli # Какой метод сжатия использовать.
Lors de la configuration de WAL-G, vous spécifiez WALG_DELTA_MAX_STEPS — le nombre d'étapes maximal entre une sauvegarde delta et une sauvegarde de base, et vous définissez la politique de copie delta. Vous pouvez soit effectuer une copie à partir de la dernière delta existante, soit créer un delta à partir de la première sauvegarde complète. Cela est nécessaire dans le cas où une même partie de votre base de données change constamment, avec des données toujours en modification.
Installons la base de données.
yum install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-7-x86_64/pgdg-redhat-repo-latest.noarch.rpm
yum install -y postgresql96 postgresql96-server mc
Initialisons la base de données.
/usr/pgsql-9.6/bin/postgresql96-setup initdb
Initializing database ... OK
Si vous testez sur un seul serveur, vous devez reconfigurer le paramètre wal_level sur archive pour PostgreSQL version inférieure à 10, et en replica pour PostgreSQL version 10 et supérieure.
wal_level = archiveNous allons sauvegarder les archives WAL toutes les 60 secondes à l'aide de PostgreSQL lui-même. En production, vous aurez une autre valeur pour archive_timeout.
archive_mode = on
archive_command = '/usr/local/bin/wal-push.sh %p'
archive_timeout = 60 # La commande archive_command sera exécutée toutes les 60 secondes.
Démarrons PostgreSQL
systemctl start postgresql-9.6Dans une console séparée, vérifiez les journaux de PostgreSQL pour des erreurs : (remplacez postgresql-Wed.log par le journal actuel).
tail -fn100 /var/lib/pgsql/9.6/data/pg_log/postgresql-Wed.logAccédons à psql.
su - postgres
psql
Dans psql, créons la base de données.
Créons une table dans la base de données test1.
create database test1;Passons à la base de données test.
postgres=# c test1;Créons la table indexing_table.
test1=# CREATE TABLE indexing_table(created_at TIMESTAMP WITH TIME ZONE DEFAULT NOW());Ajout des données.
Lançons l'insertion des données. Attendez 10-20 minutes.
#!/bin/bash
# postgres
while true; do
psql -U postgres -d test1 -c "INSERT INTO indexing_table(created_at) VALUES (CURRENT_TIMESTAMP);"
sleep 60;
done
Faites absolument une sauvegarde complète.
su - postgres
/usr/local/bin/backup-push.sh
Consultons les enregistrements dans la table de la base test1.
select * from indexing_table;
2020-01-29 09:41:25.226198+
2020-01-29 09:42:25.336989+
2020-01-29 09:43:25.356069+
2020-01-29 09:44:25.37381+
2020-01-29 09:45:25.392944+
2020-01-29 09:46:25.412327+
2020-01-29 09:47:25.432564+
2020-01-29 09:48:25.451985+
2020-01-29 09:49:25.472653+
2020-01-29 09:50:25.491974+
2020-01-29 09:51:25.510178+
La ligne représente l'heure actuelle.
Consultons la liste des sauvegardes complètes.
/usr/local/bin/backup-list.shTest de restauration
Restauration complète en appliquant toutes les WAL disponibles.
Arrêtons PostgreSQL.
Supprimons tout dans le dossier /var/lib/pgsql/9.6/data.
Exécutons le script /usr/local/bin/backup-fetch.sh à partir de l'utilisateur postgres.
su - postgres
/usr/local/bin/backup-fetch.sh
Extraction de la sauvegarde terminée.
Ajoutez recovery.conf dans le dossier /var/lib/pgsql/9.6/data avec le contenu suivant.
restore_command = '/usr/local/bin/wal-fetch.sh "%f" "%p"'Démarrons PostgreSQL. PostgreSQL lancera le processus de restauration à partir des WAL archivé, et seulement après cela, la base sera ouverte.
systemctl start postgresql-9.6
tail -fn100 /var/lib/pgsql/9.6/data/pg_log/postgresql-Wed.log
Restauration à un moment défini.
Si nous voulons restaurer la base jusqu'à une minute précise, nous ajoutons le paramètre recovery_target_time dans recovery.conf pour indiquer à quel moment restaurer la base.
restore_command = '\/usr\/local\/bin\/wal-fetch.sh "%f" "%p"'
recovery_target_time = '2020-01-29 09:46:25'
Après la restauration, nous consultons la table indexing_table.
 2020-01-29 09:41:25.226198+00
 2020-01-29 09:42:25.336989+00
 2020-01-29 09:43:25.356069+00
 2020-01-29 09:44:25.37381+00
 2020-01-29 09:45:25.392944+00
Démarrons PostgreSQL. PostgreSQL lancera le processus de restauration à partir des WAL archivé, et seulement après cela, la base sera ouverte.
systemctl start postgresql-9.6
tail -fn100 /var/lib/pgsql/9.6/data/pg_log/postgresql-Wed.log
Test
Nous générons une base de données de 1 Go comme décrit ici.
Nous demandons la taille du bucket après la génération de 1 Go de données.
postgres=# SELECT pg_size_pretty(pg_database_size('test1'));
pg_size_pretty
----------------
1003 Mo
s4cmd est un outil en ligne de commande gratuit pour travailler avec des données stockées dans Amazon S3. L'utilitaire est écrit en python, ce qui lui permet d'être utilisé aussi bien sous Windows que sous Linux.
Installons s4cmd.
pip install s4cmdLZ4
s4cmd --endpoint-url=http:\/\/ip-adresse-du-serveur-minio:9000 --access-key=xxxx --secret-key=yyyy du -r s3:\/\/pg-backups
840540822       s3:\/\/pg-backups\/wal_005\/
840 Mo au format lz4 uniquement pour les logs WAL

Sauvegarde complète avec lz4 - 1 Go de données
time backup_push.sh
real 0m18.582s

Taille du bucket S3 après la sauvegarde complète

581480085       s3:\/\/pg-backups\/basebackups_005\/
842374424   s3:\/\/pg-backups\/wal_005
581 Mo pour la sauvegarde complète
LZMA
Après la génération de 1 Go de données
338413694       s3:\/\/pg-backups\/wal_005\/
338 Mo de logs au format lzma

Temps de génération de la sauvegarde complète
time backup_push.sh
real    5m25.054s

Taille du bucket dans S3
270310495       s3:\/\/pg-backups\/basebackups_005\/
433485092   s3:\/\/pg-backups\/wal_005\/

270 Mo pour la sauvegarde complète au format lzma
Brotli
Après la génération de 1 Go de données
459229886       s3:\/\/pg-backups\/wal_005\/
459 Mo de logs au format brotli

Temps de génération de la sauvegarde complète
real    0m23.408s

Taille du bucket dans S3
312960942       s3:\/\/pg-backups\/basebackups_005\/
459309262   s3:\/\/pg-backups\/wal_005\/

312 Mo pour la sauvegarde complète au format brotli
Comparaison des résultats sur le graphique.
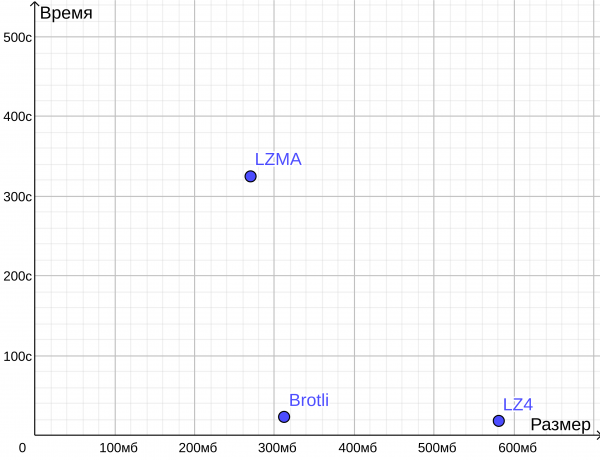
Comme nous le voyons, Brotli est comparable en taille à LZMA, mais la sauvegarde s'effectue en temps de LZ4.
Chat de la communauté PostgreSQL francophone :
Veuillez mettre une étoile sur Github si vous utilisez.
Source : habr.com
