

Bonjour, Habr.
Je m'appelle Misha Boutrimov, je voudrais parler un peu de Cassandra. Mon exposé sera utile à ceux qui n'ont jamais été confrontés aux bases de données NoSQL, car il y a beaucoup de particularités et de pièges à connaître. Et si vous n'avez vu que Oracle ou d'autres bases relationnelles, ces éléments vous sauveront la vie.
Qu'est-ce qui rend Cassandra si intéressante ? C'est une base de données NoSQL, conçue sans point de défaillance unique, qui se scale bien. Si vous devez ajouter quelques téraoctets pour une base quelconque, vous ajoutez simplement des nœuds au cluster. Vous souhaitez l'étendre à un autre datacenter ? Ajoutez des nœuds au cluster. Augmentez les RPS traités ? Ajoutez des nœuds au cluster. Cela fonctionne également dans l'autre sens.
En quoi est-elle encore performante ? Dans la gestion de nombreux requêtes. Mais beaucoup, c'est combien ? 10, 20, 30, 40 mille requêtes par seconde, c'est peu. 100 mille requêtes par seconde à l'écriture, c'est peu également. Certaines entreprises affirment qu'elles gèrent 2 millions de requêtes par seconde. À elles, il va falloir y croire.
Et en principe, Cassandra a une grande différence par rapport aux données relationnelles : elle n'y ressemble pas du tout. Et c'est très important de s'en souvenir.
Tout ce qui a l'air identique ne fonctionne pas de façon identique.
Un jour, un collègue est venu me voir et a demandé : « Voici le langage de requête CQL de Cassandra, et il y a une instruction select, il y a un where, il y a un and. J'écris des lettres, et ça ne fonctionne pas. Pourquoi ? ». Si vous considérez Cassandra comme une base de données relationnelle, c'est un moyen idéal de finir votre vie par un suicide brutal. Et je ne fais pas la promotion de cela, c'est interdit en Russie. Vous finirez simplement par concevoir quelque chose de mal.
Par exemple, un client vient et dit : « Construisons une base de données pour des séries, ou une base de données pour un répertoire de recettes. Nous aurons des plats avec des ingrédients ou une liste de séries et d'acteurs dedans ». Nous répondons avec enthousiasme : « Allons-y ! ». C'est deux octets à transférer, quelques tables et tout est prêt, ça fonctionnera très vite et de manière fiable. Tout va bien tant que les clients ne reviennent pas en disant que les ménagères ont aussi un problème inverse : elles ont une liste d'ingrédients et veulent savoir quel plat elles peuvent préparer. Vous êtes fichu.
Tout cela parce que Cassandra est une base de données hybride : elle fonctionne à la fois comme une base de données clé-valeur et stocke des données dans de larges colonnes. Si l'on parle en termes de Java ou de Kotlin, cela pourrait être décrit comme suit :
Map<RowKey, SortedMap>
C'est-à-dire une carte, à l'intérieur de laquelle se trouve également une carte triée. La première clé de cette carte est la Row key ou Partition key — la clé de partitionnement. La deuxième clé, qui est la clé de la carte déjà triée, est la Clustering key.
Pour illustrer la répartition de la base de données, dessinons trois nœuds. Nous devons maintenant comprendre comment répartir les données sur les nœuds. Parce que si nous mettons tout dans un seul (il peut y en avoir mille, deux mille, cinq — autant que vous voulez), cela ne parle pas vraiment de répartition. C'est pourquoi nous avons besoin d'une fonction mathématique qui renvoie un nombre. Juste un nombre, un int long, qui tombera dans une certaine plage. Et un nœud sera responsable d'une plage, un autre d'une autre, le n-ième d'une n-ième.
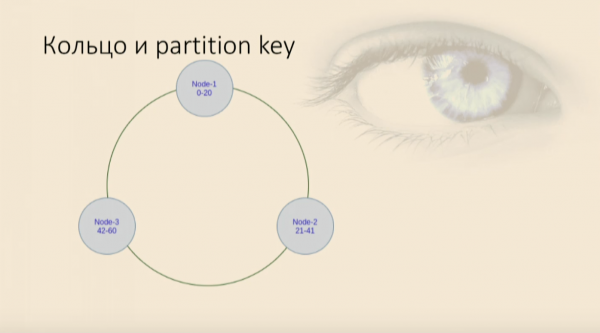
Ce nombre est obtenu grâce à une fonction de hachage, qui s'applique justement à ce que nous appelons la Partition key. C'est la colonne indiquée dans la directive Primary key, et c'est celle qui sera la première et la plus importante clé de la carte. Elle détermine quelles données iront sur quel nœud. Une table est créée dans Cassandra presque avec la même syntaxe que dans SQL :
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
La clé primaire dans ce cas se compose d'une seule colonne, et elle est aussi la clé de partitionnement.
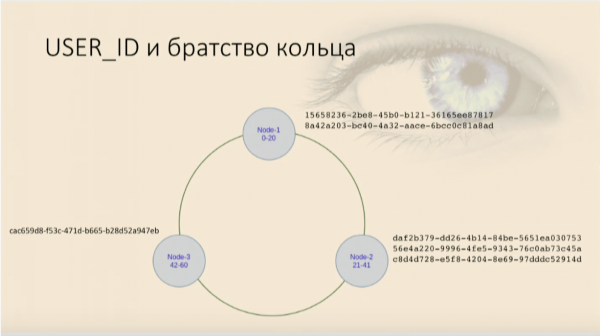
Comment nos utilisateurs seront-ils répartis ? Une partie ira sur un nœud, une autre partie sur un autre, et une autre encore sur le troisième. Cela devient une simple table de hachage, également appelée carte, qui en Python est un dictionnaire, c'est-à-dire une simple structure clé-valeur, à partir de laquelle nous pouvons lire toutes les valeurs, lire et écrire par clé.
Select : lorsque allow filtering se transforme en full scan, ou comment ne pas faire
Écrivons une instruction select : select * from users where userid = . Cela ressemble un peu à Oracle : nous écrivons un select, spécifions des conditions et tout fonctionne, les utilisateurs sont récupérés. Mais si nous choisissons, par exemple, un utilisateur avec une année de naissance spécifique, Cassandra se plaint qu'elle ne peut pas exécuter la requête. Parce qu'elle ne sait absolument rien sur la manière dont nos données sur l'année de naissance sont distribuées - elle a en tant que clé uniquement une seule colonne. Elle dit alors : « Très bien, je peux toujours exécuter cette requête. Ajoutez allow filtering ». Nous ajoutons la directive, tout fonctionne. Et à ce moment, cela devient terrible.
Lorsque nous exécutons des tests avec des données de test, tout va bien. Mais lorsque vous exécutez une requête en production, où nous avons, par exemple, 4 millions d'enregistrements, cela ne va pas très bien. Parce que allow filtering est une directive qui permet à Cassandra de collecter toutes les données de cette table sur tous les nœuds, tous de centres de données (s'il y en a beaucoup dans ce cluster), et ensuite seulement de les filtrer. C'est l'équivalent d'un Full Scan, et il est peu probable que quelqu'un soit ravi de cela.
Si nous avions besoin des utilisateurs uniquement par identifiants, cela nous conviendrait. Mais parfois, nous devons écrire d'autres requêtes et imposer d'autres restrictions sur la sélection. Donc, rappelons-nous : tout cela est une carte, qui a une clé de partitionnement, mais à l'intérieur se trouve une carte triée.
Et elle a aussi une clé, que nous appelons Clustering Key. Cette clé, qui est en fait composée des colonnes que nous choisirons, permet à Cassandra de comprendre comment ses données seront physiquement triées et stockées sur chaque nœud. Autrement dit, pour une clé de partition, la clé de regroupement indique comment exactement stocker les données dans cet arbre, quel espace elles occuperont.
C'est vraiment un arbre, un comparateur est simplement appelé, dans lequel nous transmettons un certain ensemble de colonnes sous forme d'objet, et il est également défini sous forme d'énumération de colonnes.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Attention à la directive Primary key, son premier argument (dans notre cas l'année) est toujours la clé de partition. Il peut être composé d'une ou plusieurs colonnes, peu importe. S'il y a plusieurs colonnes, il faut les mettre entre parenthèses encore une fois, afin que le préprocesseur du langage comprenne que c'est bien la clé primaire, suivie par toutes les autres colonnes — Clustering key. Celles-ci seront transmises au comparateur dans l'ordre dans lequel elles apparaissent. Donc, la première colonne est plus significative, la deuxième l'est moins, et ainsi de suite. Comme nous l'écrivons pour les data classes, par exemple, les champs equals : nous énumérons les champs et précisons lesquels sont plus importants que d'autres. En Cassandra, ce sont, pour ainsi dire, les champs de la data class auxquels l'equals écrit pour elle s'appliquera.
Définissons le tri, imposons des contraintes
Il faut se rappeler que l'ordre de tri (décroissant, croissant, peu importe) est défini au même moment que la création de la clé, et qu'il ne pourra pas être changé ensuite. Cela détermine physiquement comment les données seront triées et comment elles seront stockées. Si l'on souhaite modifier la Clustering key ou l'ordre de tri, il faudra créer une nouvelle table et y transférer les données. Cela n'est pas possible avec une table existante.
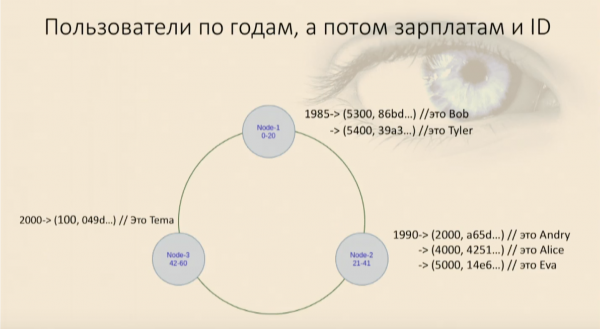
Nous avons rempli notre table avec des utilisateurs et avons constaté qu'ils se sont organisés en anneau d'abord par année de naissance, puis à l'intérieur sur chaque nœud par salaire et par ID utilisateur. Maintenant, nous pouvons faire des sélections en imposant des contraintes.
Notre fonctionnel réapparaît où, et, et les utilisateurs nous sont accessibles, tout est de nouveau en ordre. Mais si nous essayons d'utiliser seulement une partie de la Clustering key, et en plus une partie moins significative, Cassandra va immédiatement signaler qu'elle ne peut pas trouver dans notre carte l'endroit où cet objet avec ces champs pour le comparateur est null, et cet autre que nous venons de définir — où il se trouve. Je devrai à nouveau extraire toutes les données de ce nœud et les filtrer. C'est l'équivalent d'un Full Scan dans le cadre du nœud, ce qui est mauvais.
Dans toute situation confuse, créez une nouvelle table.
Si nous voulons pouvoir récupérer des utilisateurs par ID, par âge ou par salaire, que faire ? Rien. Il suffit d'utiliser deux tables. S'il faut récupérer des utilisateurs de trois manières différentes, il y aura trois tables. Le temps où nous économisions de l'espace sur le disque est révolu. C'est la ressource la moins chère. Elle coûte beaucoup moins cher que le temps de réponse, qui peut être préjudiciable pour l'utilisateur. Il est beaucoup plus agréable pour l'utilisateur de recevoir quelque chose en une seconde plutôt qu'en dix minutes.
Nous échangeons l'espace de stockage excessif, des données dénormalisées contre la possibilité de bien évoluer et de fonctionner de manière fiable. En effet, un cluster composé de trois centres de données, chacun avec cinq nœuds, avec un niveau acceptable de conservation des données (où rien ne sera perdu), est capable de survivre à la perte d'un centre de données entier. Et avec encore deux nœuds dans chacun des deux centres restants. Et ce n'est qu'après cela que les problèmes commenceront. C'est une bonne redondance, cela coûte quelques disques SSD et processeurs supplémentaires. Ainsi, pour utiliser Cassandra, qui n’est pas du tout SQL et qui n'a pas de relations ni de clés étrangères, il faut connaître des règles simples.
Nous concevons tout à partir de la requête. Ce ne sont pas les données qui sont les plus importantes, mais comment l'application va travailler avec elles. Si elle a besoin d'obtenir des données différentes de différentes manières ou les mêmes données de manières différentes, nous devons les organiser de manière à ce que cela convienne à l'application. Sinon, nous tomberons dans un Full Scan et Cassandra ne nous apportera aucun avantage.
Dénormaliser les données est la norme. Oublions les formes normales, nous n'avons plus de bases de données relationnelles. Mettons quelque chose 100 fois, il sera stocké 100 fois. C'est toujours moins coûteux que de ralentir.
Nous choisissons les clés pour le partitionnement de manière à ce qu'elles soient bien réparties. Nous n'avons pas besoin que le hachage de nos clés tombe dans une plage étroite. Par exemple, l'année de naissance dans l'exemple ci-dessus est un mauvais exemple. En effet, il est bon si nos utilisateurs sont répartis uniformément par année de naissance, mais mauvais s’il s'agit d'élèves de cinquième — cela ne se partitionnera pas très bien.
Le tri est sélectionné une seule fois lors de la création de la clé de clustering. Si cela doit être modifié, il faudra transférer notre table avec une autre clé.
Et le plus important : si nous devons récupérer les mêmes données de 100 manières différentes, cela signifie que nous aurons 100 tables différentes.
Source : habr.com
