

En 2010, l'entreprise disposait de 50 serveurs et d'un modèle réseau simple : backend, frontend et pare-feu. Le nombre de serveurs a augmenté, le modèle s'est complexifié : sténages, VLAN isolés avec ACL, puis VPN avec VRF, VLAN avec ACL en L2, VRF avec ACL en L3. Ça tourne la tête ? Ça va devenir plus intéressant.
Quand le nombre de serveurs a atteint 16 000, il est devenu impossible de travailler sereinement avec un tel nombre de segments hétérogènes. C'est pourquoi une autre solution a été trouvée. Un stack Netfilter a été utilisé, auquel Consul a été ajouté comme source de données, créant ainsi un pare-feu distribué rapide. Il a remplacé les ACL sur les routeurs et a été utilisé comme pare-feu externe et interne. Pour gérer dynamiquement l'outil, un système BEFW a été développé, appliqué partout : de la gestion de l'accès des utilisateurs au réseau de production à l'isolation des segments de réseau les uns des autres.
Comment tout cela fonctionne et pourquoi vous devriez vous intéresser à ce système, le Ivan Agarov () — responsable du groupe de sécurité des infrastructures au sein du département Maintenance au Centre de développement de Minsk de l'entreprise. Ivan est passionné par SELinux, aime Perl et écrit du code. En tant que responsable du groupe de sécurité, il travaille régulièrement avec des journaux, des sauvegardes et R&D pour protéger Wargaming contre les hackers et garantir le bon fonctionnement de tous les serveurs de jeu de l'entreprise.
Contexte historique
Avant de vous expliquer comment nous avons fait cela, laissez-moi vous raconter comment nous en sommes arrivés là et pourquoi cela était nécessaire. Pour cela, revenons neuf ans en arrière : 2010, lorsque World of Tanks venait de sortir. L'entreprise Wargaming avait environ 50 serveurs.
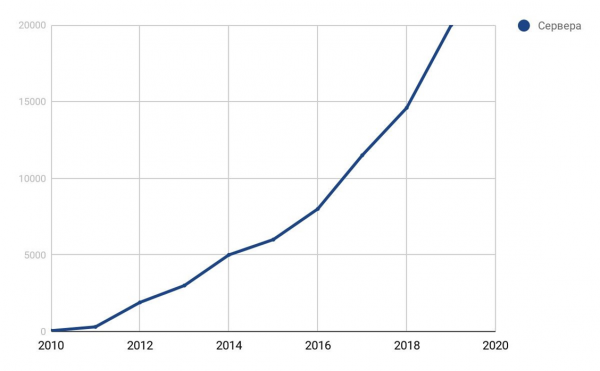
Graphique de la croissance des serveurs de l'entreprise.
Nous avions un modèle réseau. Pour l'époque, il était optimal.
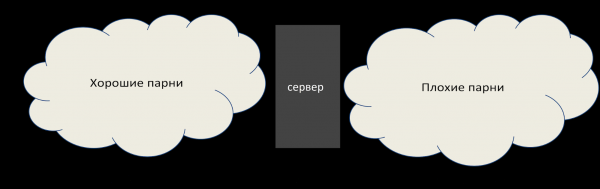
Le modèle réseau en 2010.
Sur le frontend, il y a des méchants qui veulent nous briser, mais il y a un pare-feu. Sur le backend, il n'y a pas de pare-feu, mais il y a 50 serveurs, nous les connaissons tous. Tout fonctionne bien.
En 4 ans, le parc de serveurs a été multiplié par 100, atteignant 5000. Les premiers réseaux isolés sont apparus : sténages, qui ne peuvent pas accéder à la production, et où il y avait souvent des éléments potentiellement dangereux.
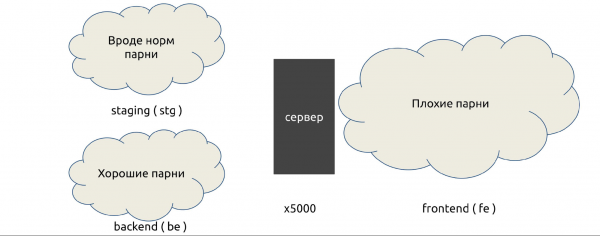
Le modèle réseau en 2014.
Par inertie, nous avons continué à utiliser les mêmes matériels, et tout le travail était effectué sur des VLAN isolés : des ACL étaient écrites pour ces VLAN, autorisant ou interdisant certaines connexions.
En 2016, le nombre de serveurs a atteint 8000. Wargaming a acquis d'autres studios, et des réseaux partenaires supplémentaires sont apparus. Ils semblent être les nôtres, mais ce n'est pas tout à fait le cas : pour les partenaires, le VLAN ne fonctionne souvent pas, il faut recourir au VPN avec VRF, et les isolations s'alourdissent. Un mélange d'isolations ACL a augmenté.
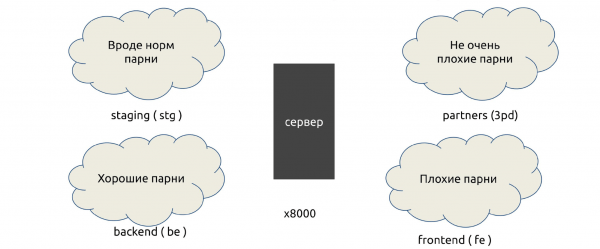
Le modèle réseau en 2016.
Début 2018, le parc de machines avait crû à 16 000. Il y avait 6 segments, et nous ne comptions pas les autres, y compris ceux fermés qui contenaient des données financières. Des réseaux de conteneurs (Kubernetes), DevOps, réseaux cloud connectés par VPN, par exemple depuis des IVC, sont apparus. Il y avait beaucoup de règles — c'était douloureux.
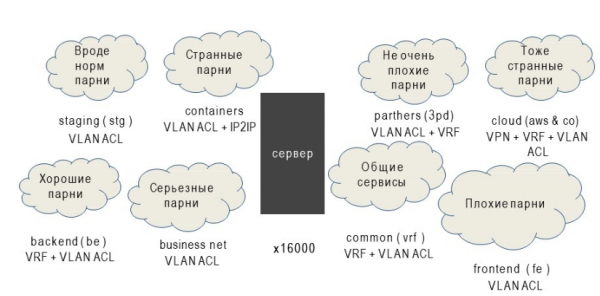
Modèle réseau et méthodes d'isolation en 2018.
Pour l'isolation, nous avons utilisé : VLAN avec ACL sur L2, VRF avec ACL sur L3, VPN et bien d'autres choses. Trop de choses.
Problèmes
Tout le monde vit avec des ACL et VLAN. Quel est le problème ? Harold, qui cache sa douleur, répondra à cette question.
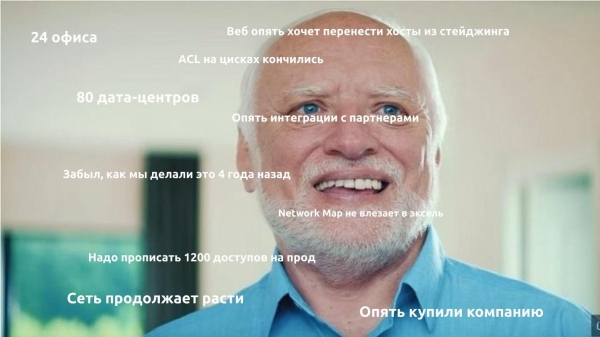
Il y avait beaucoup de problèmes, mais massifs — cinq.
- Croissance géométrique des prix pour de nouvelles règles.. Chaque nouvelle règle prenait plus de temps à ajouter que la précédente, car il fallait d'abord vérifier s'il n'y avait pas déjà une telle règle.
- Pas de pare-feu à l'intérieur des segments.. Les segments ont été quelque peu séparés les uns des autres, à l'intérieur, il n'y avait déjà pas assez de ressources.
- Les règles prenaient du temps à s'appliquer. À la main, un opérateur pouvait écrire une règle locale en une heure. Une règle globale prenait plusieurs jours.
- Difficultés avec l'audit des règles.. En fait, cela était impossible. Les premières règles ont été écrites en 2010, et la plupart de leurs auteurs ne travaillaient déjà plus dans l'entreprise.
- Niveau de contrôle faible sur l'infrastructure.. C'est le principal problème — nous ne savions pas vraiment ce qui se passait.
Voici à quoi ressemblait un ingénieur réseau en 2018, quand il entendait : « Il faut encore un peu d'ACL ».
Solutions
Début 2018, il a été décidé de faire quelque chose à ce sujet.
Le prix des intégrations augmente continuellement. Le point de départ était que les grands centres de données ont cessé de prendre en charge des VLAN et ACL isolés, car la mémoire des appareils était épuisée.
Solution : nous avons éliminé le facteur humain et avons automatisé au maximum l'octroi d'accès.
Les nouvelles règles mettent longtemps à être appliquées. Solution : accélérer l'application des règles, la rendre distribuée et parallèle. Pour cela, un système distribué est nécessaire, afin que les règles soient délivrées automatiquement, sans rsync ou SFTP sur mille systèmes.
Absence de pare-feu à l'intérieur des segments. Le pare-feu à l'intérieur des segments a commencé à nous affecter lorsque différents services sont apparus au sein d'un même réseau. Solution : utiliser un pare-feu au niveau de l'hôte — des pare-feux basés sur l'hôte. Nous avons pratiquement Linux partout, et iptables est toujours disponible, ce n'est pas un problème.
Difficultés avec l'audit des règles. Solution : conserver toutes les règles en un seul endroit pour révision et gestion, afin que nous puissions effectuer des audits.
Niveau de contrôle faible sur l'infrastructure. Solution : réaliser un inventaire de tous les services et des accès entre eux.
C'est un processus plus administratif que technique. Parfois, nous avons 200 à 300 nouvelles versions par semaine, surtout pendant les promotions et les fêtes. Et cela ne concerne qu'une seule équipe de nos DevOps. Avec un tel nombre de versions, il est impossible de comprendre quels ports, IP, et intégrations sont nécessaires. C'est pourquoi nous avons besoin de gestionnaires de services spécialement formés, qui questionnaient les équipes : « Qu'est-ce que vous avez et pourquoi l'avez-vous mis en place ? »
Après tout ce que nous avons lancé, l'ingénieur réseau en 2019 avait déjà cet aspect.
Consul
Nous avons décidé de mettre tout ce que nous avons trouvé grâce aux gestionnaires de services dans Consul et d'écrire les règles iptables à partir de là.
Comment avons-nous décidé de procéder ?
- Nous rassemblerons tous les services, réseaux et utilisateurs.
- Nous créerons des règles iptables sur cette base.
- Nous automatiserons le contrôle.
- ….
- PROFIT.
Consul n'est pas une API distante, il peut fonctionner sur chaque nœud et écrire dans iptables. Il ne reste plus qu'à trouver des moyens de contrôle automatiques qui nettoieront le superflu, et la plupart des problèmes seront résolus ! Le reste sera peaufiné en cours de route.
Pourquoi Consul ?
Il a fait ses preuves. Entre 2014 et 2015, nous l'avons utilisé comme backend pour Vault, où nous stockons les mots de passe.
Ne perd pas de données.. Pendant son utilisation, Consul n'a perdu aucune donnée lors d'une seule panne. C'est un énorme avantage pour le système de gestion du pare-feu.
Les connexions P2P accélèrent la propagation des changements.. Avec P2P, tous les changements arrivent rapidement, il n'est pas nécessaire d'attendre des heures.
API REST pratique. Nous avons également envisagé Apache ZooKeeper, mais il n'a pas d'API REST, il faudrait mettre en place des solutions de contournement.
Fonctionne à la fois comme un stockage de clés (KV) et comme un annuaire (Découverte de services).. On peut stocker des services, des catalogues, des centres de données. Cela est pratique non seulement pour nous, mais aussi pour les équipes voisines, car en construisant un service global, nous pensons à grande échelle.
Écrit en Go, qui fait partie de la stack Wargaming. Nous aimons ce langage, nous avons de nombreux développeurs Go.
Un système ACL puissant. Avec ACL dans Consul, vous pouvez gérer qui peut écrire quoi. Nous garantissons que les règles de pare-feu ne se chevaucheront plus et que nous n'aurons plus ce genre de problèmes.
Mais Consul a aussi des inconvénients.
- Il ne se scale pas au sein d'un data center, à moins d'avoir la version professionnelle. Il se scale uniquement par fédération.
- Il est très dépendant de la qualité du réseau et de la charge des serveurs. Consul ne fonctionnera pas correctement en tant que serveur sur un serveur surchargé si le réseau présente des lags, comme une vitesse irrégulière. Cela est lié aux connexions P2P et aux modèles de diffusion des mises à jour.
- Difficultés de surveillance de la disponibilité. Dans l'état de Consul, il peut dire que tout va bien, mais en fait, il est déjà tombé.
Nous avons résolu la plupart de ces problèmes lors de l'utilisation de Consul, c'est pourquoi nous l'avons choisi. L'entreprise envisage une alternative en backend, mais nous avons appris à faire face aux problèmes et vivons pour l'instant avec Consul.
Comment fonctionne Consul
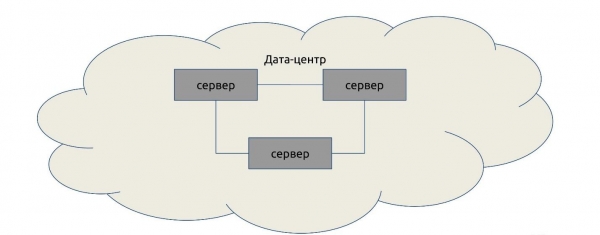
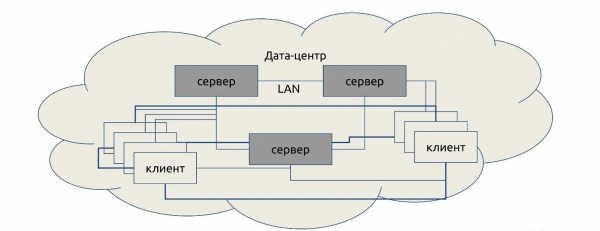
Dans un data center hypothétique, nous installerons des serveurs — entre trois et cinq. Un ou deux serveurs ne conviennent pas : ils ne pourront pas organiser un quorum et déterminer qui a raison, qui a tort lorsque les données ne correspondent pas. Plus de cinq n'a pas de sens, les performances en souffriront.
Les clients se connectent aux serveurs dans n'importe quel ordre : ce sont les mêmes agents, mais avec le drapeau server = false.
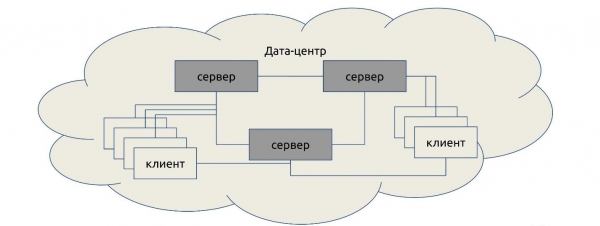
Après cela, les clients obtiennent une liste de connexions P2P et établissent des relations entre eux.
À l'échelle mondiale, nous relions plusieurs data centers. Ils se connectent également en P2P et communiquent.
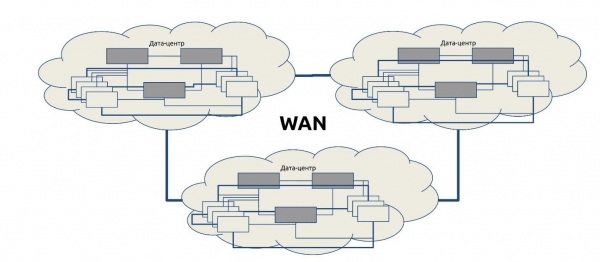
Lorsque nous voulons récupérer des données d'un autre data center, la demande va d'un serveur à un autre. Ce schéma est appelé protocole Serf. Le protocole Serf, tout comme Consul, est un développement de HashiCorp.
Quelques faits importants sur Consul
Consul a de la documentation décrivant son fonctionnement. Je vais donner seulement quelques faits clés qu'il vaut la peine de connaître.
Les serveurs Consul choisissent un maître parmi les votants.Consul choisit un maître parmi la liste des serveurs pour chaque data center, et toutes les demandes vont uniquement à lui, peu importe le nombre de serveurs. Le blocage du maître ne conduit pas à de nouvelles élections. Si aucun maître n'est choisi, les demandes ne sont traitées par personne.
Vous vouliez une montée en charge horizontale ? Désolé, non.
La requête vers un autre datacenter se fait d'un maître à un maître, indépendamment du serveur sur lequel elle est effectuée. Le maître sélectionné reçoit 100 % de la charge, à l'exception de la charge des requêtes transférées. Une copie à jour des données est présente sur tous les serveurs du datacenter, mais seule une répond.
Le seul moyen de se dimensionner est d'activer le mode stale côté client.
En mode stale, il est possible de répondre sans quorum. C'est un mode dans lequel nous renonçons à la cohérence des données, mais où les lectures sont légèrement plus rapides que d'habitude, et n'importe quel serveur peut répondre. Naturellement, l'écriture se fait uniquement via le maître.
Consul ne copie pas les données entre les datacenters. Lors de la collecte de fédérations, chaque serveur aura uniquement ses propres données. Pour d'autres, il se tournera toujours vers quelqu'un d'autre.
L'atatomicité des opérations n'est pas garantie en dehors de la transaction. Rappelez-vous que vous n'êtes pas le seul à pouvoir modifier quelque chose. Si vous voulez faire différemment, effectuez une transaction avec blocage.
Les opérations de blocage ne garantissent pas le verrouillage. La requête va d'un maître à un maître, et non directement, donc il n'y a aucune garantie que le verrouillage fonctionnera lorsque vous en faites un, par exemple dans un autre datacenter.
Les ACL ne garantissent également pas l'accès (dans de nombreux cas). L’ACL peut ne pas fonctionner, car elle est stockée dans un seul datacenter de la fédération — dans le datacenter ACL (DC principal). Si le DC ne vous répond pas, l’ACL ne fonctionnera pas.
Un maître bloqué entraînera le blocage de toute la fédération. Par exemple, dans une fédération de 10 datacenters, si l'un a un mauvais réseau et qu'un maître tombe, tous ceux qui communiquent avec lui se bloqueront en boucle : la requête est envoyée, aucune réponse, le thread se bloque. Il est impossible de savoir quand cela se produira, d'un coup dans une heure ou deux, toute la fédération tombera. Vous ne pourrez rien y faire.
L'état, le quorum et les élections sont traités par un fil séparé. Les réélections ne se produiront pas, l'état ne montrera rien. Vous pensez que votre Consul est vivant, vous demandez, et rien ne se passe — aucune réponse. Pendant ce temps, l'état indique que tout va bien.
Nous avons rencontré ce problème et avons dû reconstruire certaines parties des datacenters pour l'éviter.
Dans la version entreprise de Consul, certains des défauts mentionnés ci-dessus n'existent pasIl contient de nombreuses fonctionnalités utiles : choix des voteurs, distribution, mise à l'échelle. Il n'y a qu'un seul « mais » : le système de licence pour le système distribué est très coûteux.
Astuces : rm -rf /var/lib/consul — le remède à tous les problèmes de l'agent. Si quelque chose ne fonctionne pas, supprimez simplement vos données et rechargez-les à partir d'une copie. Il est probable que Consul redémarre.
BEFW
Parlons maintenant de ce que nous avons ajouté à Consul.
— c'est un acronyme pour BackEndFireSall. Il fallait bien nommer le produit lors de la création du dépôt pour y mettre les premiers commits de test. Ce nom est resté.
Modèles de règles
Les règles sont écrites dans la syntaxe iptables.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Tout notre trafic passe par la chaîne BEFW, sauf ESTABLISHED, RELATED et localhost. Le modèle peut être n'importe quel, c'est juste un exemple.
À quoi sert BEFW ?
Services
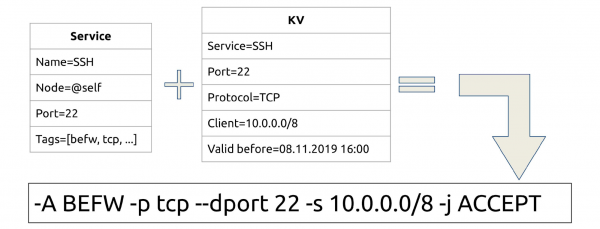
Nous avons un service, il y a toujours un port, un nœud sur lequel il fonctionne. Avec notre nœud, nous pouvons interroger localement l'agent et savoir qu'il y a un service. Nous pouvons également ajouter des étiquettes.
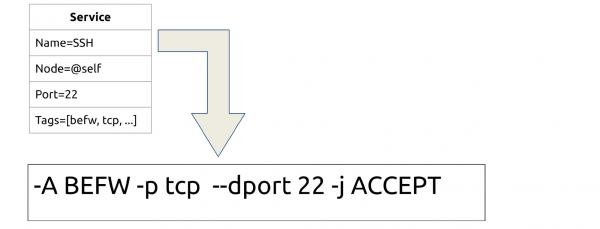
Tout service qui est lancé et enregistré dans Consul se convertit en règle iptables. Nous avons SSH — nous ouvrons le port 22. Le script Bash est simple : curl et iptables, rien de plus.
Clients
Comment ouvrir l'accès de manière sélective, et non à tout le monde ? En utilisant le nom du service pour stocker des listes d'IP dans le stockage KV.
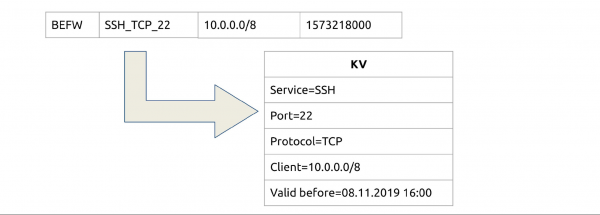
Par exemple, nous souhaitons que tous ceux du réseau dix puissent accéder au service SSH_TCP_22. Nous ajoutons un petit champ TTL ? et maintenant nous avons des autorisations temporaires, par exemple, pour une journée.
Accès
Nous connectons des services et des clients : nous avons un service, pour chacun, un stockage KV est prêt. Maintenant, nous donnons accès non pas à tout le monde, mais de manière sélective.
Groupes
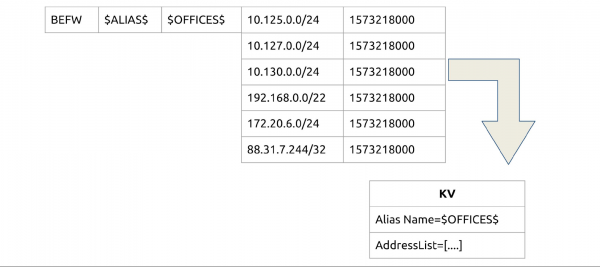
Si nous écrivons à chaque fois des milliers d'IP pour les accès, nous allons nous fatiguer. Inventons des regroupements — un sous-ensemble distinct dans la KV. Nous l'appellerons Alias (ou groupes) et y stockerons des groupes selon le même principe.
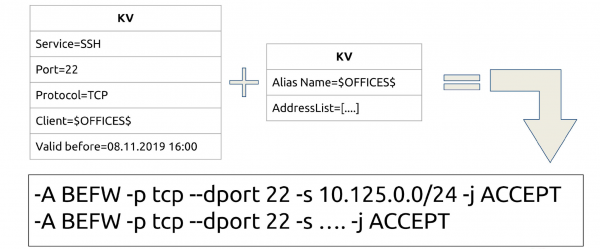
Connectons : maintenant nous pouvons ouvrir SSH non pas spécifiquement sur P2P, mais sur tout un groupe ou plusieurs groupes. De même, il y a un TTL — nous pouvons ajouter à un groupe et retirer temporairement.
Intégration
Notre problème — le facteur humain et l'automatisation. Pour l'instant, nous avons résolu cela ainsi.
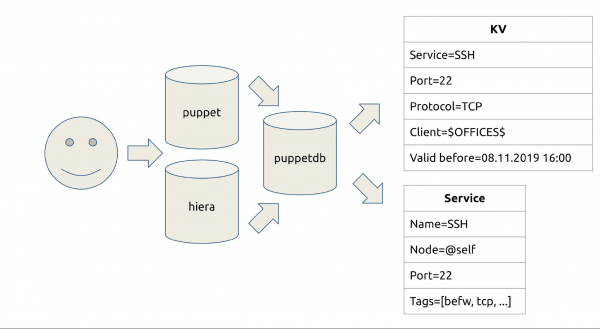
Nous travaillons avec Puppet et y transférons tout ce qui concerne le système (code des applications). Dans puppetdb (un PostgreSQL classique) est stockée la liste des services qui y sont lancés, que l'on peut trouver par type de ressource. Là, on peut aussi voir qui se connecte où. Nous avons également un système de pull request et de merge request pour cela.
Nous avons écrit befw-sync — une solution simple qui aide à transférer des données. D'abord, les cookies de synchronisation se connectent à puppetdb. L'API HTTP est configurée : nous demandons quels services nous avons, ce qu'il faut faire. Ensuite, une requête est faite à Consul.
Y a-t-il une intégration ? Oui : nous avons écrit des règles, autorisé l'acceptation des Pull Requests. Avez-vous besoin d'un port ou d'ajouter un hôte à un groupe ? Pull Request, revue — plus aucune « Trouvez 200 autres ACL et essayez d'en faire quelque chose ».
Optimisation
Un ping localhost avec une chaîne de règles vide prend 0,075 ms.
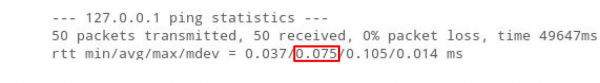
Ajoutons dans cette chaîne 10 000 adresses iptables. En conséquence, le ping augmentera de 5 fois : iptables est complètement linéaire, le traitement de chaque adresse prend un certain temps.
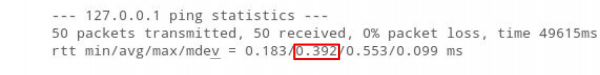
Pour le pare-feu vers lequel nous migrons des milliers d'ACL, nous avons beaucoup de règles, et cela entraîne des délais. C'est mauvais pour les protocoles de jeu.
Mais si nous plaçons 10 000 adresses dans ipset le ping même diminuera.
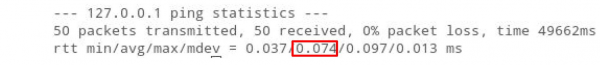
Le sens est que « O » (complexité de l'algorithme) pour ipset est toujours égal à 1, peu importe combien de règles il y a. En revanche, il y a une limitation — il ne peut pas y avoir plus de 65535 règles. Pour l'instant, nous vivons avec cela : nous pouvons les combiner, les étendre, faire deux ipset dans un.
Stockage
La suite logique du processus d'itérations est le stockage des informations clients pour le service dans ipset.
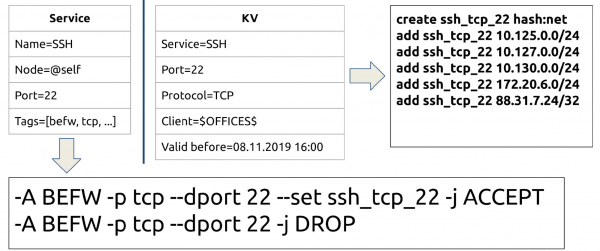
Nous avons maintenant le même SSH, et nous n'écrivons pas immédiatement 100 IP, nous spécifions un nom ipset avec lequel nous devons communiquer, et la prochaine règle DROP. On peut reformuler en une règle « Qui n'est pas ici, est DROP », mais c'est plus clair de cette manière.
Nous avons maintenant des règles et des ensembles. La tâche principale est de créer l'ensemble avant d'écrire la règle, sinon iptables ne l'enregistrera pas.
Schéma général
Sous forme de schéma, tout ce que j'ai expliqué ressemble à ça.
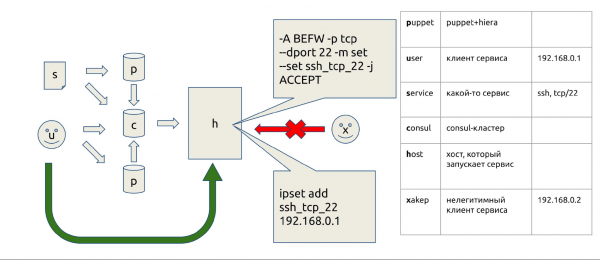
Nous commettons dans Puppet, tout est envoyé à l'hôte, les services ici, ipset là-bas, et ceux qui ne sont pas inscrits là-bas ne sont pas laissés passer.
Allow & deny
Pour sauver rapidement le monde ou déconnecter quelqu'un rapidement, au début de toutes les chaînes, nous avons créé deux ipset : rules_allow et rules_deny. Comment cela fonctionne-t-il ?
Par exemple, quelqu'un crée une charge sur notre Web avec des bots. Auparavant, il fallait trouver son IP dans les logs, l'apporter aux ingénieurs réseaux pour qu'ils trouvent la source du trafic et la bloquent. Maintenant, cela fonctionne différemment.
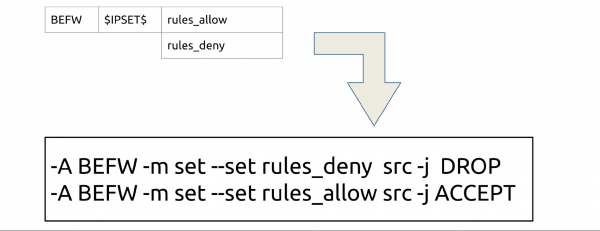
Nous envoyons dans Consul, attendons 2,5 secondes, et c'est prêt. Comme Consul distribue rapidement grâce au P2P, cela fonctionne partout, dans n'importe quelle partie du monde.
Une fois, j'ai complètement arrêté WOT en faisant une erreur avec le pare-feu. rules_allow — c'est notre assurance contre de tels cas. Si nous avons fait une erreur quelque part avec le pare-feu, si quelque chose est bloqué, nous pouvons toujours envoyer un conditionnel 0.0/0, pour tout relever rapidement. Ensuite, nous réparerons tout manuellement.
D'autres ensembles
On peut ajouter d'autres ensembles dans l'espace $IPSETS$.
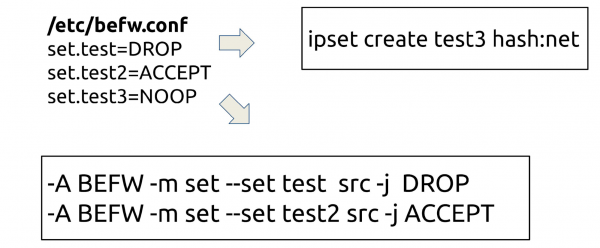
Pourquoi ? Parfois, certaines personnes ont besoin d'ipset, par exemple, pour émuler la désactivation d'une partie du cluster. Chacun peut apporter n'importe quel ensemble, le nommer et ils seront récupérés depuis Consul. Ces ensembles peuvent participer aux règles iptables, mais peuvent aussi agir comme une sorte de commande NOOP: la cohérence sera maintenue par un démon.
Utilisateurs
Avant, c'était comme ça : l'utilisateur se connectait au réseau et recevait des paramètres via un domaine. Avant l'apparition des pare-feu de nouvelle génération, Cisco ne pouvait pas comprendre où était l'utilisateur, et où se trouvait l'IP. Par conséquent, l'accès était accordé uniquement via le hostname de la machine.
Que avons-nous fait ? Nous nous sommes intercalés au moment de la réception de l'adresse. Généralement, c'est un dot1x, Wi-Fi ou VPN — tout passe par RADIUS. Pour chaque utilisateur, nous créons un groupe basé sur le nom de l'utilisateur et y plaçons l'IP avec un TTL égal à son dhcp.lease — dès qu'il expire, la règle disparaît.
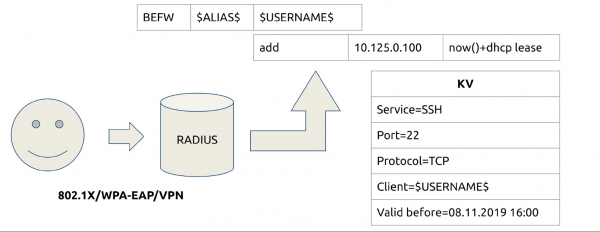
Maintenant, nous pouvons ouvrir l'accès aux services, comme pour d'autres groupes, par username. Nous avons éliminé la douleur liée au hostname, lorsqu'ils changent, et avons réduit la charge sur les ingénieurs réseaux, car ils n'ont plus besoin de Cisco. Maintenant, les ingénieurs gèrent eux-mêmes les accès sur leurs serveurs.
Isolation
En parallèle, nous avons commencé à travailler sur l'isolation. Les gestionnaires de service ont fait un inventaire, et nous avons analysé tous nos réseaux. Nous les distribuerons en groupes similaires, et sur les serveurs nécessaires, nous avons ajouté ces groupes, par exemple, dans deny. Maintenant, la même isolation de staging passe dans rules_deny pour la production, mais pas dans la production elle-même.
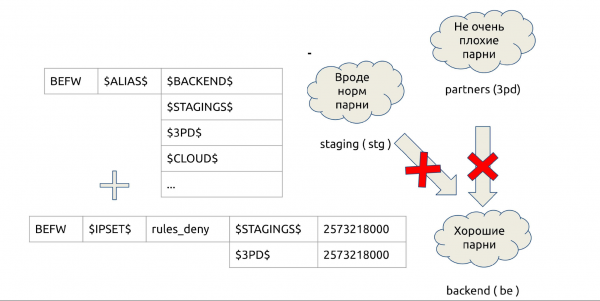
Le schéma fonctionne rapidement et simplement : nous retirons tous les ACL des serveurs, déchargeons les équipements, et réduisons le nombre de VLAN isolés.
Contrôle de l'intégrité
Auparavant, nous avions un déclencheur spécial qui signalait quand quelqu'un modifiait manuellement une règle de pare-feu. J'écrivais un énorme linter pour vérifier les règles de pare-feu, c'était compliqué. Maintenant, l'intégrité est contrôlée par BEFW. Il veille jalousement à ce que les règles, qu'il établit, ne soient pas modifiées. Si quelqu'un change les règles de pare-feu, il les remettra à leur état d'origine. « J'ai vite monté un proxy pour travailler depuis chez moi » — ce genre de situation n'existe plus.
BEFW contrôle l'ipset à partir des services et de la liste dans befw.conf, les règles des services dans la chaîne BEFW. Mais il ne surveille pas d'autres chaînes et règles et d'autres ipset.
Protection en cas d'accident
BEFW sauvegarde toujours le dernier état réussi directement dans la structure binaire state.bin. Si quelque chose ne va pas, il revient toujours à cet état state.bin.
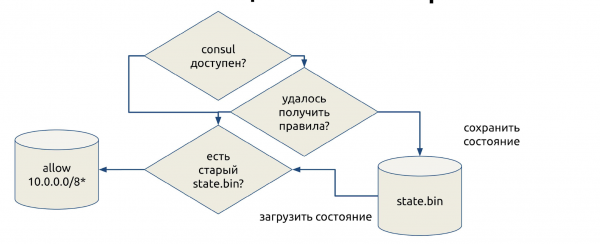
C'est une assurance contre le fonctionnement instable de Consul, lorsque des données n'ont pas été envoyées ou si quelqu'un a fait une erreur en utilisant des règles qui ne peuvent pas être appliquées. Pour que nous ne restions pas sans pare-feu, BEFW reviendra au dernier état, si une erreur se produit à un moment donné.
Dans des situations critiques, c'est une garantie que nous aurons un pare-feu fonctionnel. Nous ouvrons tous les réseaux en gris en espérant qu'un administrateur viendra et réparera. Un jour, je le mettrai dans les configurations, mais pour l'instant, nous avons juste trois réseaux en gris : 10/8, 172/12 et 192.168/16. Dans le cadre de notre Consul, c'est une caractéristique importante qui aide à avancer.
Démonstration : pendant la présentation, Ivan montre le mode démo de BEFW. Il est plus pratique de regarder la démonstration sur . Le code source de la démo est disponible .
Les pièges
Je vais parler des bugs auxquels nous avons été confrontés.
ipset add set 0.0.0.0/0. Que se passe-t-il si nous ajoutons dans ipset 0.0.0.0/0 ? Tous les IP vont-ils s'ajouter ? L'accès à Internet sera-t-il ouvert ?
Non, nous obtiendrons un bug qui nous a coûté deux heures d'arrêt. De plus, le bug ne fonctionne pas depuis 2016, il est enregistré dans RedHat Bugzilla sous le numéro #1297092, et nous l'avons trouvé par hasard dans le rapport d'un développeur.
Maintenant, il y a une règle stricte dans BEFW, que 0.0.0.0/0 se transforme en deux adresses : 0.0.0.0/1 et 128.0.0.0/1.
ipset restore set < file. Que fait ipset lorsque vous lui dites restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Rien de tel — il effectue un merge, et les anciennes adresses ne disparaissent nulle part, vous ne fermez pas l'accès.
Nous avons trouvé le bug en testant l'isolement. Maintenant, il y a un système assez complexe — au lieu de restore se déroule create temp, puis restore flush temp et restore temp. À la fin, swap : pour l'atomicité, car si vous réalisez d'abord flush Et à ce moment-là, si un paquet arrive, il sera rejeté et quelque chose se passera mal. Donc, il y a un peu de magie noire là-dedans.
consul kv get -datacenter=other. Comme je l'ai déjà dit, nous pensons demander certaines données, mais nous obtiendrons soit des données, soit une erreur. Nous pouvons le faire via Consul localement, mais dans ce cas, les deux vont se bloquer.
Le client Consul local est une couche au-dessus de l'API HTTP. Mais il gèle simplement et ne répond ni à Ctrl+C, ni à Ctrl+Z, ni à rien, seulement à kill -9 dans la console voisine. Nous nous sommes heurtés à ce problème lorsque nous construisions un grand cluster. Mais nous n'avons pas encore de solution, nous nous préparons à corriger cette erreur dans Consul.
Le leader de Consul ne répond pas. Notre master dans le datacenter ne répond pas, nous pensons : « Peut-être que l'algorithme de réélection va fonctionner ? »
Non, ça ne va pas fonctionner, et la surveillance ne montrera rien : Consul dira qu'il y a un index d'engagement, un leader trouvé, tout va bien.
Comment luttons-nous contre cela ? service consul restart dans cron toutes les heures. Si vous avez 50 serveurs, ce n'est pas grave. Quand il y en aura 16 000, vous comprendrez comment cela fonctionne.
Conclusion
En fin de compte, nous avons obtenu les avantages suivants :
- 100% de couverture de toutes les machines Linux.
- Vitesse.
- Automatisation.
- Nous avons libéré le matériel et les ingénieurs réseaux de l'esclavage.
- Des possibilités d'intégration presque illimitées : que ce soit avec Kubernetes, Ansible ou Python.
Inconvénients: Consul, avec lequel nous devons maintenant vivre, et un coût d'erreur très élevé. Par exemple, une fois, à 18h (heure de pointe en Russie), je modifiais quelque chose dans les listes de réseaux. Nous étions en train de construire l'isolation sur BEFW. J'ai fait une erreur quelque part, je pense que j'ai indiqué le mauvais masque, et tout est tombé en deux secondes. La surveillance s'allume, le support arrive en courant : « Tout est tombé ! » Le chef de département a grisonné en expliquant à l'entreprise pourquoi cela s'est produit.
Le coût d'erreur est si élevé que nous avons inventé notre propre procédure préventive complexe. Si vous allez implémenter cela sur un grand environnement de production, ne donnez pas de token master à Consul à tout le monde. Cela se terminera mal.
Coût. J'ai écrit 400 heures de code tout seul. Mon équipe de 4 personnes consacre 10 heures par mois pour le support de tous. Comparé au coût de n'importe quel pare-feu de nouvelle génération, c'est gratuit.
Plans. Le plan à long terme est de chercher un moyen de transport alternatif à Consul, ou en complément. Cela pourrait être Kafka ou quelque chose de similaire. Mais dans les prochaines années, nous vivrons avec Consul.
Plans à venir : intégration avec Fail2ban, surveillance, nftables, et peut-être d'autres distributions, métriques, surveillance avancée, optimisation. Le support de Kubernetes est également prévu, car nous avons actuellement plusieurs clusters et un désir.
Autres projets prévus :
- recherche d'anomalies dans le trafic ;
- gestion de la carte réseau ;
- support de Kubernetes ;
- compilation de paquets pour tous les systèmes ;
- Web-UI.
Nous travaillons constamment à l'élargissement de la configuration, à l'augmentation des métriques et à l'optimisation.
Rejoignez le projet. Le projet est génial, mais malheureusement, c'est pour l'instant un projet d'une seule personne. Venez sur et essayez de faire quelque chose : commettre, tester, proposer, donner votre avis.
En attendant, nous nous préparons pour , qui aura lieu les 6 et 7 avril à Saint-Pétersbourg, et nous invitons les développeurs de systèmes exigeants . Les conférenciers expérimentés savent déjà quoi faire, et nous conseillons aux débutants en présentation de faire au moins . Participer à la conférence en tant que conférencier présente plusieurs avantages. Vous pouvez lire sur lesquels à la fin de .
Source : habr.com
