

Salut, Habr !
Après les vacances de Nouvel An, nous avons relancé le cloud résilient en catastrophe basé sur deux sites. Aujourd'hui, nous vous expliquerons comment cela fonctionne et montrerons ce qui arrive aux machines virtuelles des clients lors de la défaillance de certains éléments du cluster et de la chute d'un site entier (spoiler – tout va bien pour elles).
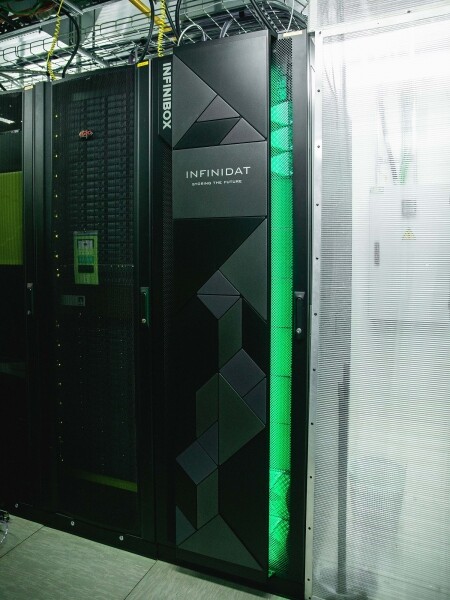
Systèmes de stockage du cloud résilient en catastrophe sur le site OST.
Qu'y a-t-il à l'intérieur
Sous le capot du cluster se trouvent des serveurs Cisco UCS avec l'hyperviseur VMware ESXi, deux systèmes de stockage INFINIDAT InfiniBox F2240, du matériel réseau Cisco Nexus, ainsi que des commutateurs SAN Brocade. Le cluster est réparti sur deux sites – OST et NORD, c'est-à-dire que chaque centre de données possède une configuration identique. C'est justement ce qui le rend résilient en cas de catastrophe.
Au sein d'un même site, les éléments principaux sont également redondés (hôtes, commutateurs SAN, réseau).
Les deux sites sont reliés par des liaisons en fibre optique dédiées, elles aussi redondantes.
Quelques mots sur les systèmes de stockage. Pour notre première version du cloud résilient, nous avons construit sur NetApp. Ici, nous avons choisi INFINIDAT, et voici pourquoi :
- L'option de réplication Active-Active. Elle permet à une machine virtuelle de rester opérationnelle même en cas de défaillance totale d'un des systèmes de stockage. Je détaillerai la réplication un peu plus loin.
- Trois contrôleurs de disque pour améliorer la résilience du système. En général, il y en a deux.
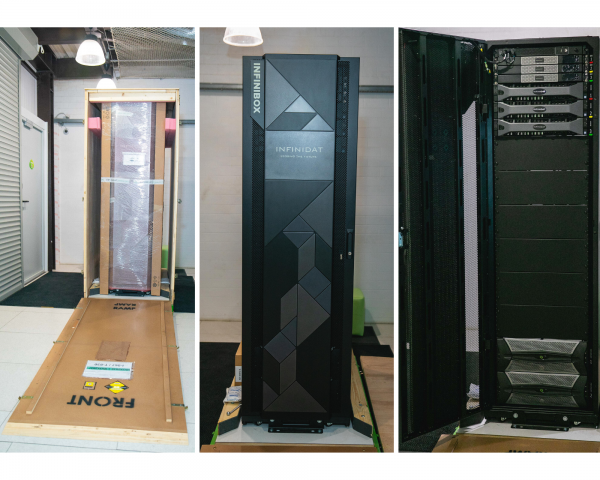
- Solution prête à l'emploi. Une armoire déjà montée est arrivée chez nous, il suffit de la connecter au réseau et de la configurer.
- Support technique attentif. Les ingénieurs d'INFINIDAT analysent en permanence les journaux et les événements des systèmes de stockage, installent de nouvelles versions du firmware et aident à la configuration.
Voici quelques photos du déballage :
Comment ça fonctionne
Le cloud est déjà résilient en interne. Il protège le client contre les défaillances matérielles et logicielles isolées. En revanche, la résilience en cas de catastrophe aide à se protéger contre des pannes massives au sein d'un même site : par exemple, une défaillance des systèmes de stockage (ou d'un cluster SDS, ce qui arrive assez souvent 🙂), des erreurs massives dans le réseau de stockage, etc. Et le plus important : un tel cloud aide lorsque tout un site devient inaccessible en raison d'un incendie, d'une coupure de courant, d'une prise d'otage par des extraterrestres.
Dans tous ces cas, les machines virtuelles des clients continuent de fonctionner, et voici pourquoi.
La configuration du cluster est telle que tout hôte ESXi avec des machines virtuelles clientes peut accéder à l'un des deux systèmes de stockage. Si le stockage sur le site OST tombe en panne, les machines virtuelles continueront à fonctionner : les hôtes sur lesquels elles s'exécutent accèderont aux données du système de stockage sur NORD.
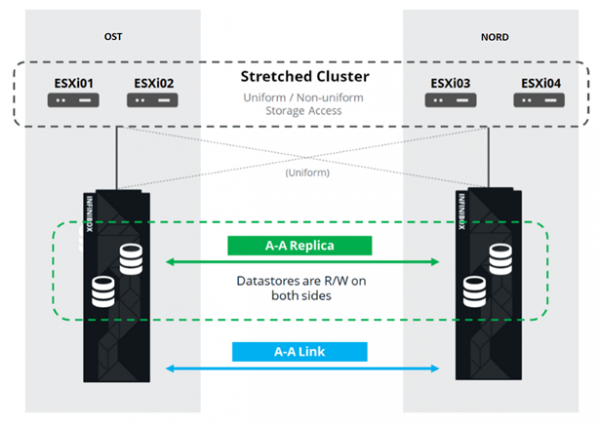
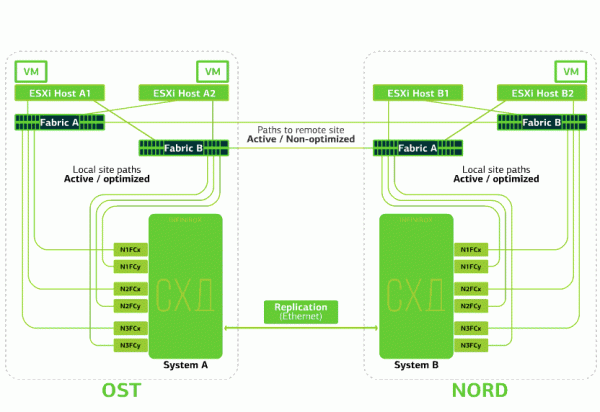
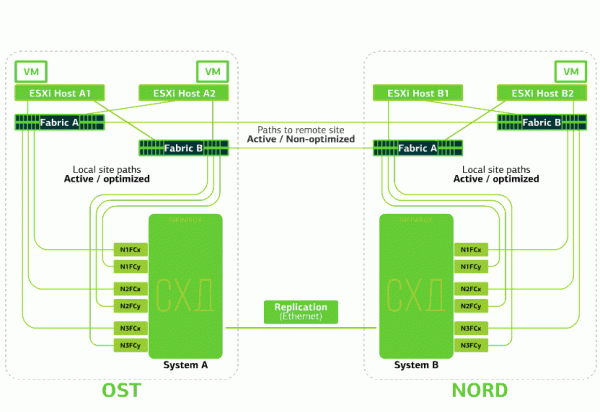
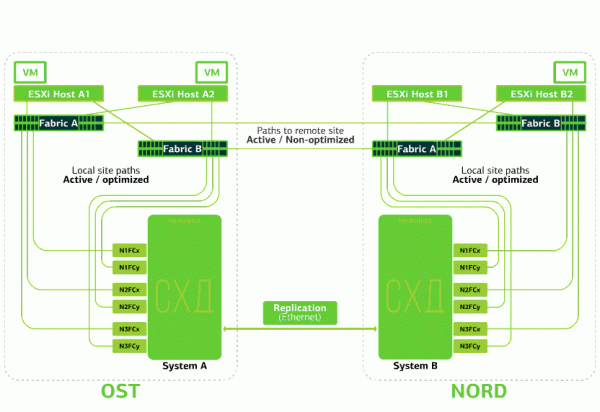
Voici à quoi ressemble le schéma de connexion dans le cluster.
Cela est possible grâce à la configuration d'un lien inter-switch (Inter-Switch Link) entre les fabric SAN des deux sites : le commutateur SAN Fabric A OST est connecté au commutateur SAN Fabric A NORD, de même pour les commutateurs SAN Fabric B.
Et pour que toutes ces interconnexions des fabric SAN aient un sens, une réplication Active-Active est configurée entre les deux systèmes de stockage : les informations sont pratiquement enregistrées simultanément sur le système de stockage local et distant, avec un RPO de 0. Il s'ensuit qu'un système de stockage contient l'original des données, tandis que l'autre en conserve une réplique. Les données sont répliquées au niveau des volumes du système de stockage, et c'est sur eux que sont stockées les données des VM (ses disques, fichier de configuration, fichier d'échange, etc.).
L'hôte ESXi voit le volume principal et sa réplique comme un seul dispositif de stockage (Storage Device). Pour chaque dispositif de stockage, il y a 24 chemins :
12 chemins le relient au système de stockage local (chemins optimaux), et les 12 autres au système de stockage distant (chemins non optimaux). Dans une situation normale, l'ESXi accède aux données sur le système de stockage local en utilisant les "chemins optimaux". En cas de panne de ce système de stockage, l'ESXi perd ses chemins optimaux et bascule vers les "chemins non optimaux". Voici à quoi cela ressemble dans le schéma.
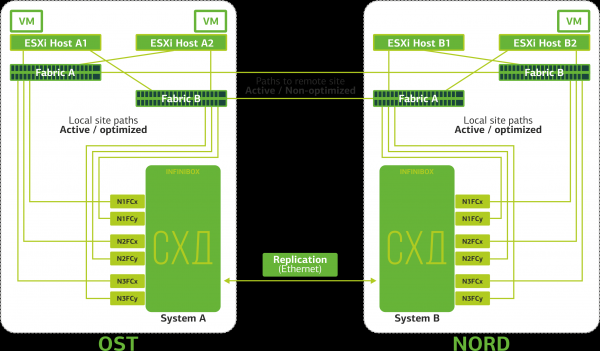
Schéma d'un cluster en cas de catastrophe.
Tous les réseaux clients sont connectés aux deux sites via une fabric réseau commune. Sur chaque site, un Provider Edge (PE) opère, où les réseaux clients sont terminés. Les PE sont regroupés dans un cluster commun. Si un PE sur un site tombe en panne, tout le trafic est redirigé vers le second site. Grâce à cela, les machines virtuelles du site sans PE restent accessibles au réseau pour le client.
Voyons maintenant ce qui se passe avec les machines virtuelles des clients en cas de diverses pannes. Commençons par les scénarios les plus simples et terminons par le plus grave : la panne de l'ensemble du site. Dans les exemples, le site principal sera OST, tandis que le site de secours, avec les répliques de données, sera NORD.
Que se passe-t-il avec la machine virtuelle d'un client si…
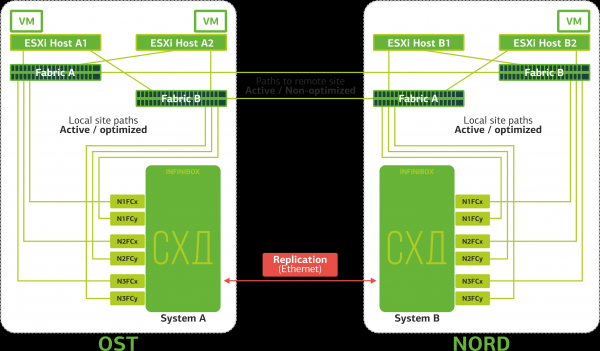
le lien de réplication (Replication Link) tombe en panne. La réplication entre les systèmes de stockage des deux sites s'arrête.
ESXi fonctionnera uniquement avec des dispositifs de stockage locaux (par des chemins optimaux).
Les machines virtuelles continuent de fonctionner.
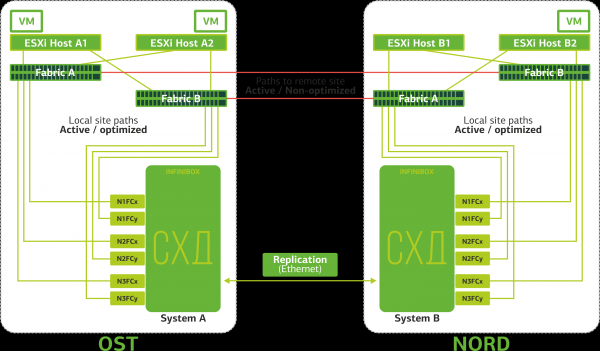
Une interruption de la liaison interswitch (ISL) se produit. C'est un événement peu probable. À moins qu'un excavateur fou ne creuse plusieurs chemins optiques à la fois, qui suivent des itinéraires indépendants et sont connectés aux sites par des entrées différentes. Mais même dans ce cas, les hôtes ESXi perdent la moitié de leurs chemins et ne peuvent accéder qu'à leurs unités de stockage locales. Les répliques sont collectées, mais les hôtes ne pourront pas y accéder.
Les machines virtuelles fonctionnent normalement.
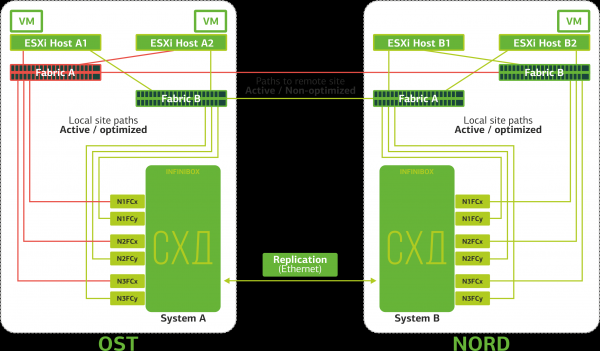
Un commutateur SAN échoue sur un des sites. Les hôtes ESXi perdent une partie des chemins vers les unités de stockage. Dans ce cas, les hôtes sur le site où le commutateur a échoué fonctionneront uniquement via leur propre HBA.
Les machines virtuelles continuent de fonctionner normalement.
Tous les commutateurs SAN échouent sur un des sites. Supposons qu'une telle panne se produise sur le site OST. Dans ce cas, les hôtes ESXi sur ce site perdront tous leurs chemins vers leurs dispositifs de stockage. Le mécanisme standard de VMware vSphere HA entre en jeu : il redémarrera toutes les machines virtuelles du site OST dans le site NORD au maximum dans 140 secondes.
Les machines virtuelles fonctionnant sur les hôtes du site NORD fonctionnent normalement.
Un hôte ESXi échoue sur un site. Le mécanisme vSphere HA entre à nouveau en action : les machines virtuelles du hôte en panne redémarrent sur d'autres hôtes – sur le même site ou sur un site distant. Le temps de redémarrage d'une machine virtuelle est d'1 minute.
Si tous les hôtes ESXi du site OST échouent, il n'y a plus d'options : les VM redémarrent sur un autre. Le temps de redémarrage est le même.
Un stockage de données échoue sur un site. Supposons qu'un stockage de données échoue sur le site OST. Dans ce cas, les hôtes ESXi du site OST basculent vers les répliques de stockage de données dans le site NORD. Une fois que le stockage de données défaillant est rétabli, une réplication forcée se produira, et les hôtes ESXi OST recommenceront à accéder au stockage de données local.
Les machines virtuelles fonctionnent normalement pendant tout ce temps.
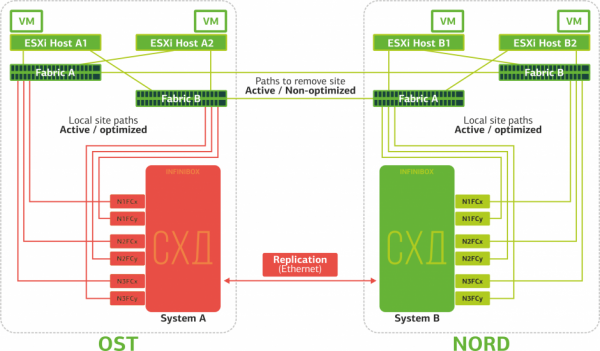
Un des sites échoue. Dans ce cas, toutes les machines virtuelles seront redémarrées sur le site de sauvegarde via le mécanisme vSphere HA. Le temps de redémarrage des VM est de 140 secondes. Pendant ce temps, tous les paramètres réseau de la machine virtuelle seront conservés, et elle restera accessible au client via le réseau.
Pour que le redémarrage des machines sur le site de secours se déroule sans problème, chaque site est rempli à moitié. L'autre moitié est une réserve au cas où toutes les machines virtuelles devraient être déplacées depuis le second site, celui qui a subi des dommages.
C'est ce que protège le cloud résilient basé sur deux centres de données.
C'est un plaisir coûteux, car en plus des ressources principales, une réserve sur le second site est nécessaire. C'est pourquoi on place des services critiques pour l'entreprise dans un tel cloud, dont l'arrêt prolongé entraîne d'importantes pertes financières et de réputation, ou si le système d'information est soumis à des exigences de résilience en cas de sinistre par des régulateurs ou des règlements internes de l'entreprise.
Sources :
Source : habr.com
