

Data Science pour débutants
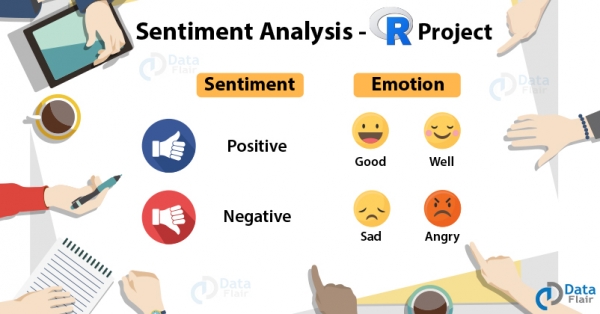
1. Analyse des sentiments (Analyse des sentiments à travers le texte)
Découvrez l'implémentation complète d'un projet Data Science avec le code source — .
L'analyse des sentiments consiste à examiner des mots pour déterminer les sentiments et opinions, qui peuvent être positifs ou négatifs. C'est un type de classification où les classes peuvent être binaires (positives et négatives) ou multiples (heureux, en colère, triste, désagréable, …). Nous allons réaliser ce projet Data Science en R et utiliser un jeu de données dans le package « janeaustenR ». Nous utiliserons des lexiques généraux tels qu'AFINN, bing et loughran, effectuerons un joint interne, et à la fin, nous créerons un nuage de mots pour visualiser le résultat.
Langue : R
Jeu de données / Package : janeaustenR
Cet article a été traduit avec le soutien de la société EDISON Software, qui , ainsi que .
2. Détection de Fake News (Détection de fausses nouvelles)
Améliorez vos compétences en travaillant sur un projet Data Science pour débutants — .
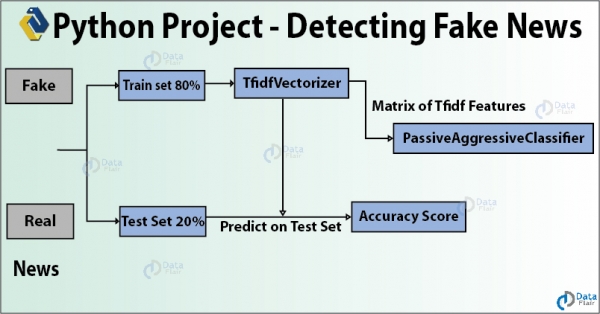
Les fausses nouvelles sont des informations erronées diffusées via les réseaux sociaux et d'autres médias en ligne dans un but politique. Dans cette idée de projet Data Science, nous allons utiliser Python pour construire un modèle capable de déterminer avec précision si une nouvelle est réelle ou fausse. Nous créerons un TfidfVectorizer et utiliserons un PassiveAggressiveClassifier pour classifier les nouvelles en 'réelles' et 'fausses'. Nous utiliserons un jeu de données de forme 7796 × 4 et effectuerons tout cela dans Jupyter Lab.
Langue : Python
Jeu de données / Package : news.csv
3. Détection de la maladie de Parkinson (Détection de la maladie de Parkinson)
Avancez en travaillant sur l'idée du projet Data Science — .
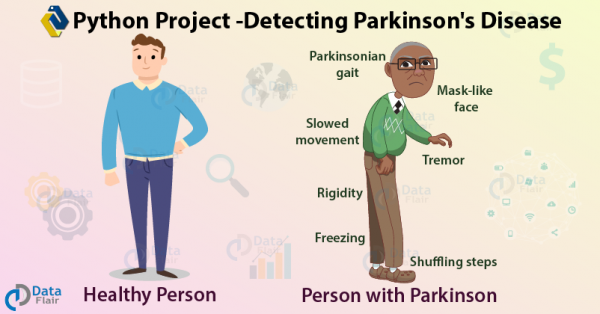
Nous commençons à utiliser le Data Science pour améliorer les soins de santé et les services — si nous pouvons prédire la maladie à un stade précoce, nous aurons de nombreux avantages. Ainsi, dans cette idée de projet Data Science, nous apprendrons à détecter la maladie de Parkinson avec Python. Il s'agit d'une maladie neurodégénérative progressive du système nerveux central qui impacte le mouvement et provoque des tremblements et de la rigidité. Elle affecte les neurones producteurs de dopamine dans le cerveau, et chaque année, elle touche plus d'un million de personnes en Inde.
Langue : Python
Jeu de données / Package : Jeu de données UCI ML Parkinsons
Projets de science des données de complexité moyenne
4. Reconnaissance des émotions par la parole
Découvrez la mise en œuvre complète d'un projet de science des données — .
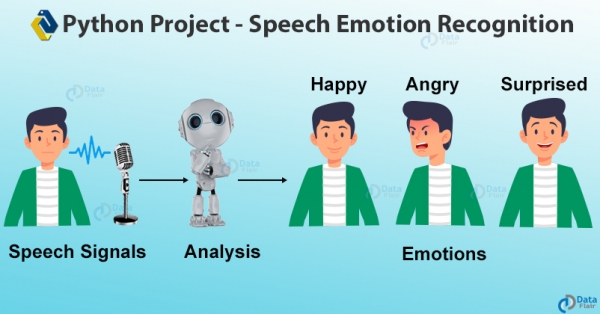
Apprenons maintenant à utiliser différentes bibliothèques. Ce projet de science des données utilise librosa pour la reconnaissance vocale. La reconnaissance des émotions par la parole (SER) est le processus de détermination des émotions humaines et des états affectifs à partir de la parole. Comme nous utilisons le ton et la hauteur pour exprimer des émotions vocales, le SER est pertinent. Cependant, étant donné que les émotions sont subjectives, l'annotation du son est une tâche complexe. Nous utiliserons les fonctions mfcc, chroma et mel et le jeu de données RAVDESS pour la reconnaissance des émotions. Nous créerons un classificateur MLPC pour ce modèle.
Langue : Python
Jeu de données / Package : Jeu de données RAVDESS
5. Détection du sexe et de l'âge
Impressionnez les employeurs avec le dernier projet de science des données — .
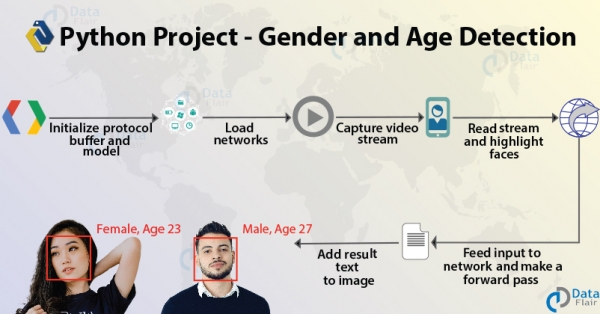
C'est un projet de science des données avec Python. En utilisant une seule image, vous apprendrez à prédire le sexe et l'âge d'une personne. Dans ce projet, nous vous présenterons la vision par ordinateur et ses principes. Nous construirons et utiliserons des modèles formés par Tal Hassner et Gil Levi pour le jeu de données Adience. En cours de route, nous utiliserons certains fichiers .pb, .pbtxt, .prototxt et .caffemodel.
Langue : Python
Jeu de données / Package : Adience
6. Analyse des données Uber
Découvrez la mise en œuvre complète du projet de science des données avec le code source — .
C'est un projet de visualisation de données avec ggplot2, où nous utiliserons R et ses bibliothèques pour analyser différents paramètres. Nous utiliserons le jeu de données Uber Pickups à New York et créerons des visualisations pour différentes périodes de l'année. Cela nous indique comment le temps impacte les trajets des clients.
Langue : R
Jeu de données / Package : Jeu de données Uber Pickups à New York
7. Détection de la somnolence du conducteur
Améliorez vos compétences en travaillant sur le meilleur projet de science des données — .
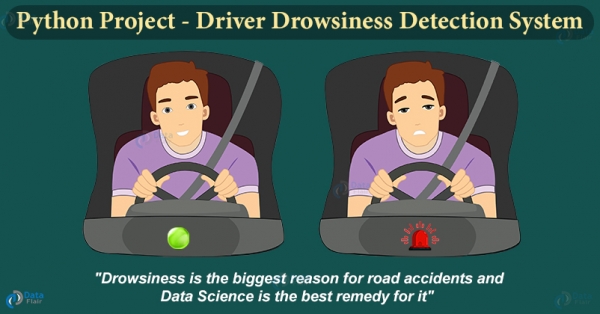
La conduite somnolente est extrêmement dangereuse et chaque année, environ mille accidents se produisent à cause des conducteurs qui s'endorment au volant. Dans ce projet en Python, nous créerons un système capable de détecter les conducteurs somnolents et de les alerter avec un signal sonore.
Ce projet est réalisé en utilisant Keras et OpenCV. Nous allons utiliser OpenCV pour détecter le visage et les yeux, et avec Keras, nous allons classer l'état de l'œil (Ouvert ou Fermé) en utilisant des méthodes de réseau de neurones profonds.
8. Chatbot
Créez un chatbot avec Python et faites un pas en avant dans votre carrière — .
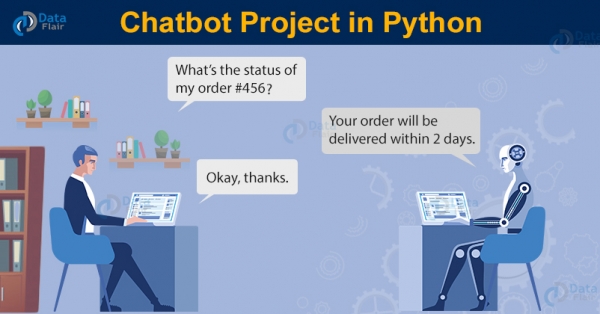
Les chatbots sont essentiels pour les entreprises. De nombreuses entreprises doivent offrir des services à leurs clients, et cela nécessite beaucoup de main-d'œuvre, de temps et d'efforts. Les chatbots peuvent automatiser une grande partie des interactions avec les clients, en répondant à certaines questions fréquentes posées par ceux-ci. En gros, il existe deux types de chatbots : spécifiques au domaine et de domaine ouvert. Le chatbot spécifique au domaine est souvent utilisé pour résoudre un problème particulier. Ainsi, vous devez le configurer pour qu'il fonctionne efficacement dans votre domaine. Les chatbots de domaine ouvert peuvent recevoir toutes sortes de questions, donc leur apprentissage nécessite un énorme volume de données.
Jeu de données : Fichier json d'intentions
Langue : Python
Projets avancés en Data Science
9. Générateur de légendes d'image
Vérifiez la mise en œuvre complète du projet avec le code source — .
Décrire ce qui se trouve sur une image est une tâche facile pour les humains, mais pour les ordinateurs, une image est simplement une série de chiffres représentant la valeur de couleur de chaque pixel. C'est une tâche difficile pour les ordinateurs. Comprendre ce qu'il y a sur l'image et ensuite créer une description en langage naturel (par exemple, en anglais) est une autre tâche complexe. Ce projet utilise des méthodes d'apprentissage profond, dans lequel nous implémentons un Réseau de neurones convolutif (CNN) avec un Réseau de neurones récurrent (LSTM) pour créer un générateur de description d'image.
Jeu de données : Flickr 8K
Langue : Python
Cadre : Keras
10. Détection de fraude par carte de crédit
Faites de votre mieux en travaillant sur l'idée de projet Data Science — .
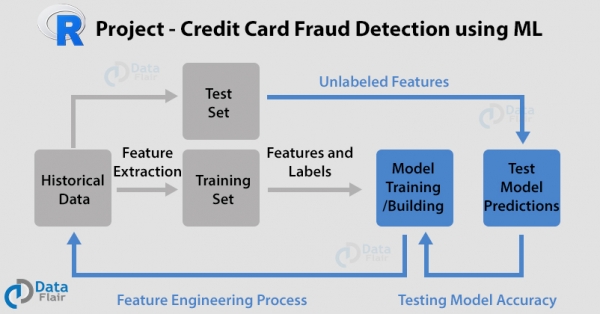
À ce stade, vous avez commencé à comprendre les méthodes et les concepts. Passons à quelques projets avancés en science des données. Dans ce projet, nous allons utiliser le langage R avec des algorithmes tels que , régression logistique, réseaux de neurones artificiels et classificateur de boosting par gradient. Nous utiliserons un ensemble de données sur les transactions par carte pour classifier les transactions de carte de crédit en tant que frauduleuses ou légitimes. Nous sélectionnerons différents modèles pour cela et tracerons des courbes de performance.
Langue : R
Jeu de données / Package : Ensemble de données sur les transactions par carte
11. Système de recommandation de films
Découvrez la mise en œuvre du meilleur projet de Data Science avec le code source —
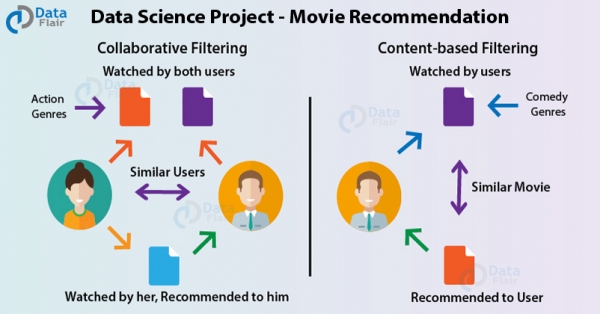
Dans ce projet de Data Science, nous utiliserons R pour effectuer des recommandations de films par le biais de l'apprentissage machine. Le système de recommandation envoie des suggestions aux utilisateurs via un processus de filtrage basé sur les préférences d'autres utilisateurs et l'historique de visionnage. Si A et B aiment Maman, j'ai raté l'avion et que B aime Les filles du calendrier, alors on peut proposer à A — cela pourrait aussi lui plaire. Cela permet aux clients d'interagir avec la plateforme.
Langue : R
Jeu de données / Package : Ensemble de données MovieLens
12. Segmentation des clients
Impressionnez les employeurs avec un projet de Data Science (incluant le code source) — .
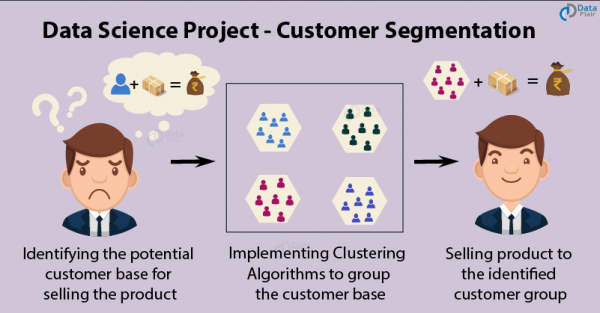
La segmentation des clients est une application populaire . En utilisant la classification, les entreprises définissent des segments de clients pour interagir avec une base utilisateur potentielle. Elles divisent les clients en groupes selon des caractéristiques communes, comme le sexe, l'âge, les intérêts et les habitudes de dépense, afin de vendre efficacement leurs produits à chaque groupe. Nous utiliserons , ainsi que visualiser la répartition par sexe et âge. Ensuite, nous analyserons leurs revenus annuels et leurs niveaux de dépense.
Langue : R
Jeu de données / Package : Ensemble de données Mall_Customers
13. Classification du cancer du sein
Voir la mise en œuvre complète du projet Data Science en Python — .
En revenant à la contribution médicale de la science des données, apprenons à détecter le cancer du sein en utilisant Python. Nous allons utiliser le jeu de données IDC_regular pour identifier le carcinome canalaire invasif, la forme la plus courante de cancer du sein. Ce dernier se développe dans les canaux mammaires et pénètre dans le tissu fibreux ou adipeux du sein à l'extérieur du conduit. Dans cette idée de projet scientifique sur la collecte de données, nous allons utiliser et la bibliothèque Keras pour la classification.
Langue : Python
Jeu de données / Package : IDC_regular
14. Reconnaissance des panneaux de signalisation (Traffic Signs Recognition)
Atteindre la précision dans la technologie de conduite autonome grâce à un projet de science des données sur open source.
Les panneaux de signalisation et le code de la route sont très importants pour chaque conducteur afin d'éviter les accidents. Pour suivre la règle, il est d'abord nécessaire de comprendre à quoi ressemble un panneau de signalisation. Une personne doit apprendre tous les panneaux de signalisation avant qu'on ne lui accorde un permis pour conduire tout véhicule. Mais maintenant, le nombre de véhicules autonomes augmente, et dans un avenir proche, les gens ne conduiront plus eux-mêmes leurs voitures. Dans le projet 'Reconnaissance des panneaux de signalisation', vous apprendrez comment un programme peut reconnaître le type de panneau de signalisation en prenant une image comme entrée. Le jeu de données de reconnaissance des panneaux de signalisation allemand (GTSRB) est utilisé pour construire un réseau de neurones profond afin de reconnaître la classe à laquelle appartient le panneau. Nous créons également une interface graphique simple pour interagir avec l'application.
Langue : Python
Jeu de données : GTSRB (German Traffic Sign Recognition Benchmark)
Lire la suite
Source : habr.com
