

Dans Nous avons parlé de la prévision des séries temporelles. Une suite logique serait un article sur la détection des anomalies.
Application
La détection des anomalies est utilisée dans des domaines tels que :
1) La prévision des pannes d'équipement
Ainsi, en 2010, les centrifugeuses iraniennes ont été attaquées par le virus Stuxnet, qui a mis l'équipement en mode de fonctionnement non optimal et a rendu une partie de l'équipement inutilisable en raison d'une usure accélérée.
Si des algorithmes de détection des anomalies avaient été utilisés sur l'équipement, des situations de panne auraient pu être évitées.
La détection des anomalies dans le fonctionnement des équipements est utilisée non seulement dans l'industrie nucléaire, mais aussi dans la métallurgie et le fonctionnement des turbines aéronautiques. Et dans d'autres domaines, où l'utilisation d'un diagnostic prédictif est moins coûteuse que les pertes potentielles dues à une panne imprévue.
2) La prévision des activités frauduleuses
Si de l'argent est retiré de votre carte utilisée à Podolsk en Albanie, il est possible que les transactions doivent être vérifiées de manière supplémentaire.
3) La détection de modèles de consommation anormaux
Si une partie des clients présente un comportement anormal, il se peut qu'il y ait un problème dont vous n'êtes pas conscient.
4) La détection d'une demande et d'une charge anormales
Si les ventes dans un magasin de produits de grande consommation ont chuté en dessous de la limite de l'intervalle de confiance de la prévision, il est important de trouver la cause de cette situation.
Les approches de détection des anomalies
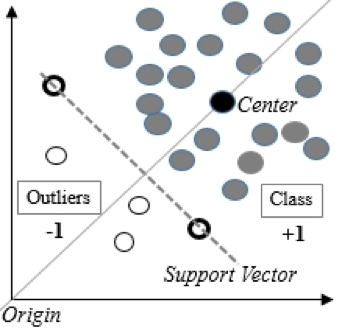
1) Méthode des vecteurs de support à une classe - One-Class SVM
Convient lorsque les données de l'ensemble d'apprentissage suivent une distribution normale, tandis que le test contient des anomalies.
La méthode des vecteurs de support à une classe construit une surface non linéaire autour de l'origine. Il est possible de définir une limite de coupure pour déterminer quelles données considérer comme anormales.
D'après l'expérience de notre équipe DATA4, One-Class SVM est l'algorithme le plus utilisé pour résoudre le problème de détection des anomalies.
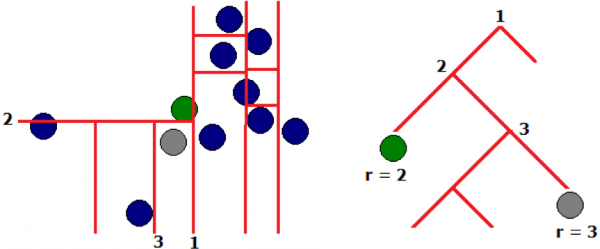
2) Méthode de l'isolement - Isolate Forest
Avec la méthode « aléatoire » de construction des arbres, les valeurs aberrantes se retrouveront dans des feuilles à des stades précoces (à faible profondeur de l'arbre), c'est-à-dire que les valeurs aberrantes sont plus faciles à « isoler ». La mise en évidence des valeurs anormales se produit lors des premières itérations du fonctionnement de l'algorithme.
3) Enveloppe elliptique et méthodes statistiques
Utilisée lorsque les données sont normalement distribuées. Plus la mesure est proche de la queue du mélange de distributions, plus la valeur est considérée comme anormale.
Cette classe inclut également d'autres méthodes statistiques.
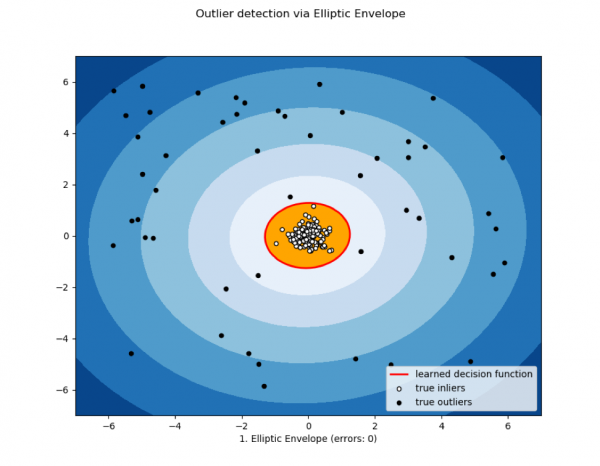
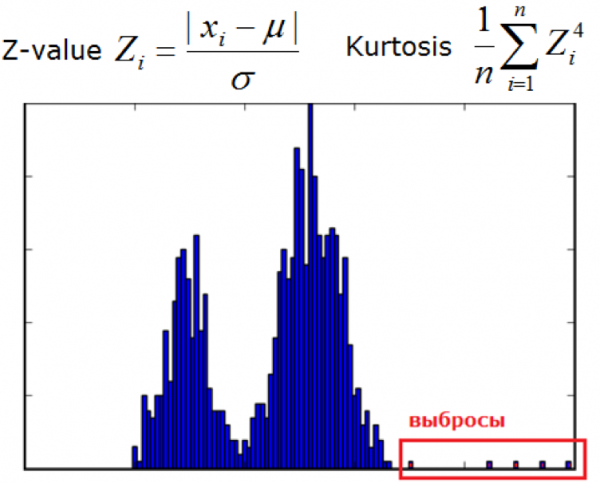
Image provenant du site dyakonov.org
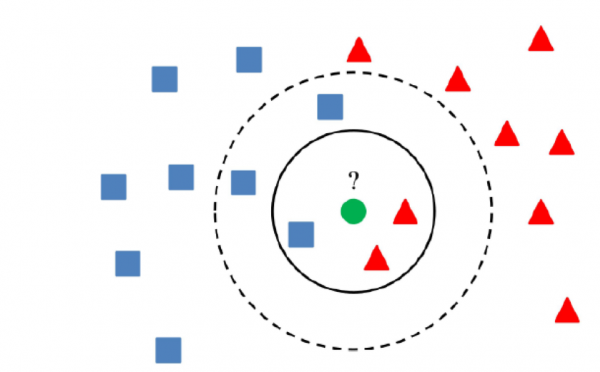
4) Méthodes métriques
Les méthodes comprennent des algorithmes tels que les k-voisins, le k-ème voisin, ABOD (détection des outliers basée sur les angles) ou LOF (facteur d'outlier local).
Elles sont adaptées lorsque la distance entre les valeurs des caractéristiques est équivalente ou normalisée (pour ne pas mesurer un python en perroquets).
L'algorithme k-voisins suppose que les valeurs normales sont situées dans une certaine région de l'espace multidimensionnel, et que la distance aux anomalies sera supérieure à celle de l'hyperplan séparateur.
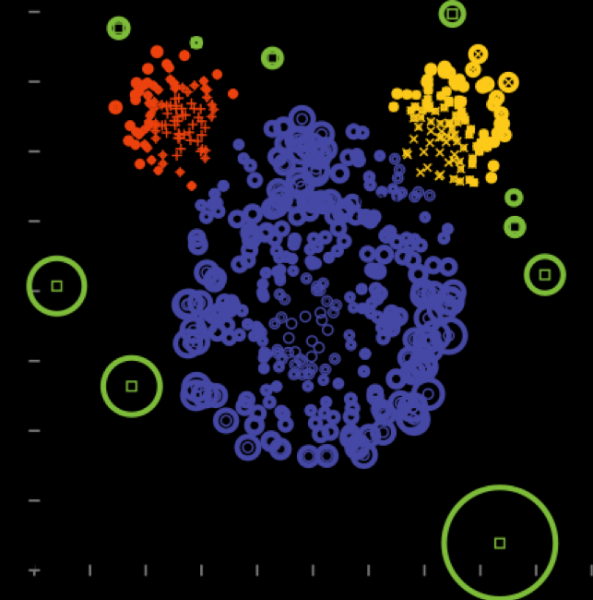
5) Méthodes de clustering
L'essence des méthodes de clustering est que si une valeur est éloignée des centres des clusters au-delà d'une certaine mesure, elle peut être considérée comme anormale.
Il est crucial d'utiliser un algorithme qui clusterise correctement les données, ce qui dépend de la tâche spécifique.
6) Méthode des composants principaux
Adaptée lorsqu'on identifie des directions de variation maximale de la variance.
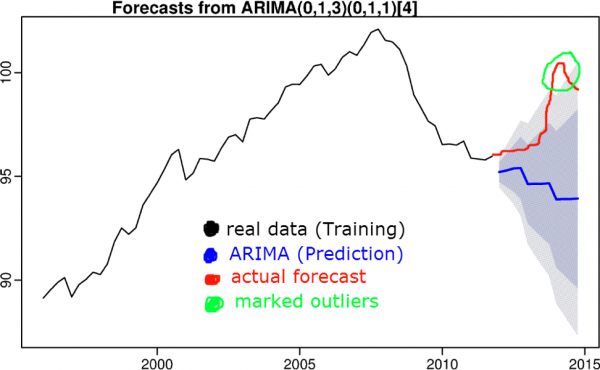
7) Algorithmes basés sur la prévision des séries temporelles
L'idée est que si une valeur s'écarte de l'intervalle de confiance de la prévision, elle est considérée comme anormale. Pour la prévision des séries temporelles, on utilise des algorithmes tels que le lissage triple, S(ARIMA), le boosting, etc.
Les algorithmes de prévision des séries temporelles ont été abordés dans l'article précédent.
8) Apprentissage supervisé (régression, classification)
Si les données le permettent, nous utilisons des algorithmes allant de la régression linéaire aux réseaux récurrents. Nous mesurerons la différence entre la prévision et la valeur réelle, et tirerons des conclusions sur l'anomalie des données. Il est important que l'algorithme ait une capacité généralisante suffisante et que l'échantillon d'apprentissage ne contienne pas de valeurs anormales.
9) Tests sur modèles
Abordons la tâche de détection d'anomalies comme un problème de recommandation. Décomposons notre matrice de caractéristiques à l'aide de SVD ou de machines à factorielles, et considérons comme anormales les valeurs dans la nouvelle matrice qui diffèrent de manière significative des originales.
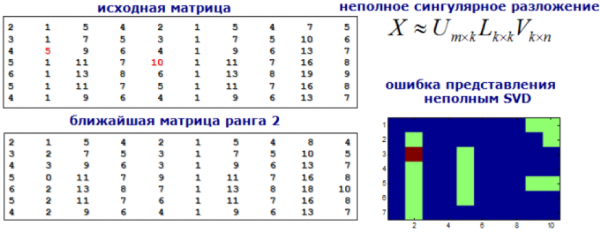
Image provenant du site dyakonov.org
Conclusion
Dans cet article, nous avons examiné les principales approches de la détection d'anomalies.
La détection d'anomalies peut en grande partie être considérée comme un art. Il n'existe pas d'algorithme ou d'approche parfaite permettant de résoudre toutes les tâches. Un ensemble de méthodes est généralement utilisé pour traiter un cas spécifique. La détection d'anomalies s'effectue à l'aide de la méthode des vecteurs de support à une seule classe, de forêts isolantes, de méthodes métriques et de clustering, ainsi que de l'utilisation de l'analyse en composantes principales et de prévisions de séries temporelles.
Si vous connaissez d'autres méthodes, veuillez les mentionner dans les commentaires de l'article.
Source : habr.com
