

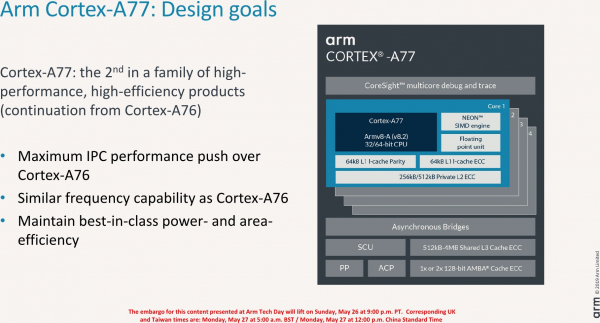
ARM a dévoilé son dernier design de processeur — Cortex-A77. Comme le Cortex-A76 de l'année dernière, ce cœur est destiné aux tâches haut de gamme sur les smartphones et divers appareils. Dans cette version, le développeur vise à augmenter le nombre d'instructions exécutées par cycle (IPC). Les fréquences d'horloge et la consommation d'énergie restent à peu près au même niveau que le Cortex-A76.
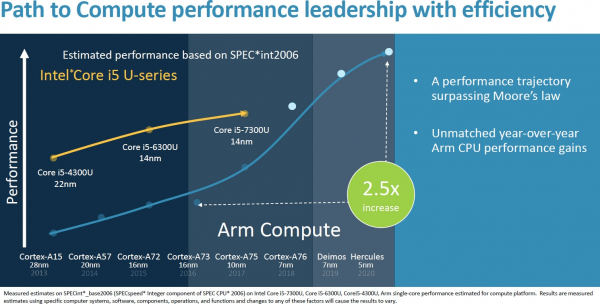
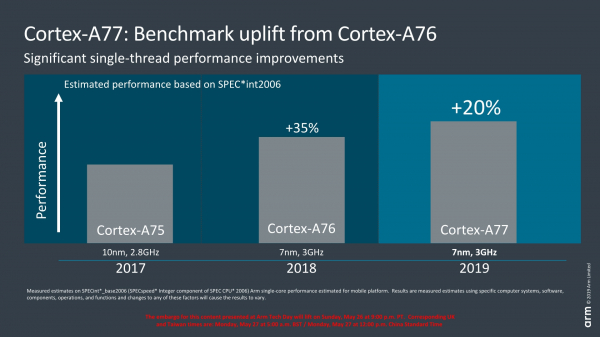
Actuellement, ARM vise à augmenter rapidement les performances de ses cœurs. Selon ses plans, depuis le Cortex-A73 de 2016 jusqu'au design Hercules de 2020, l'entreprise souhaite augmenter la puissance du processeur de 2,5 fois. Les transitions de 16 nm à 10 nm puis à 7 nm ont déjà permis d'augmenter les fréquences d'horloge. Combiné avec l'architecture Cortex-A75 et ensuite le Cortex-A76, ARM estime avoir atteint aujourd'hui une augmentation de performance de 1,8 fois. Le cœur Cortex-A77 permettra désormais d'augmenter le IPC, et par conséquent la performance, de 20 % à la même fréquence d'horloge. Cela signifie qu'une augmentation de 2,5 fois en 2020 devient tout à fait réalisable.
Malgré l'augmentation de 20 % de l'IPC, ARM estime que la consommation d'énergie du A77 n'a pas augmenté. Le compromis ici est que la surface du silicium A77 est d'environ 17 % plus grande que celle du A76, tout en respectant les normes technologiques. En conséquence, le coût d'un noyau individuel augmentera légèrement. En comparant les réalisations d'ARM avec celles des leaders du secteur, il convient de mentionner qu'AMD a réussi une augmentation de 15 % de l'IPC avec Zen 2 par rapport à Zen+, tandis que les valeurs d'IPC des cœurs Intel restent à peu près constantes depuis des années.
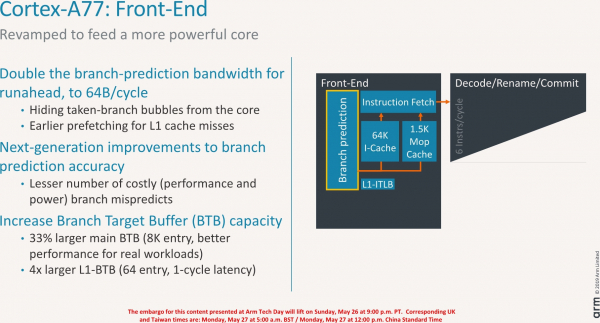
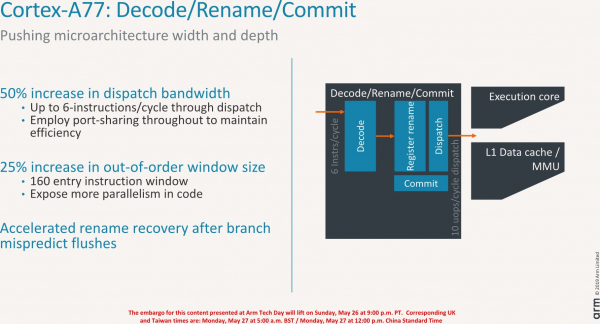
La fenêtre d'exécution avec réorganisation des instructions (out-of-order window size) a été augmentée de 25 %, atteignant 160 unités, ce qui permet au cœur d'augmenter le parallélisme des calculs. Même dans le Cortex-A76, un grand tampon d'adresses de branchement (Branch Target Buffer) était présent, et dans le Cortex-A77, il a été augmenté de 33 %, atteignant 8 Ko, ce qui permet à l'unité de prédiction de branches de gérer efficacement l'augmentation du nombre d'instructions parallèles.
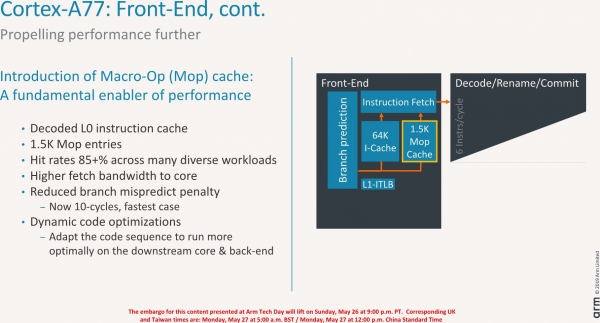
Une autre nouveauté intéressante est le tout nouveau cache de 1,5 Ko, qui conserve les macro-opérations (MOP) retournées par le module de décodage. L'architecture du processeur ARM décode les instructions de l'application utilisateur en macro-opérations plus petites, puis les divise en micro-opérations, qui sont ensuite transmises au cœur d'exécution. Le cache MOP est utilisé pour réduire l'impact des branches manquées et des réinitialisations, car les macro-opérations sont désormais stockées dans un bloc séparé et ne nécessitent pas de redécodage, augmentant ainsi la bande passante globale du cœur. Dans certaines charges de travail, ce nouveau bloc constitue un ajout extrêmement utile au cache d'instructions standard.
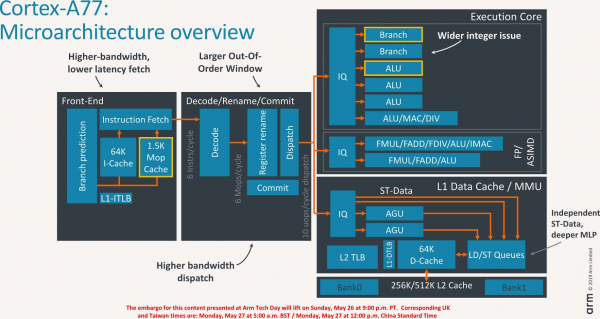
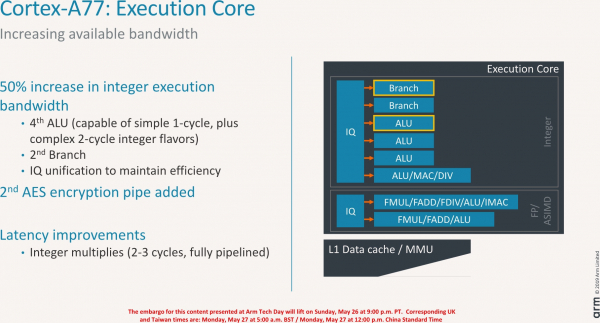
Un quatrième bloc ALU et un deuxième bloc de branchement ont été ajoutés au cœur d'exécution. Le quatrième ALU augmente la bande passante globale du processeur de 1,5 fois grâce à la possibilité d'exécuter des instructions en un cycle (comme ADD et SUB) et des opérations entières en deux cycles, telles que la multiplication. Les deux autres ALU ne peuvent traiter que des instructions de base en un cycle, tandis que le dernier bloc se charge d'opérations mathématiques plus complexes, comme la division, la multiplication avec accumulation, etc. Le deuxième bloc de branchement à l'intérieur du cœur d'exécution double le nombre de transitions de branchement simultanées que le cœur peut traiter, ce qui est utile lorsque deux des six instructions envoyées sont des transitions de branchement. Des tests internes chez ARM ont montré un gain de performance grâce à l'utilisation de ce deuxième bloc de transitions.
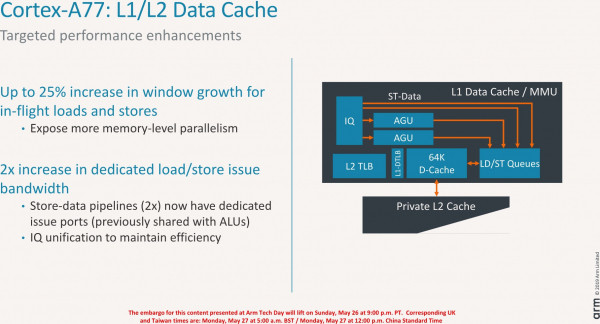
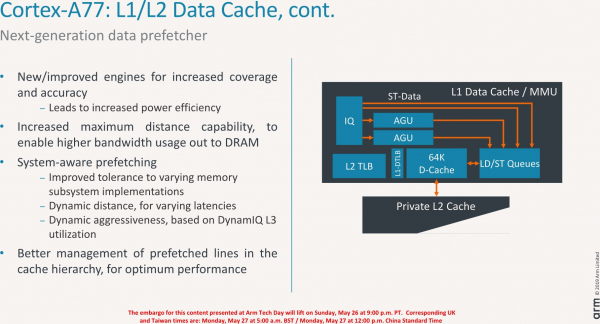
Parmi les autres changements du cœur, on trouve l'ajout d'un deuxième pipeline de chiffrement AES, l'augmentation de la bande passante de la mémoire, un mécanisme de prélecture de données de nouvelle génération amélioré, permettant d'accroître l'efficacité énergétique tout en augmentant la bande passante du système DRAM, des optimisations du fonctionnement du cache, et ainsi de suite.
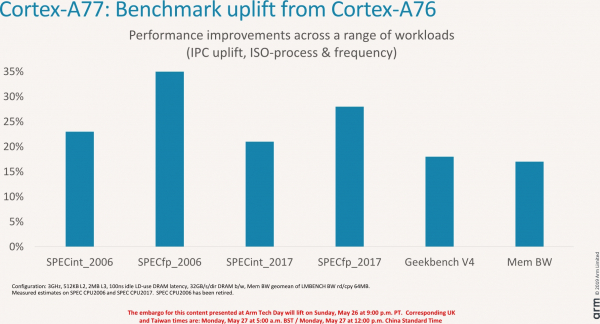
La plus forte croissance est observée dans le Cortex-A77 pour les opérations entières et les calculs à virgule flottante. Cela est confirmé par les tests internes d'ARM dans SPEC, qui ont montré une augmentation de performance de 20 % et 35 % pour les opérations entières et les calculs à virgule flottante respectivement. Les améliorations de bande passante de la mémoire se situent dans une fourchette de 15 à 20 %. Dans l'ensemble, les optimisations et les changements dans l'A77 offrent en moyenne une augmentation de 20 % des performances par rapport à la génération précédente. Grâce à de nouvelles normes technologiques comme les 7 nm ULV, nous pouvons obtenir des avantages supplémentaires dans les puces finales.
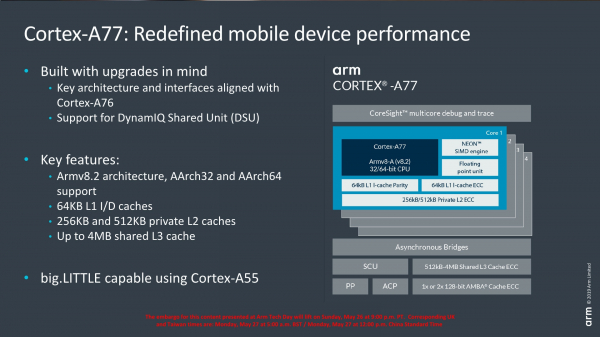
ARM a développé le Cortex-A77 pour fonctionner en tandem 4+4 big.LITTLE (4 cœurs puissants et 4 cœurs simples à faible consommation). Cependant, compte tenu de l'augmentation de la surface de la nouvelle architecture, de nombreux fabricants, pour des raisons d'économie, peuvent proposer des configurations 1+3+4 ou 2+2+4, qui sont déjà pratiquées, où seuls un ou deux cœurs seront des A77 complets non réduits.
Source : 3dnews.ru
