

Si, au début de la pièce, vous dites qu'il y a un code en C++ accroché au mur, alors à la fin, il doit nécessairement vous tirer dans le pied.
Bjarne Stroustrup
Du 31 octobre au 1er novembre, la conférence C++ Russia Piter s'est tenue à Saint-Pétersbourg – l'une des plus grandes conférences sur la programmation en Russie, organisée par JUG Ru Group. Parmi les intervenants invités se trouvaient des membres du comité de normalisation C++, des conférenciers de CppCon, des auteurs de livres publiés par O'Reilly, ainsi que des mainteneurs de projets tels que LLVM, libc++ et Boost. La conférence est destinée aux développeurs expérimentés en C++ souhaitant approfondir leur expertise et échanger des expériences en direct. Des réductions très intéressantes sont offertes aux étudiants, doctorants et enseignants des universités.
L'édition moscovite de la conférence aura lieu en avril de l'année prochaine, mais en attendant, nos étudiants raconteront ce qu'ils ont trouvé d'intéressant lors de l'événement passé.
Photo de
Alconost s'occupe professionnellement de
Ce post a été réalisé par deux étudiants de la HSE - Saint-Pétersbourg :
- Lisa Vasilenko – étudiante en 4e année de licence, spécialisée en « Langages de programmation » dans le cadre du programme « Mathématiques appliquées et informatique ». Ayant découvert le langage C++ lors de sa première année à l'université, elle a ensuite acquis de l'expérience en travaillant avec lors de stages dans l'industrie. Son intérêt pour les langages de programmation en général et la programmation fonctionnelle en particulier a influencé son choix de conférences.
- Danya Smirnov – étudiant en 1re année de master « Programmation et analyse de données ». Déjà à l'école, il écrivait des problèmes olympiques en C++, et par la suite, le langage est devenu un outil de travail principal dans ses études. Il a décidé de participer à la conférence pour renforcer ses connaissances et découvrir de nouvelles opportunités.
Dans la newsletter, la direction de la faculté partage souvent des informations sur des événements éducatifs liés à notre spécialité. En septembre, nous avons vu des informations sur C++ Russia et avons décidé de nous inscrire en tant qu'auditeurs. C'est notre première expérience de participation à de telles conférences.
Structure de la conférence
Conférences
Pendant deux jours, des experts ont lu 30 rapports, abordant de nombreux sujets brûlants : des applications astucieuses des fonctionnalités du langage pour résoudre des problèmes pratiques, les mises à jour à venir du langage en raison de la nouvelle norme, des compromis dans la conception de C++ et des précautions à prendre lors de la gestion de leurs conséquences, des exemples d'architecture de projets intéressants, ainsi que certains détails techniques de l'infrastructure du langage. En parallèle, il y avait trois présentations, la plupart du temps deux en russe et une en anglais.
Zones de discussion
Après la présentation, toutes les questions non posées et les discussions inachevées étaient transférées dans des zones de communication spécialement désignées avec les présentateurs, équipées de tableaux blancs. Une bonne manière de passer le temps durant la pause entre les présentations avec une conversation agréable.
Lightning Talks et discussions informelles
Si vous souhaitez faire une courte présentation, vous pouvez vous inscrire sur le tableau blanc pour une Lightning Talk en soirée et disposer de cinq minutes pour parler de tout sujet lié à la conférence. Par exemple, une introduction rapide aux sanitizers pour C++ (qui était nouvelle pour certains) ou une histoire sur un bug dans la génération de sinusoïdes, que l'on peut entendre mais pas voir.
Un autre format était la table ronde "Avec le comité autour d'un café". Sur scène se trouvaient certains membres du comité de normalisation, sur le projecteur un feu de cheminée (officiellement pour créer une ambiance chaleureuse, mais la raison "parce que TOUT EST EN FLAMME" semble plus amusante), les questions portent sur la norme et la vision générale du C++, sans débats techniques houleux ni guerres de chapelles. Il s'est avéré que des personnes réelles sont également présentes dans le comité, qui peuvent parfois ne pas tout savoir ou manquer de certitudes.
Pour les amateurs de débats, un troisième événement était prévu : la session BOF "Go contre C++". On prend un amateur de Go et un amateur de C++, au début de la session, ils préparent ensemble 100500 diapositives sur le sujet (comme les problèmes de packages en C++ ou l'absence de generics en Go), puis ils discutent de manière animée entre eux et avec le public, tandis que l'auditoire essaie de comprendre deux points de vue. Si un débat s'anime hors sujet, le modérateur intervient pour réconcilier les parties. Ce format est captivant : plusieurs heures après le début, seulement la moitié des diapositives étaient traitées. La fin a dû être fortement accélérée.
Stands des partenaires
Dans les halls, les partenaires de la conférence étaient présentés — des stands racontaient des projets en cours, offraient des stages et des emplois, organisaient des quiz et de petites compétitions, et distribuaient également des prix agréables. De plus, certaines entreprises ont même proposé de passer les premières étapes d'entretiens, ce qui peut être utile pour ceux qui ne sont pas venus seulement pour écouter des présentations.
Détails techniques des présentations
Nous avons écouté des présentations pendant deux jours. Parfois, il était difficile de choisir une présentation parmi celles qui se déroulaient en parallèle — nous avons convenu de nous diviser et d'échanger les connaissances acquises lors des pauses. Et même ainsi, il semble que beaucoup de choses ont été manquées. Ici, nous aimerions parler du contenu de certaines présentations qui nous ont paru les plus intéressantes.
Les exceptions en C++ à travers le prisme des optimisations des compilateurs, Roman Rousaiev
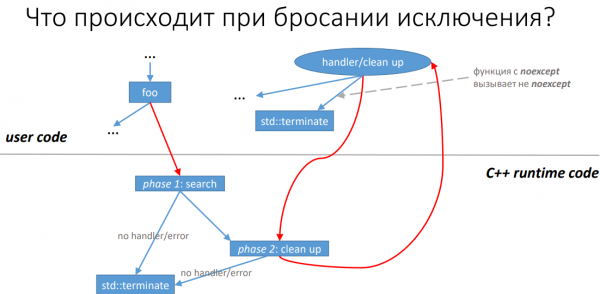
Diapositive de
Comme le titre l'indique, Roman a examiné le traitement des exceptions à l'aide de LLVM. Cependant, pour ceux qui n'utilisent pas Clang dans leur travail, la présentation peut tout de même donner une certaine idée de la façon dont le code peut potentiellement être optimisé. Cela est dû au fait que les développeurs de compilateurs et des bibliothèques standard correspondantes communiquent entre eux et que de nombreuses solutions fructueuses peuvent coïncider.
Pour traiter une exception, il est nécessaire d'effectuer de nombreuses actions : appeler le code de traitement (si disponible) ou libérer les ressources à l'échelon actuel et dérouler la pile plus haut. Tout cela entraîne le fait que pour les appels susceptibles de générer des exceptions, le compilateur ajoute des instructions supplémentaires. Par conséquent, même si l'exception n'est finalement pas déclenchée, le programme exécutera tout de même des actions inutiles. Pour essayer de réduire les coûts, LLVM possède plusieurs heuristiques permettant de déterminer les situations où le code de traitement des exceptions n'est pas nécessaire ou où il est possible de réduire le nombre d'instructions « superflues ».
Le présentateur examine environ une dizaine de ces situations et montre comment elles aident à accélérer l'exécution du programme, ainsi que celles où ces méthodes ne sont pas applicables.
Ainsi, Roman Rousaiev amène les auditeurs à la conclusion que le code contenant des traitements d'exceptions ne peut pas toujours être exécuté sans coûts supplémentaires, et il donne les conseils suivants :
- Lors du développement de bibliothèques, il est préférable de renoncer aux exceptions en principe.
- Si les exceptions sont tout de même nécessaires, il convient d'ajouter des modificateurs noexcept (et const) autant que possible, afin que le compilateur puisse optimiser au maximum.
En général, l'orateur a confirmé que les exceptions devraient être utilisées le moins possible, voire évitées.
Les diapositives de la présentation sont disponibles à l'adresse :
Générateurs, coroutines et autres douceurs débridées, Adi Shavit
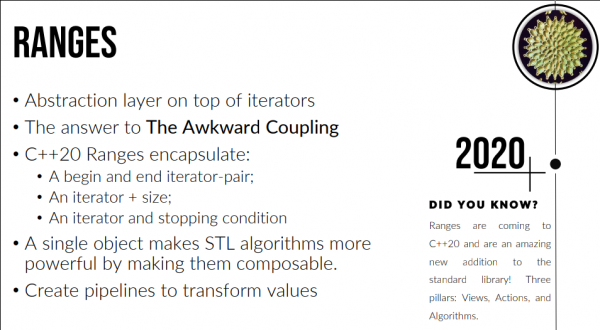
Diapositive de
L'une des nombreuses présentations de cette conférence, consacrée aux nouveautés de C++20, s'est distinguée non seulement par une présentation visuellement attrayante, mais aussi par une définition précise des problèmes logiques rencontrés dans le traitement des collections (boucle for, callbacks).
Adi Shavit souligne les points suivants : les méthodes actuelles parcourent la collection dans son intégralité sans donner accès à un certain état intermédiaire interne (ou le font dans le cas des callbacks, mais avec de nombreux effets secondaires désagréables, comme le fameux Callback Hell). On pourrait penser qu'il existe des itérateurs, mais tout n'est pas si simple : il n'y a pas de points d'entrée et de sortie communs (begin → end contre rbegin → rend, etc.), et il n'est pas clair combien de temps nous allons itérer. Avec C++20, ces problèmes sont résolus !
Première option : ranges. Grâce à un enveloppement autour des itérateurs, nous obtenons une interface commune pour le début et la fin de l'itération, ainsi que la possibilité de composition. Tout cela permet de construire facilement des pipelines de traitement de données complets. Mais tout n'est pas si simple : une partie de la logique de calcul se trouve à l'intérieur de l'implémentation d'un itérateur spécifique, ce qui peut compliquer la lecture et le débogage du code.
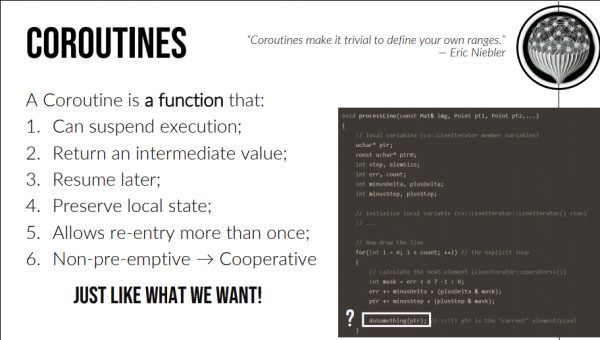
Diapositive de
Eh bien, dans ce cas, C++20 a ajouté des coroutines (des fonctions dont le comportement est similaire aux générateurs en Python) : l'exécution peut être différée, en renvoyant une certaine valeur courante tout en conservant un état intermédiaire. Ainsi, nous parvenons non seulement à travailler avec les données au fur et à mesure de leur apparition, mais nous encapsulons également toute la logique à l'intérieur d'une coroutine spécifique.
Mais il y a un revers à la médaille : à l'heure actuelle, ils ne sont que partiellement pris en charge par les compilateurs disponibles, et leur implémentation n'est pas aussi soignée qu'on le souhaiterait : par exemple, il n'est pas encore recommandé d'utiliser des références et des objets temporaires dans les coroutines. De plus, il existe certaines limitations sur ce que peuvent être les coroutines, et les fonctions constexpr, les constructeurs/destructeurs, ainsi que main ne font pas partie de cette liste.
Ainsi, les coroutines résolvent une partie notable des problèmes de simplicité de la logique de traitement des données, mais leurs implémentations actuelles nécessitent des améliorations.
Matériaux :
- Diapositives de C++ Russia —
Trucs C++ de Yandex.Taxi, Anton Poloukhine
Dans ma vie professionnelle, il m'arrive parfois de devoir réaliser des choses purement auxiliaires : un wrapper entre une interface interne et l'API d'une bibliothèque, de la journalisation ou du parsing. Dans ce cas, il n'y a généralement pas besoin d'optimisation supplémentaire. Mais que se passe-t-il si ces composants sont utilisés dans certains des services les plus populaires du Runet ? Dans cette situation, il faudra traiter des téraoctets de journaux par heure ! Alors chaque milliseconde compte et il faut donc recourir à différentes astuces — c'est ce dont a parlé Anton Poloukhine.
Sans doute, l'exemple le plus intéressant était l'implémentation du patron pointer-to-implementation (pimpl).
#include <third_party/json.hpp> //PROBLEMS!
struct Value {
    Value() = default;
    Value(Value&& other) = default;
    Value& operator=(Value&& other) = default;
    ~Value() = default;

    std::size_t Size() const { return data_.size(); }

private:
    third_party::Json data_;
};
Dans cet exemple, il est d'abord souhaitable de se débarrasser des fichiers d'en-tête des bibliothèques externes — cela accélérera la compilation et permettra de se protéger contre d'éventuels conflits de noms et d'autres erreurs similaires.
Bien, nous avons déplacé #include dans le fichier .cpp : nous avons besoin d'une forward-declaration de l'API enveloppée, ainsi que de std::unique_ptr. Maintenant, nous avons des allocations dynamiques et d'autres désagréments comme des données éparpillées dans le tas et des garanties réduites. Tout cela peut être aidé par std::aligned_storage.
struct Value {
// ...
private:
    using JsonNative = third_party::Json;
    const JsonNative* Ptr() const noexcept;
    JsonNative* Ptr() noexcept;

    constexpr std::size_t kImplSize = 32;
    constexpr std::size_t kImplAlign = 8;
    std::aligned_storage_t data_;
};
Le seul problème : il faut spécifier la taille et l'alignement pour chaque wrapper — faisons notre pimpl générique avec des paramètres , utilisons quelques valeurs arbitraires et ajoutons dans le destructeur une vérification que nous avons tout deviné :
~FastPimpl() noexcept {
    validate();
    Ptr()->~T();
}

template
static void validate() noexcept {
    static_assert(
        Size == ActualSize,
        "Taille et sizeof(T) ne correspondent pas"
    );
    static_assert(
        Alignment == ActualAlignment,
        "Alignement et alignof(T) ne correspondent pas"
    );
}
Puisque le destructeur T est déjà défini lors du traitement, ce code sera correctement analysé et, au stade de la compilation, affichera les valeurs de taille et d'alignement qui doivent être renseignées sous forme d'erreurs. Ainsi, grâce à un seul lancement supplémentaire de la compilation, nous nous débarrassons de l'allocation dynamique des classes enveloppantes, cachons l'API dans un fichier .cpp avec l'implémentation et obtenons également une structure plus adaptée au cache du processeur.
Le journalisation et le parsing semblent moins impressionnants, donc ils ne seront pas mentionnés dans cet aperçu.
Les diapositives de la présentation sont disponibles à l'adresse :
Techniques modernes pour garder votre code DRY, Björn Fahller
Dans cette présentation, Björn Fahller montre plusieurs façons différentes de combattre ce défaut stylistique qu'est la répétition des vérifications de conditions :
assert(a == IDLE || a == CONNECTED || a == DISCONNECTED);Ça vous dit quelque chose ? En utilisant plusieurs techniques puissantes en C++, apparues dans les normes récentes, on peut réaliser élégamment la même fonctionnalité sans aucune perte de performance. Comparez :
assert(a == any_of(IDLE, CONNECTED, DISCONNECTED));Pour traiter un nombre non fixe de vérifications, il convient d'utiliser les templates variadiques et les expressions de pliage. Supposons que nous voulons vérifier l'égalité de plusieurs variables avec un élément de l'énumération state_type. La première chose qui vient à l'esprit est d'écrire une fonction d'assistance is_any_of :
enum state_type { IDLE, CONNECTED, DISCONNECTED };

template
bool is_any_of(state_type s, const Ts& ... ts) {
    return ((s == ts) || ...);
}
Ce résultat intermédiaire est décevant. Jusqu'à présent, le code ne devient pas plus lisible :
assert(is_any_of(state, IDLE, DISCONNECTING, DISCONNECTED)); Un peu de réajustement de la situation sera aidé par les paramètres de template non-types. Grâce à eux, nous allons déplacer les éléments énumérés de l'énumération vers la liste des paramètres du template :
template
bool is_any_of(state_type t) {
    return ((t == states) | ...);
}

assert(is_any_of(state));
Avec l'utilisation de auto dans le paramètre de template non-type (C++17), l'approche est simplement généralisée pour comparer non seulement aux éléments state_type, mais aussi aux types primitifs qui peuvent être utilisés comme paramètres de template non-types :
template
bool is_any_of(const T& t) {
    return ((t == alternatives) | ...);
}
C'est grâce à ces améliorations successives que nous atteignons la syntaxe fluide souhaitée pour les vérifications :
template
struct any_of : private std::tuple {
// héritons des constructeurs de tuple
        using std::tuple::tuple;
        template
        bool operator ==(const T& t) const {
                return std::apply(
                        [&t](const auto& ... ts) {
                                return ((ts == t) || ...);
                        },
                        static_cast<const std::tuple&>(*this));
        }
};

template
any_of(Ts ...) -> any_of;

assert(any_of(IDLE, DISCONNECTING, DISCONNECTED) == state);
Dans cet exemple, le guide de déduction sert à indiquer les paramètres de template souhaités pour la structure au compilateur, qui connaît les types des arguments du constructeur.
Ensuite, ça devient plus intéressant. Bjorn apprend à généraliser le code obtenu pour les opérateurs de comparaison en plus de ==, et ensuite pour des opérations arbitraires. En passant, des fonctionnalités telles que l'attribut no_unique_address (C++20) et les paramètres de template dans les fonctions lambda (C++20) sont expliquées à travers des exemples d'utilisation. (Oui, la syntaxe des lambdas est maintenant encore plus facile à retenir – ce sont quatre paires de parenthèses consécutives de toutes sortes.) La solution finale utilisant des fonctions comme morceaux du constructeur me plaît beaucoup, sans parler de l'expression tuple dans les meilleures traditions du calcul lambda.
À la fin, n'oublions pas de peaufiner :
- Rappelons que les lambdas sont constexpr gratuitement ;
- Ajoutons le perfect forwarding et observons sa syntaxe complexe appliquée à un parameter pack dans la fermeture des lambdas ;
- Offrons plus d'opportunités d'optimisation au compilateur avec conditional noexcept ;
- Prenons soin d'une sortie d'erreurs plus claire dans les templates grâce à des valeurs de retour explicites des lambdas. Cela obligera le compilateur à effectuer plus de vérifications avant l'appel de la fonction template – à l'étape de vérification des types.
Pour plus de détails, contactez les documents de la conférence :
- Diapositives de la présentation :
Nos impressions
Notre première participation à C++ Russia restera gravée dans nos mémoires pour sa richesse. On a eu l'impression que C++ Russia était un événement chaleureux, où la frontière entre apprentissage et interaction vivante est presque imperceptible. Tout, de l'attitude des conférenciers aux concours des partenaires de l'événement, incite à des discussions animées. La partie informative de la conférence, qui consiste en des présentations, couvre un large éventail de sujets, y compris les innovations C++, des exemples pratiques de grands projets et des considérations architecturales idéologiques. Mais il serait injuste de négliger la dimension sociale de l'événement, qui aide à surmonter les barrières linguistiques non seulement en ce qui concerne C++.
Nous remercions les organisateurs de la conférence pour l'opportunité de participer à un événement tel que celui-ci !
Vous avez pu voir le post des organisateurs sur le passé, le présent et l'avenir de C++ Russia .
Merci pour votre lecture, et nous espérons que notre résumé des événements vous a été utile !
Source : habr.com
