

Voici à nouveau une tâche de détection d'objets. La priorité est la rapidité de fonctionnement avec une précision acceptable. Vous utilisez l'architecture YOLOv3 et vous l'affinez. La précision (mAp75) est supérieure à 0,95. Mais la vitesse d'exécution est encore faible. Zut.
Aujourd'hui, nous allons ignorer la quantification. Sous ce lien, nous allons examiner L'élagage de modèles — la suppression des parties redondantes du réseau pour accélérer l'inférence sans perte de précision. Visuellement — d'où, combien et comment on peut couper. Nous examinerons comment le faire manuellement et où nous pouvons automatiser. À la fin — un dépôt sur keras.
Introduction
Dans mon ancien emploi, chez Macroscop à Perm, j'ai pris l'habitude de toujours surveiller le temps d'exécution des algorithmes. Et je vérifiais toujours le temps d'exécution des réseaux à travers un filtre d'adéquation. En général, les state-of-the-art ne passent pas ce filtre en production, ce qui m'a conduit à l'élagage.
L'élagage est un sujet ancien, dont il a été question dans en 2017. L'idée principale est de réduire la taille du réseau entraîné sans perte de précision en supprimant divers nœuds. Cela semble cool, mais j'entends rarement parler de son application. Peut-être qu'il manque des implémentations, qu'il n'y a pas d'articles en langue russe, ou tout simplement que tout le monde considère l'élagage comme un savoir-faire et se tait.
Mais allons y jeter un œil
Un coup d'œil en biologie
J'aime quand des idées provenant de la biologie pénètrent dans le Deep Learning. Elles peuvent être dignes de confiance, tout comme l'évolution (savais-tu que la ReLU ressemble beaucoup à ?)
Le processus d'élagage de modèles est aussi proche de la biologie. La réaction du réseau peut ici être comparée à la plasticité du cerveau. Il y a quelques exemples intéressants dans le livre :
- Le cerveau d'une femme, qui n'avait qu'une moitié depuis sa naissance, s'est reprogrammé pour effectuer les fonctions de l'autre moitié
- Un garçon s'est tiré une balle dans la partie du cerveau responsable de la vision. Avec le temps, d'autres parties du cerveau ont pris en charge ces fonctions. (nous ne tentons pas de répéter cela)
Ainsi, il est possible d'élaguer certaines convolutions faibles de votre modèle. En dernier recours, les convolutions restantes peuvent aider à remplacer celles qui ont été supprimées.
Aimes-tu le transfert d'apprentissage ou tu commences de zéro ?
Option numéro un. Vous utilisez le Transfer Learning avec Yolov3, Retina, Mask-RCNN ou U-Net. Mais le plus souvent, nous n'avons pas besoin de reconnaître 80 classes d'objets comme dans COCO. Dans ma pratique, cela se limite souvent à 1 ou 2 classes. On peut supposer que l'architecture pour 80 classes est ici excessive. L'idée vient alors qu'il faudrait réduire l'architecture, et ce, sans perdre les poids pré-entraînés existants.
Option numéro deux. Peut-être avez-vous beaucoup de données et de ressources de calcul, ou simplement besoin d'une architecture hyper personnalisée. Peu importe. Mais vous entraînez le réseau depuis le début. L'ordre habituel est de regarder la structure des données, de choisir une architecture DE PUISSANCE EXCESSIVE et de pousser les drops out pour éviter le surapprentissage. J'ai vu des drops out à 0,6, Carl.
Dans les deux cas, le réseau peut être réduit. Nous en avons été motivés. Passons maintenant à la question de la réduction, le pruning.
Algorithme général
Nous avons décidé que nous pouvions supprimer des convolutions. Cela semble assez simple :
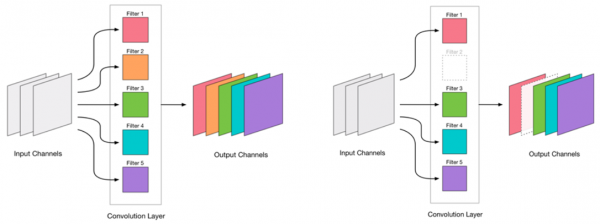
La suppression de toute convolution est un stress pour le réseau, ce qui entraîne généralement une certaine augmentation de l'erreur. D'un côté, cette augmentation de l'erreur est un indicateur de la manière dont nous supprimons correctement les convolutions (par exemple, une grande augmentation signifie que quelque chose ne va pas). Mais une légère augmentation est tout à fait acceptable et se résout souvent par un léger réentraînement avec un LR faible. Ajoutons une étape de réentraînement :
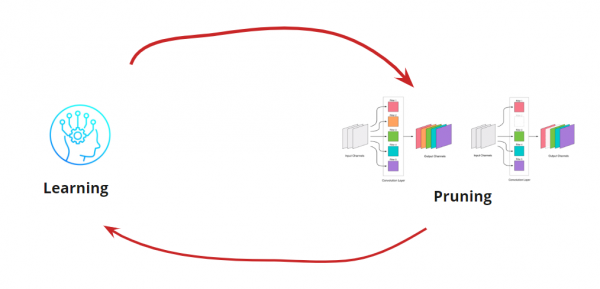
Nous devons maintenant comprendre quand nous souhaitons arrêter notre cycle Apprentissage<->Pruning. Il peut y avoir des cas exotiques où nous devons réduire le réseau à une certaine taille et vitesse d'exécution (par exemple, pour des appareils mobiles). Cependant, le cas le plus fréquent est de poursuivre le cycle tant que l'erreur ne dépasse pas un seuil acceptable. Ajoutons une condition :
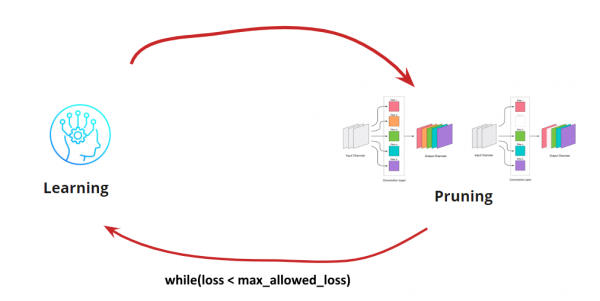
Ainsi, l'algorithme devient clair. Reste à déterminer quelles convolutions supprimer.
Recherche de convolutions à supprimer
Nous devons supprimer certaines convolutions. Aller à l'aveugle et « tirer » n'importe lesquelles est une mauvaise idée, même si cela fonctionnera. Mais puisque nous avons une tête, nous pouvons réfléchir et essayer de sélectionner les convolutions « faibles » à supprimer. Il existe plusieurs options :
- . L'idée stipule que les convolutions avec de petits poids contribuent peu à la prise de décision finale.
- La plus petite mesure L1 prenant en compte la moyenne et l'écart type. Complété par une évaluation de la nature de la distribution.
- . Une définition plus précise des convolutions insignifiantes, mais très coûteuse en temps et en ressources.
- Autres
Chacune des options a le droit d'exister et ses spécificités de mise en œuvre. Nous allons examiner l'option avec la plus petite mesure L1.
Processus manuel pour YOLOv3
L'architecture de base contient des blocs résiduels. Mais quel que soit leur niveau de sophistication pour les réseaux profonds, ils peuvent nous poser problème. La difficulté réside dans le fait qu'il n'est pas possible de supprimer des convolutions avec des indices différents dans ces couches :
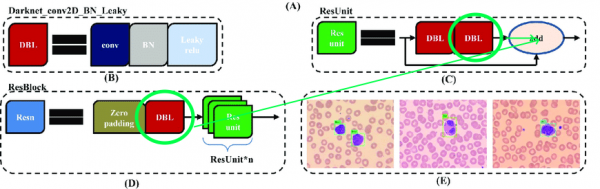
Nous allons donc identifier les couches dont nous pouvons supprimer librement les convolutions :

Nous allons maintenant construire la boucle de travail :
- Déchargeons les activations
- Estimons combien couper
- Découpons
- Entraînons pendant 10 époques avec LR=1e-4
- Testons
Décharger les convolutions est utile pour évaluer quelle partie nous pouvons supprimer à un moment donné. Exemples de décharge :
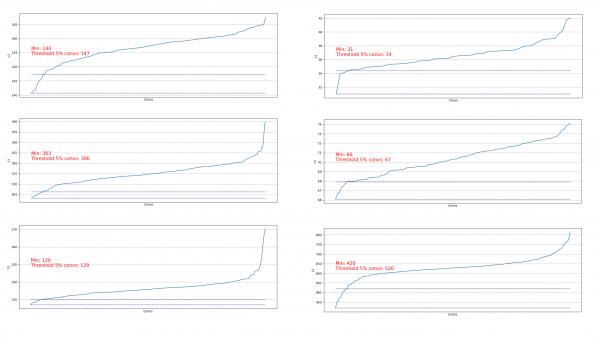
Nous voyons que presque partout 5 % des convolutions ont une norme L1 très faible et nous pouvons les supprimer. À chaque étape, cette décharge était répétée et il a été évalué de quelles couches et combien il était possible de couper.
Le processus entier s'est déroulé en 4 étapes (ici et partout, les nombres pour RTX 2060 Super) :
| Étape | mAp75 | Nombre de paramètres, millions | Taille du réseau, Mo | Par rapport à l'initial, % | Temps d'exécution, ms | Condition de coupure |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5 % de l'ensemble |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5 % de l'ensemble |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15 % pour les couches avec 400+ convolutions |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10 % pour les couches avec 100+ convolutions |
À la 2ème étape, un effet positif a été ajouté : la taille de lot de 4 est entrée dans la mémoire, ce qui a considérablement accéléré le processus de réentraînement.
À la 4ème étape, le processus a été arrêté, car même un long réentraînement n'augmentait pas le mAp75 aux anciens niveaux.
Au final, il a été possible d'accélérer l'inférence de 15%, de réduire la taille de 35% et de ne pas perdre en précision.
Automatisation pour des architectures plus simples
Pour des architectures de réseaux plus simples (sans blocs conditionnels add, concaterner et résiduels), il est tout à fait possible de se concentrer sur le traitement de toutes les couches convolutives et d'automatiser le processus de découpe des convolutions.
J'ai implémenté une telle option .
C'est simple : vous avez juste besoin de la fonction de perte, de l'optimiseur et des générateurs de lots :
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Si nécessaire, vous pouvez modifier les paramètres de configuration :
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # le nombre d'époques pour l'entraînement entre les étapes de pruning
    "stop_loss": 0.1, # perte pour arrêter le processus
    "pruning_percent_step": 0.05, # part des convs à supprimer à chaque étape de pruning
    "pruning_standart_deviation_part": 0.2 # décalage pour limiter la partie prune
}
Une restriction a également été mise en œuvre sur la base de l'écart type. L'objectif est de limiter la partie supprimée, en excluant les convolutions ayant déjà des mesures L1 « suffisantes » :
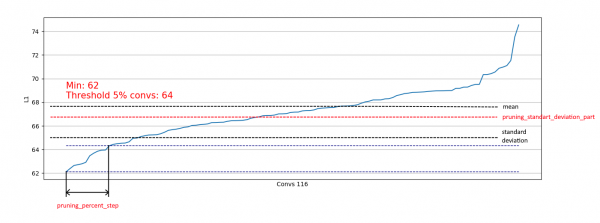
Ainsi, nous permettons de supprimer uniquement les faibles convolutions des distributions similaires à celle de droite sans influencer la suppression des distributions similaires à celle de gauche :
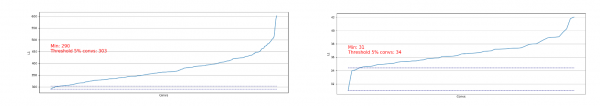
À mesure que la distribution se rapproche de la normale, le coefficient pruning_standart_deviation_part peut être ajusté à partir de :
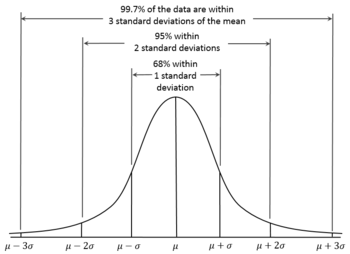
Je recommande un écart de 2 sigmas. Ou vous pouvez ne pas vous fier à cette particularité, en laissant une valeur < 1,0.
Le résultat est un graphique de la taille du réseau, de la perte et du temps d'exécution du réseau tout au long du test, normalisé à 1,0. Par exemple, ici la taille du réseau a été presque réduite de moitié sans perte de qualité (un petit réseau de convolution avec 100k poids) :
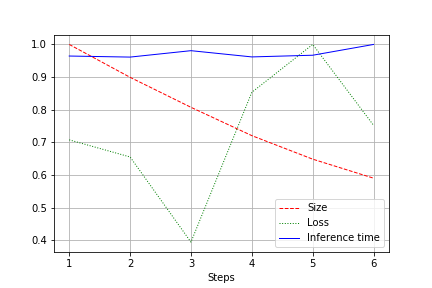
La vitesse d'exécution est sujette à des fluctuations normales et n'a pratiquement pas changé. Cela s'explique par :
- Le nombre de convolutions change de pratiques (32, 64, 128) à des valeurs moins adaptées aux cartes graphiques — 27, 51, etc. Je peux me tromper, mais cela influence probablement.
- L'architecture n'est pas large, mais séquentielle. En diminuant la largeur, nous ne touchons pas à la profondeur. Ainsi, nous réduisons la charge sans changer la vitesse.
Par conséquent, l'amélioration s'est traduite par une réduction de la charge CUDA lors de l'exécution de 20 à 30 %, mais pas par une diminution du temps d'exécution.
Résultats
Réfléchissons. Nous avons considéré 2 options de pruning — pour YOLOv3 (quand il faut travailler manuellement) et pour des réseaux avec des architectures plus simples. Il est évident que dans les deux cas, il est possible d'atteindre une réduction de la taille du réseau et une accélération sans perte de précision. Résultats :
- Réduction de la taille
- Accélération de l'exécution
- Réduction de la charge CUDA
- Par conséquent, écologiquement (nous optimisons l'utilisation future des ressources de calcul. Quelque part, une personne se réjouit : )
Annexe
- Après l'étape de pruning, on peut aussi procéder à la quantification (par exemple avec TensorRT)
- Tensorflow offre des possibilités pour . Ça fonctionne.
- je veux développer et je serais heureux de toute aide
Source : habr.com
