

La société Google a présenté un nouveau codec audio, Lyra, optimisé pour garantir une qualité maximale de transmission de la parole, même sur des liaisons très lentes. Le code de l'implémentation de Lyra, écrit en C++, est libre sous la licence Apache 2.0, mais l'une des dépendances nécessaires à son fonctionnement est la bibliothèque propriétaire libsparse_inference.so, qui contient le noyau pour les calculs mathématiques. Il est noté que cette bibliothèque propriétaire est temporaire — Google promet de développer par la suite un remplacement open source et de garantir le support de différentes plateformes.
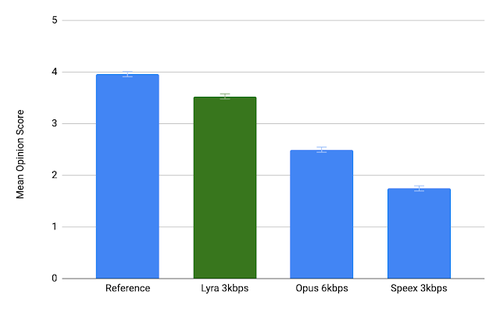
En termes de qualité des données vocales transmises à bas débits, Lyra surpasse considérablement les codecs traditionnels utilisant des méthodes de traitement numérique du signal. Pour atteindre une qualité vocale élevée dans des conditions de bande passante limitée, en plus des méthodes de compression audio et de transformation des signaux, Lyra utilise un modèle de parole reposant sur un système d'apprentissage machine, permettant de recréer les informations manquantes en fonction des caractéristiques typiques de la voix. Le modèle utilisé pour générer le son a été formé avec plusieurs milliers d'heures d'enregistrements de voix dans plus de 70 langues.
Le codec comprend un encodeur et un décodeur. L'algorithme de travail de l'encodeur consiste à extraire les paramètres des données vocales toutes les 40 millisecondes, à les compresser et à les transmettre au destinataire via le réseau. Une bande passante de seulement 3 kilobits par seconde est suffisante pour transmettre les données. Les paramètres sonores extraits incluent des mél-spectrogrammes logaritmiques, prenant en compte les caractéristiques de l'énergie vocale dans différentes gammes de fréquences et préparés selon le modèle de perception auditive humaine.
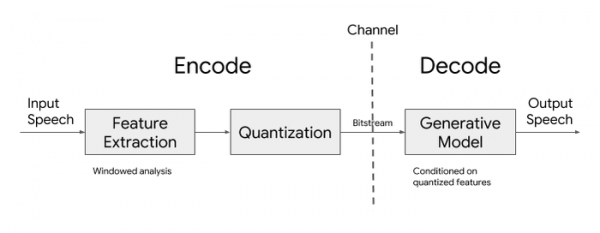
Le décodeur utilise un modèle génératif qui recrée le signal vocal en fonction des paramètres sonores fournis. Pour réduire la complexité des calculs, un modèle léger basé sur un réseau de neurones récurrent, qui représente une variante du modèle de synthèse vocale WaveRNN, a été appliqué, utilisant une fréquence d'échantillonnage plus basse tout en générant simultanément plusieurs signaux dans différentes gammes de fréquences. Les signaux obtenus sont ensuite superposés pour produire un signal de sortie unique correspondant à la fréquence d'échantillonnage spécifiée.
Des instructions processeur spécialisées disponibles dans les processeurs ARM 64 bits ont également été utilisées pour accélérer les performances. En conséquence, malgré l'utilisation de l'apprentissage automatique, le codec Lyra peut être utilisé pour coder et décoder la parole en temps réel sur des smartphones de milieu de gamme, présentant un délai de transmission de signal d'environ 90 millisecondes.
Source : opennet.ru
