

Un groupe de chercheurs de l'université de Tel-Aviv a présenté HyperStyle, une version inversée du système d'apprentissage automatique StyleGAN2 développé par NVIDIA, qui a été retravaillée pour recréer les parties manquantes lors de l'édition d'images réelles. Le code est écrit en Python en utilisant le cadre PyTorch et est distribué sous la licence MIT.
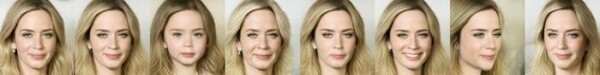
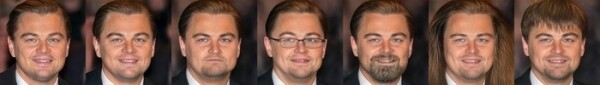
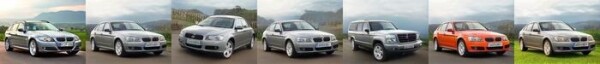
Alors que StyleGAN permet de synthétiser de nouveaux visages réalistes en définissant des paramètres tels que l'âge, le sexe, la longueur des cheveux, le caractère du sourire, la forme du nez, la couleur de la peau, les lunettes et l'angle de la photo, HyperStyle permet de modifier des paramètres similaires sur des photographies existantes, sans altérer leurs caractéristiques distinctives et en préservant la reconnaissabilité du visage d'origine. Par exemple, à l'aide d'HyperStyle, on peut simuler le vieillissement d'une personne sur une photo, changer la coiffure, ajouter des lunettes, une barbe ou une moustache, donner à l'image l'apparence d'un personnage de dessin animé ou d'une peinture, ou modifier l'expression du visage pour la rendre triste ou joyeuse. De plus, le système peut être entraîné non seulement pour changer les visages des gens, mais aussi pour tout objet, comme pour l'édition d'images de voitures.
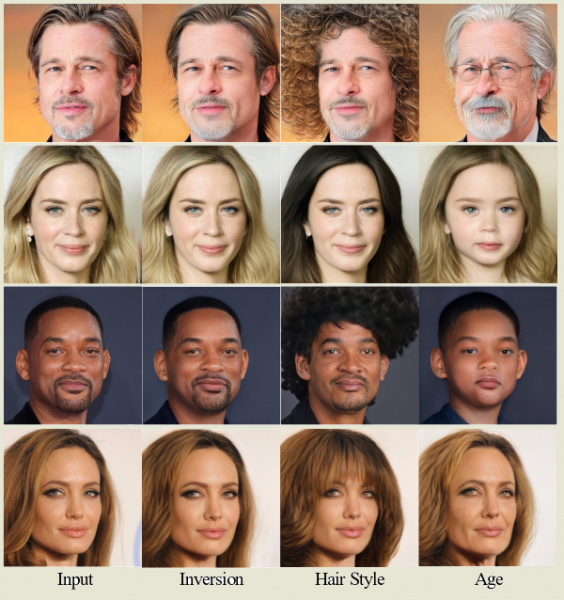
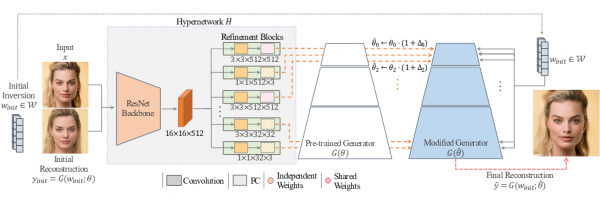
La méthode proposée vise à résoudre le problème de la reconstruction des parties manquantes d'une image lors de l'édition. Dans les méthodes précédemment proposées, le compromis entre reconstruction et éditabilité était réglé par un ajustement fin du générateur d'images pour substituer les parties de l'image cible lors de la recréation des zones éditables initialement manquantes. Le principal inconvénient de ces approches est la nécessité d'une longue formation ciblée du réseau neuronal pour chaque image.
La méthode basée sur l'algorithme StyleGAN permet d'utiliser un modèle standard, préalablement entraîné sur des collections d'images communes, pour générer des éléments caractéristiques de l'image d'origine avec un niveau de fidélité comparable à celui des algorithmes nécessitant un entraînement individuel du modèle pour chaque image. Parmi les avantages de cette nouvelle méthode, on note également la capacité à modifier des images avec une performance proche du temps réel.
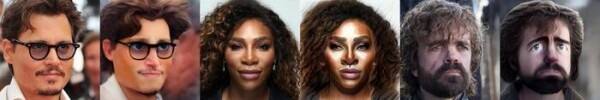
Des modèles préentrainés sont disponibles pour les visages humains, les machines et les animaux, basés sur des collections telles que Flickr-Faces-HQ (FFHQ, 70 000 images PNG haute qualité de visages humains), Stanford Cars (16 000 images de voitures) et AFHQ (photos d'animaux). Un outil d'entraînement de modèles est également fourni, ainsi que des modèles préentrainés prêts à l'emploi de codeurs et de générateurs standard. Par exemple, des générateurs sont disponibles pour créer des images dans le style Toonify, des personnages Pixar, pour dessiner des esquisses et même pour styliser à la manière des princesses des dessins animés Disney.
Source : opennet.ru
