

Il est important pour nous de comprendre ce qui se passe avec nos étudiants pendant leur apprentissage et comment ces événements influencent les résultats. C'est pourquoi nous construisons une Customer Journey Map — une carte de l'expérience client. En effet, le processus d'apprentissage n'est pas quelque chose de continu et homogène, c'est une chaîne d'événements et d'actions liés, et ces actions peuvent varier considérablement d'un élève à l'autre. Une fois qu'il a terminé une leçon : que va-t-il faire ensuite ? Va-t-il faire ses devoirs ? Lancer une application mobile ? Changer de cours, demander à changer de professeur ? Passer directement à la leçon suivante ? Ou repartira-t-il déçu ? Est-il possible, en analysant cette carte, d'identifier des modèles qui conduisent à une réussite du cours ou, à l'inverse, à l'abandon de l'étudiant ?
Habituellement, pour élaborer une CJM, on utilise des outils spécialisés, souvent coûteux, avec un code fermé. Mais nous voulions concevoir quelque chose de simple, nécessitant un minimum d'efforts et, si possible, open source. C'est ainsi qu'est née l'idée d'utiliser des chaînes de Markov — et nous y sommes parvenus. Nous avons construit une carte, interprété les données sur le comportement des étudiants sous forme de graphe, et découvert des réponses totalement inattendues à des questions commerciales majeures, ainsi que des bogues profondément cachés. Tout cela a été réalisé grâce à des solutions open source et à un script Python. Dans cet article, je vais vous parler de deux cas avec ces résultats surprenants et partager le script avec tous les intéressés.
Ainsi, les chaînes de Markov montrent la probabilité des transitions entre les événements. Voici un exemple primitif provenant de Wikipédia :
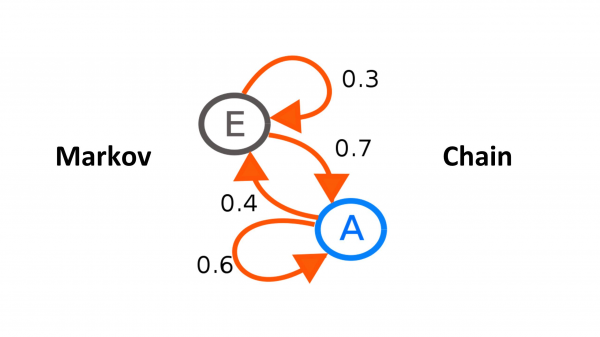
Ici, « E » et « A » sont des événements, les flèches représentent les transitions entre eux (y compris les transitions d'un événement à lui-même), et les poids des flèches sont la probabilité de transition (un « graphe orienté pondéré »).
Ce qui a été utilisé
La chaîne a été entraînée avec la fonctionnalité standard de Python, à laquelle ont été fournis les journaux d'activité des étudiants. Le graphe de la matrice obtenue a été construit avec la bibliothèque NetworkX.
Le journal ressemble à ceci :
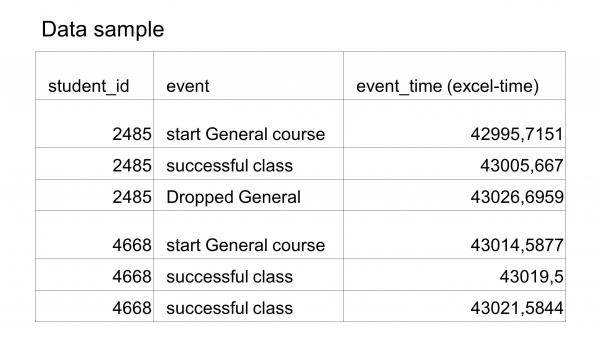
C'est un fichier csv contenant un tableau de trois colonnes : l'id de l'étudiant, la description de l'événement, et le moment où il s'est produit. Ces trois champs sont suffisants pour suivre les mouvements du client, construire la carte et, au final, obtenir une chaîne de Markov.
La bibliothèque renvoie des graphes construits au format .dot ou .gexf. Pour visualiser les premiers, on peut utiliser le paquet gratuit Graphviz (l'outil gvedit), nous avons travaillé avec .gexf et Gephi, qui est également gratuit.
Je souhaite maintenant donner deux exemples d'utilisation des chaînes de Markov qui nous ont permis de réexaminer nos objectifs, nos processus d'apprentissage et l'écosystème Skyeng lui-même. Et aussi de corriger quelques bogues.
Premier cas : application mobile
Pour commencer, nous avons étudié le parcours de l'élève avec notre produit le plus populaire - le cours General. À ce moment-là, je travaillais dans le département pour enfants de Skyeng et nous voulions voir à quel point l'application mobile fonctionne efficacement avec notre public enfant.
En prenant les logs et en les faisant passer par un script, j'ai obtenu quelque chose comme ça :
Le noeud de départ - Start General, et en bas trois noeuds de sortie : l'élève « s'est endormi », a changé de cours, a terminé le cours.
- S'est endormi, « Endormi » - signifie qu'il ne suit plus les cours, probablement qu'il a abandonné. Nous appelons de manière optimiste cet état « endormi », car en théorie, il conserve la possibilité de reprendre l'éducation. C'est notre pire résultat.
- A abandonné général, Changer de cours - est passé de General à autre chose et s'est perdu pour notre chaîne de Markov.
- A terminé le cours, État idéal, la personne a suivi 80 % des leçons (toutes les leçons ne sont pas obligatoires).
Atteindre le noeud de cours réussi signifie avoir réussi une leçon sur notre plateforme avec un enseignant. Cela fixe les progrès dans le cours et rapproche de l'objectif souhaité - « A terminé le cours ». Il est important pour nous que les élèves y assistent le plus possible.
Pour obtenir des conclusions quantitatives plus précises pour l'application mobile (noeud session app), nous avons construit des chaînes distinctes pour chacun des noeuds finaux et avons ensuite comparé les poids des bords deux à deux :
- de la session app à elle-même ;
- de la session app à cours réussi ;
- de cours réussi à session app.
À gauche - étudiants ayant terminé le cours, à droite - « endormis »
Ces trois bords montrent le lien entre le succès de l'étudiant et son utilisation de l'application mobile. Nous nous attendions à ce que les étudiants ayant terminé le cours aient un lien plus fort avec l'application que les « endormis ». Cependant, en réalité, nous avons obtenu des résultats exactement opposés :
- nous avons constaté que différents groupes d'utilisateurs interagissent différemment avec l'application mobile ;
- Les étudiants performants utilisent moins intensivement l'application mobile ;
- Les étudiants distraits utilisent l'application mobile de manière plus active.
Cela signifie que les étudiants « distraits » commencent à passer de plus en plus de temps dans l'application mobile et finissent par y rester indéfiniment.
Au début, cela nous a surpris, mais après réflexion, nous avons compris que c'était un effet tout à fait attendu. À une époque, j'ai appris le français par moi-même en utilisant deux outils : l'application mobile et des cours de grammaire sur YouTube. Au départ, je partageais mon temps entre les deux à raison de 50/50. Mais l'application est plus amusante, elle est gamifiée, tout y est simple, rapide et clair, alors que les leçons nécessitent d'y prêter attention, de prendre des notes et de pratiquer sur un cahier. Progressivement, j'ai commencé à passer plus de temps sur mon smartphone, jusqu'à ce que sa part atteigne 100 % : si je reste dessus pendant trois heures, cela crée une fausse impression d'avoir accompli quelque chose, ce qui ne me donne aucune envie d'aller écouter quelque chose.
Mais comment cela se fait-il ? Après tout, nous avons créé l'application mobile exprès, , nous l'avons gamifiée, la rendant attrayante pour que les gens y passent du temps, et il s'avère qu'elle les distrait seulement ? En réalité, la raison réside dans le fait que l'équipe de développement de l'application mobile a trop bien réussi sa mission, ce qui a fait de celle-ci un produit autonome de qualité, se détachant ainsi de notre écosystème.
Au terme de l'étude, il est devenu évident que l'application mobile devait être modifiée pour qu'elle nuise moins au parcours d'apprentissage principal. Cela s'applique tant aux enfants qu'aux adultes. Ce travail est actuellement en cours.
Deuxième cas : bugs d'onboarding
L'onboarding est une procédure supplémentaire facultative lors de l'inscription d'un nouvel élève, visant à éviter de potentiels problèmes techniques à l'avenir. Le scénario de base suppose qu'une personne s'est inscrite sur la page d'atterrissage, a obtenu l'accès à son espace personnel, qu'un contact est établi et qu'un cours d'introduction est donné. Cependant, nous constatons un taux élevé de difficultés techniques lors de ce cours d'introduction : version de navigateur incorrecte, microphone ou son qui ne fonctionnent pas, l'enseignant ne peut pas immédiatement fournir une solution, et tout cela est d'autant plus compliqué lorsqu'il s'agit d'enfants. C'est pourquoi nous avons développé une application complémentaire dans l'espace personnel où l'on peut effectuer quatre étapes simples : vérifier le navigateur, la caméra, le microphone et confirmer que les parents seront présents pendant le cours d'introduction (car ce sont eux qui paient pour l'éducation des enfants).
Ces quelques pages d'onboarding ont montré un tel entonnoir :
1 : un bloc de départ avec trois formulaires légèrement différents (selon le client) pour entrer le login et le mot de passe.
2 : case à cocher pour l'acceptation de la procédure d'onboarding supplémentaire.
2.1-2.3 : vérification de la présence d'un parent, de la version de Chrome et du son.
3 : bloc final.
Il a l'air très naturel : lors des deux premières étapes, la majorité des visiteurs abandonnent, réalisant qu'ils doivent remplir quelque chose, vérifier, alors qu'ils n'ont pas le temps. Si un client arrive à la troisième étape, il est presque certain d'atteindre la fin. Dans l'entonnoir, aucune raison de soupçonner quoi que ce soit n'est visible.
Cependant, nous avons décidé d'analyser notre onboarding non pas sur un entonnoir unidimensionnel classique, mais en utilisant une chaîne de Markov. Nous avons inclus un peu plus d'événements, lancé le script et obtenu ceci :
Il est clair qu'il n'y a qu'une seule conclusion à tirer dans ce chaos : quelque chose s'est mal passé. Le processus d'onboarding est linéaire, cela est inscrit dans le design, et il ne devrait en aucun cas y avoir une telle toile de liens. Or, il est immédiatement évident que l'utilisateur est balancé d'une étape à l'autre, entre lesquelles il ne devrait pas y avoir de transitions.
Les raisons de ce tableau étrange peuvent être deux :
- des erreurs se sont glissées dans la base de logs ;
- des erreurs sont présentes dans le produit lui-même — l'onboarding.
La première raison est probablement valable, mais la vérifier est assez laborieux, et la correction des journaux ne va pas améliorer l'expérience utilisateur. Pour ce qui est de la seconde, s'il y en avait une, il fallait agir rapidement. Nous avons donc commencé à examiner les nœuds, à identifier les arêtes qu'il ne devrait pas y avoir, à chercher les causes de leur apparition. Nous avons constaté que certains utilisateurs se retrouvaient bloqués dans une boucle, d'autres sortaient du milieu pour revenir au début, et d'autres encore ne pouvaient tout simplement pas sortir des deux premières étapes. Nous avons transféré les données à l'équipe QA — et oui, il s'est avéré qu'il y avait de nombreux bugs dans le programme d'intégration : c'est un produit un peu bricolé, qui n'a pas été suffisamment testé car aucun problème n'était attendu. Maintenant, l'ensemble du processus d'enregistrement a changé.
Cette histoire nous a montré une application inattendue des chaînes de Markov dans le domaine de la QA.
Essayez vous-même !
J'ai publié mon en accès libre — profitez-en. La documentation est sur GitHub, vous pouvez poser des questions ici, j'essaierai de répondre à toutes.
Et voici des liens utiles : , . Et ici sur les chaînes de Markov. Les graphes dans l'article sont réalisés avec .
Source : habr.com
