

Deuxième partie :
Toute image raster peut être représentée sous la forme d'une matrice bidimensionnelle . Lorsqu'on parle de couleurs, l'idée peut être développée en considérant l'image comme unematrice tridimensionnelle , dans laquelle des dimensions supplémentaires sont utilisées pour stocker les données de chaque couleur.Si l'on considère la couleur finale comme une combinaison des soi-disant couleurs primaires (rouge, vert et bleu), dans notre matrice tridimensionnelle, nous définissons trois plans : le premier pour la couleur rouge, le deuxième pour le vert et le dernier pour le bleu.
Nous appellerons chaque point de cette matrice un pixel (élément de l'image). Chaque pixel contient des informations sur l'intensité (généralement sous forme de valeur numérique) de chaque couleur. Par exemple,
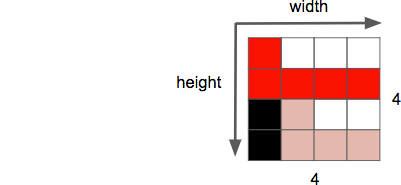
un pixel rouge signifie qu'il n'y a 0 vert, 0 bleu et un maximum de rouge. Un pixel rose peut être formé à l'aide d'une combinaison des trois couleurs. En utilisant une plage numérique de 0 à 255, un pixel rose est défini comme Rouge = 255 Vert = 192, Bleu = 203 et Cet article est publié avec le soutien de la société EDISON..
Nous développonsdes applications pour la surveillance vidéo, la vidéo en streaming l'enregistrement vidéo en salle d'opération .
Pour représenter les couleurs qui composent l'image, il existe de nombreux autres modèles. Par exemple, on peut utiliser une palette indexée, où un seul octet est nécessaire pour représenter chaque pixel, au lieu de trois requis par le modèle RGB. Dans ce modèle, on peut utiliser une matrice 2D au lieu d'une matrice 3D pour représenter chaque couleur. Cela économise de la mémoire, mais offre une gamme de couleurs plus limitée.
RGB
Prenez par exemple cette image ci-dessous. Le premier visage est entièrement coloré. Les autres sont les plans rouge, vert et bleu (l'intensité des couleurs correspondantes est montrée en niveaux de gris).
Par exemple, regardez cette image ci-dessous. Le premier visage est entièrement coloré. Les autres sont des plans rouge, vert et bleu (l'intensité des couleurs correspondantes est indiquée par une échelle de gris).
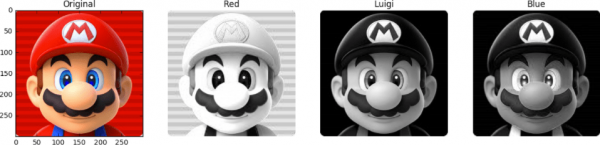
On remarque que les nuances de rouge dans l'original se situent aux mêmes endroits que les parties les plus vives du deuxième visage. Bien que la contribution de la couleur bleue ne soit principalement visible que dans les yeux de Mario (le dernier visage) et dans les éléments de ses vêtements. Notez où les trois plans de couleur apportent la moindre contribution (les parties les plus sombres des images) — ce sont les moustaches de Mario.
Pour stocker l'intensité de chaque couleur, un certain nombre de bits est nécessaire — cette mesure est appelée profondeur de couleur. Supposons que 8 bits (sur une échelle de 0 à 255) sont dépensés pour un plan de couleur. Nous avons alors une profondeur de couleur de 24 bits (8 bits * 3 plans R/G/B).
Une autre propriété de l'image est la résolution, qui représente le nombre de pixels dans une dimension. Elle est souvent indiquée comme largeur × hauteur, comme dans l'exemple d'image 4 par 4 ci-dessous.
Une autre propriété à laquelle nous faisons face lors du travail avec des images/vidéos est le rapport d'aspect, qui décrit la relation proportionnelle habituelle entre la largeur et la hauteur de l'image ou du pixel.
Lorsqu'on dit qu'un film ou une image a une taille de 16 sur 9, il s'agit généralement du rapport d'aspect de l'écran (DAR — de Display Aspect Ratio). Cependant, il peut parfois y avoir différentes formes de pixels individuels — dans ce cas, on parle de rapport de pixels (PAR — de Pixel Aspect Ratio).
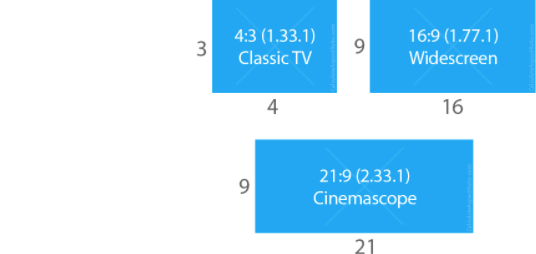
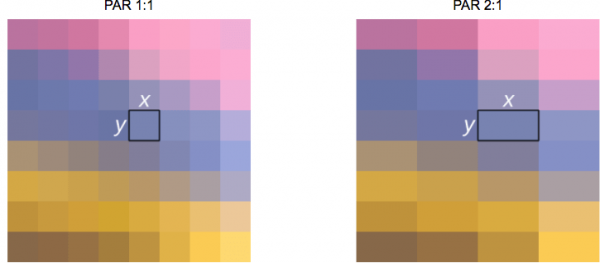
À noter pour la maîtresse de maison : DVD correspond à DAR 4 sur 3
Bien que la résolution réelle d'un DVD soit de 704×480, il conserve néanmoins un rapport d'aspect de 4:3, puisque le PAR est de 10:11 (704×10 / 480×11).
Enfin, nous pouvons définir vidéo comme une séquence de n frames sur une période de temps, qui peut être considérée comme une dimension supplémentaire. Et n alors — il s'agit de la fréquence d'images ou du nombre d'images par seconde (FPS — de Frames per Second).
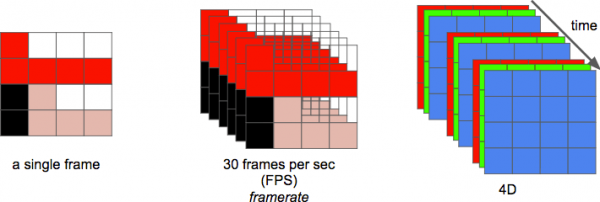
Le nombre de bits par seconde nécessaire pour afficher la vidéo est sa débit — bitrate.
bitrate = largeur * hauteur * profondeur de bits * images par seconde
Par exemple, pour une vidéo à 30 images par seconde, 24 bits par pixel, avec une résolution de 480×240, il faudra 82,944,000 bits par seconde ou 82,944 Mbit/s (30x480x240x24) — mais cela sans utiliser aucune méthode de compression.
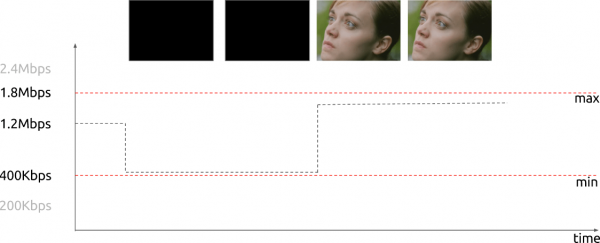
Si le débit est presque constant, on l'appelle débit constant (CBR — de constant bit rate). Mais il peut aussi varier, dans ce cas, on parle de débit variable (DBR — de débit binaire variable).
Ce graphique montre le DBR limité, où il n'est pas nécessaire de dépenser trop de bits pour une image entièrement noire.
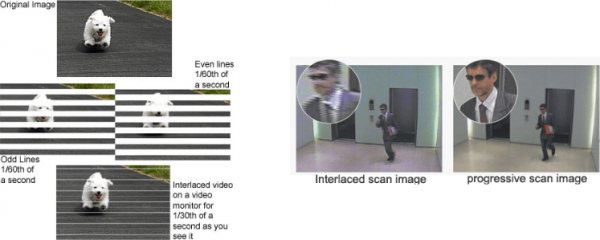
À l'origine, les ingénieurs ont développé une méthode pour doubler la fréquence d'image perçue des écrans de vidéo sans utiliser de bande passante supplémentaire. Cette méthode est connue sous le nom de vidéo entrelacée; elle envoie principalement la moitié de l'écran dans le premier « cadre », et l'autre moitié dans le suivant « cadre ».
Actuellement, la visualisation des scènes se fait principalement en utilisant la technologie de balayage progressif. Il s'agit d'une méthode d'affichage, de stockage ou de transmission d'images en mouvement, où toutes les lignes de chaque cadre sont dessinées successivement.
Eh bien ! Maintenant, nous savons comment une image est représentée numériquement, comment ses couleurs sont structurées, et combien de bits par seconde sont nécessaires pour afficher une vidéo, que le débit soit constant (CBR) ou variable (DBR). Nous connaissons la résolution spécifiée avec un taux de rafraîchissement particulier, et nous nous sommes familiarisés avec de nombreux autres termes, tels que la vidéo entrelacée, le PAR et quelques autres.
Suppression de la redondance
Il est bien connu qu'une vidéo non compressée est pratiquement inutilisable. Une vidéo d'une heure avec une résolution de 720p et 30 images par seconde occuperait 278 Go. Nous arrivons à ce chiffre en multipliant 1280 x 720 x 24 x 30 x 3600 (largeur, hauteur, bits par pixel, FPS et temps en secondes).
Utilisation algorithmes de compression sans perte, comme DEFLATE (utilisé dans PKZIP, Gzip et PNG), ne fourniront pas une réduction suffisante de la bande passante requise. Il faut donc chercher d'autres méthodes de compression vidéo.
Pour cela, nous pouvons utiliser les particularités de notre vision. Nous pouvons mieux distinguer la luminosité que les couleurs. La vidéo est un ensemble d'images successives qui se répètent dans le temps. Entre deux cadres voisins d'une même scène, les différences sont minimes. De plus, chaque cadre contient de nombreuses zones utilisant la même couleur (ou une couleur similaire).
Couleur, luminosité et nos yeux
Nos yeux sont plus sensibles à la luminosité qu'à la couleur. Vous pouvez le vérifier vous-même en regardant cette image.
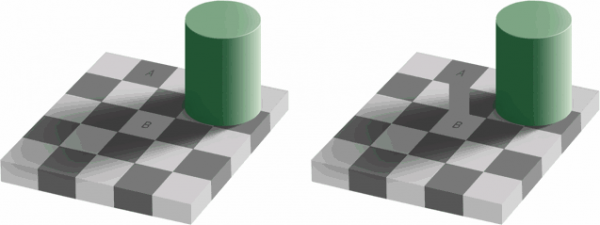
Si vous ne voyez pas ce qu'il y a dans la moitié gauche de l'image en termes de couleur des carrés A et B En réalité, s'ils sont identiques, c'est tout à fait normal. Notre cerveau nous pousse à prêter plus attention à la lumière et à l'ombre qu'à la couleur. Sur le côté droit, entre les carrés marqués, il y a une barrière de la même couleur — c'est pourquoi nous (c'est-à-dire notre cerveau) pouvons facilement déterminer qu'en réalité, il s'agit de la même couleur.
Examinons (de manière simplifiée) comment fonctionnent nos yeux. L'œil est un organe complexe composé de nombreuses parties. Cependant, ce qui nous intéresse le plus, ce sont les cônes et les bâtonnets. L'œil contient environ 120 millions de bâtonnets et 6 millions de cônes.
Considérons la perception de la couleur et de la luminosité comme des fonctions distinctes de certaines parties de l'œil (en réalité, c'est un peu plus complexe, mais nous simplifions). Les cellules de bâtonnets sont principalement responsables de la luminosité, tandis que les cellules de cônes sont responsables de la couleur. Les cônes sont classés en trois types, selon le pigment qu'ils contiennent : les cônes S (couleur bleu), les cônes M (couleur verte) et les cônes L (couleur rouge).
Puisque nous avons beaucoup plus de bâtonnets (luminosité) que de cônes (couleur), on peut conclure que nous sommes plus capables de distinguer les transitions entre l'obscurité et la lumière que les couleurs.
Fonctions de la sensibilité au contraste
Les chercheurs en psychologie expérimentale et dans de nombreux autres domaines ont développé de nombreuses théories sur la vision humaine. Et l'une d'elles est appelée fonctions de la sensibilité au contraste. Elles sont liées à l'éclairage spatial et temporel. En résumé, cela concerne le nombre de changements nécessaires avant que l'observateur ne les remarque. Notez le pluriel du mot « fonction ». Cela est dû au fait que nous pouvons mesurer les fonctions de sensibilité au contraste non seulement pour une image noir et blanc, mais aussi pour des images en couleur. Les résultats de ces expériences montrent que dans la plupart des cas, nos yeux sont plus sensibles à la luminosité qu'à la couleur.
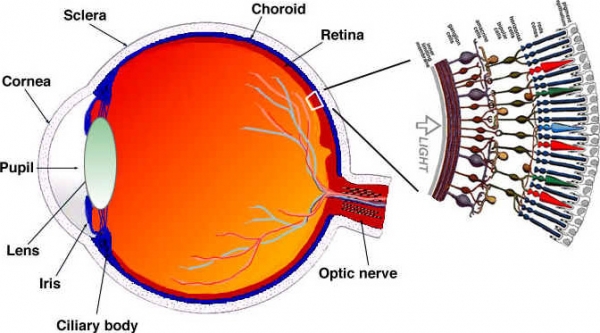
Sachant que nous sommes plus sensibles à la luminosité de l'image, nous pouvons essayer d'exploiter ce fait.
Modèle colorimétrique
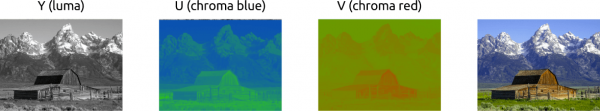
Nous avons un peu exploré comment travailler avec des images colorées en utilisant le schéma RGB. Il existe d'autres modèles. Il y a un modèle qui sépare la luminosité de la chrominance et qui est connu sous le nom de YCbCr. Au fait, il existe d'autres modèles qui effectuent une séparation similaire, mais nous n'allons examiner que celui-ci.
Dans ce modèle de couleur Y — c'est la représentation de la luminance, ainsi que deux canaux de couleur sont utilisés : Cb (bleu saturé) et Cr (rouge saturé). YCbCr peut être dérivé de RGB, tout comme il est possible de faire la conversion inverse. En utilisant ce modèle, nous pouvons créer des images en couleurs complètes, comme le montre l'exemple ci-dessous :
Conversion entre YCbCr et RGB
Certains pourraient objecter : comment est-il possible d'obtenir toutes les couleurs sans utiliser le vert ?
Pour répondre à cette question, convertissons RGB en YCbCr. Utilisons les coefficients adoptés dans la norme BT.601, qui a été recommandé par la division ITU-R. Cette division définit les normes pour la vidéo numérique. Par exemple : qu'est-ce que 4K ? Quelles doivent être la fréquence d'images, la résolution, le modèle de couleur ?
Commençons par calculer la luminance. Utilisons les constantes proposées par l'ITU et remplaçons les valeurs RGB.
Y = 0.299R + 0.587G + 0.114B
Une fois que nous avons obtenu la luminance, séparons les couleurs bleu et rouge :
Cb = 0.564(B — Y)
Cr = 0.713(R — Y)
Et nous pouvons également reconvertir et même obtenir le vert en utilisant YCbCr :
R = Y + 1.402Cr
B = Y + 1.772Cb
G = Y — 0.344Cb — 0.714Cr
En général, les affichages (moniteurs, téléviseurs, écrans, etc.) n'utilisent que le modèle RGB. Mais ce modèle peut être organisé de différentes manières :
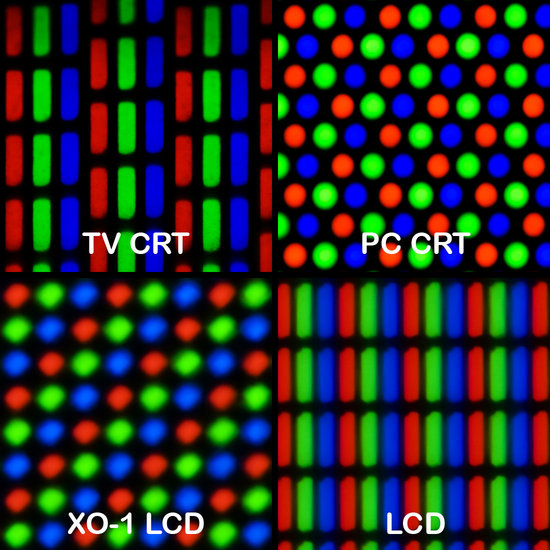
Sous-échantillonnage des couleurs
Avec l'image représentée sous la forme d'une combinaison de luminance et de chrominance, nous pouvons utiliser la plus grande sensibilité du système visuel humain à la luminance qu'à la chrominance en supprimant sélectivement des informations. Le sous-échantillonnage des couleurs est une méthode de codage d'images, utilisant une résolution plus faible pour la chrominance que pour la luminance.
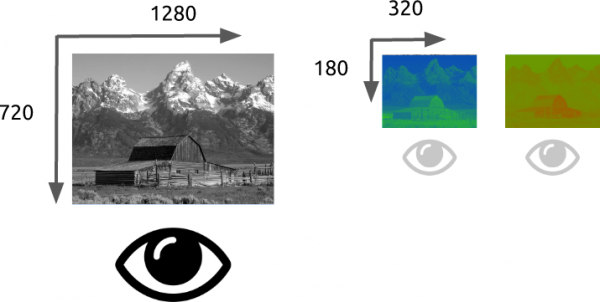
À quel point est-il acceptable de réduire la résolution de la chrominance ? Apparemment, il existe déjà certains schémas qui décrivent comment traiter la résolution et le mélange (Couleur finale = Y + Cb + Cr).
Ces schémas sont connus sous le nom de systèmes de sous-échantillonnage et exprimés sous la forme d'un rapport 3 à 1 — a:x:y, qui définit le nombre d'échantillons de luminance et de signaux de chrominance.
a — l'échantillonnage horizontal de référence (généralement égal à 4)
x — le nombre d'échantillons de chrominance dans la première ligne de pixels (résolution horizontale par rapport à a)
y — le nombre de changements d'échantillons de chrominance entre la première et la deuxième ligne de pixels.
L'exception est 4:1:0, fournissant un échantillon de chrominance dans chaque bloc de résolution de luminance de 4 sur 4.
Schémas généraux utilisés dans les codecs modernes :
- 4:4:4 (sans sous-échantillonnage)
- 4:2:2
- 4:1:1
- 4:2:0
- 4:1:0
- 3:1:1
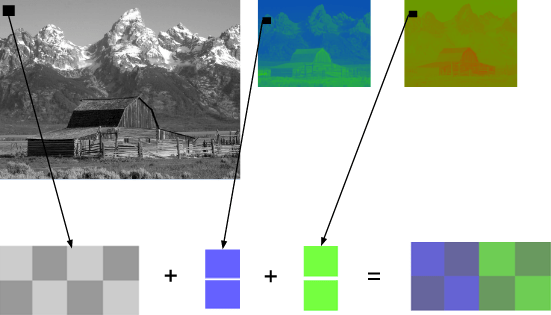
YCbCr 4:2:0 — exemple de fusion
Voici un fragment d'image fusionné en utilisant YCbCr 4:2:0. Remarquez que nous ne dépensons que 12 bits par pixel.
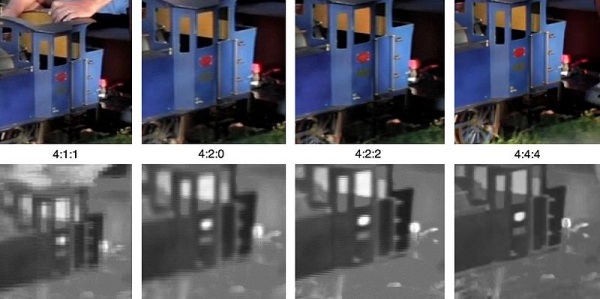
Voici à quoi ressemble la même image, encodée selon les principaux types de sous-échantillonnage chromatique. La première rangée est le YCbCr final, la rangée inférieure montre la résolution de chrominance. Des résultats assez satisfaisants, compte tenu des pertes de qualité minimes.
Rappelez-vous, nous avons estimé 278 Go d'espace disque pour stocker une vidéo d'une heure en résolution 720p à 30 images par seconde ? En utilisant YCbCr 4:2:0, cette taille sera réduite de moitié — 139 Go. Jusqu'à présent, nous sommes encore loin d'un résultat acceptable.
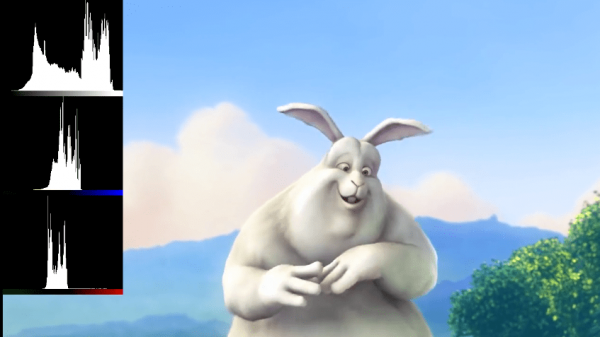
Vous pouvez obtenir vous-même l'histogramme YCbCr à l'aide de FFmpeg. Dans cette image, le bleu prédomine sur le rouge, comme le montre clairement l'histogramme.
Chrominance, luminance, gamme de couleurs — vidéo explicative
Il est recommandé de visionner cette vidéo impressionnante. Elle explique ce qu'est la luminance et clarifie le tout. à propos de la luminance et de la couleur. Types de trames
Passons à la suite. Essayons d'éliminer la redondance temporelle. Mais d'abord, définissons quelques terminologies de base. Supposons que nous avons un film avec 30 images par seconde, voici les quatre premières images :
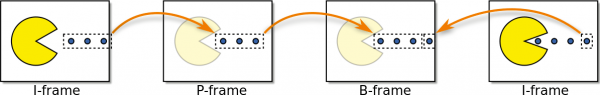
Nous pouvons voir beaucoup de répétitions dans les images : par exemple, un fond bleu qui ne change pas d'une image à l'autre. Pour résoudre ce problème, nous pouvons classifier abstraitement ces images en trois types de trames.


Trame I (
ntro Frame)ILa trame I (trame de référence, trame clé, trame interne) est autonome. Peu importe ce qu'il faut visualiser, la trame I est, en essence, une photo statique. La première trame est généralement une trame I, mais nous observerons régulièrement des trames I même parmi celles qui ne sont pas les premières.
Trame P (

Predicted Frame)La trame P (trame prédictive) utilise l'avantage du fait que l'image actuelle peut presque toujours être reproduite en utilisant la trame précédente. Par exemple, dans la deuxième image, le seul changement est la balle qui avance. Nous pouvons obtenir la trame 2 simplement en modifiant légèrement la trame 1, en utilisant uniquement la différence entre ces trames. Pour construire la trame 2, nous nous référons à la trame précédente, la trame 1.
Le P-Image (image prédictive) tire parti du fait que presque toujours l'image actuelle peut être reproduite en utilisant l'image précédente. Par exemple, dans la deuxième image, le seul changement est le ballon qui avance. Nous pouvons obtenir l'image 2 en modifiant légèrement l'image 1, en utilisant simplement la différence entre ces images. Pour construire l'image 2, nous nous référons à l'image précédente, l'image 1.
 ←

Image B (Bi-prédictif Frame)
Que diriez-vous des liens non seulement vers les images passées, mais aussi vers les images futures, afin d'assurer un meilleur compression ? C’est essentiellement ce qu’on appelle un image B (image bidirectionnelle).
 ←
 →

Sortie intermédiaire
Ces types d'images sont utilisés pour assurer la meilleure compression. Nous examinerons comment cela fonctionne dans la prochaine section. En attendant, notons que l'image la plus 'coûteuse' en mémoire est l'image I, alors que l'image P coûte beaucoup moins cher ; l'image B est en réalité la plus avantageuse pour la vidéo.
Redondance temporelle (prédiction inter-image)
Examinons les possibilités de minimiser les répétitions temporelles. Ce type de redondance sera traité au moyen de méthodes de prédiction mutuelle.
Nous allons essayer de dépenser le moins de bits possible pour encoder la séquence d'images 0 et 1.
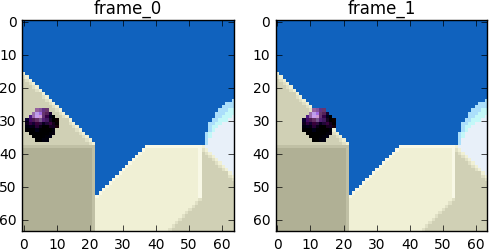
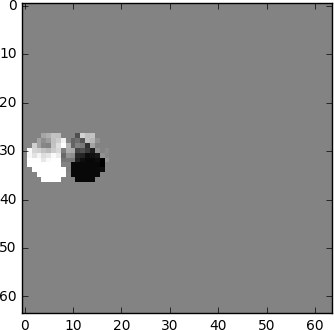
Nous pouvons procéder à la soustraction, il suffit de soustraire l'image 1 de l'image 0. Nous obtenons l'image 1 en utilisant seulement la différence entre elle et l'image précédente, en codant en fait uniquement le reste obtenu.
Mais que diriez-vous si je vous disais qu'il existe une méthode encore meilleure, qui utilise encore moins de bits ? D'abord, décomposons l'image 0 en une grille précise, composée de blocs. Ensuite, essayons de faire correspondre les blocs de l'image 0 avec ceux de l'image 1. En d'autres termes, évaluons le mouvement entre les images.
D'après Wikipédia - compensation de mouvement par blocs
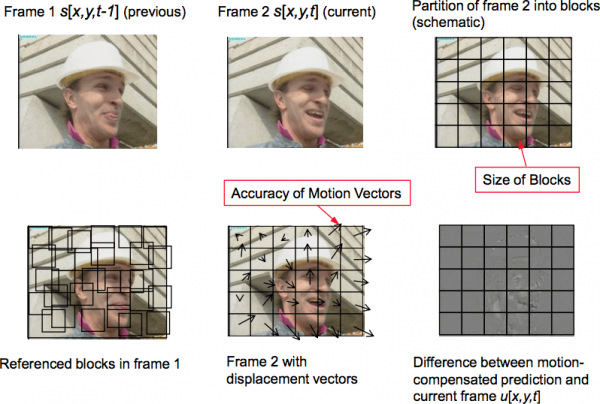
La compensation de mouvement par blocs divise l'image actuelle en blocs non se chevauchant et le vecteur de compensation de mouvement indique l'origine des blocs (une idée reçue populaire est que l'image précédente est divisée en blocs non se chevauchant, et les vecteurs de compensation de mouvement indiquent où se déplacent ces blocs. En fait, c'est l'inverse — ce n'est pas l'image précédente qui est analysée, mais la suivante, et ce n'est pas là où les blocs se déplacent, mais d'où ils proviennent). En général, les blocs d'origine se chevauchent dans l'image d'origine. Certains algorithmes de compression vidéo assemblent l'image actuelle à partir de parties de plusieurs images précédemment transmises.
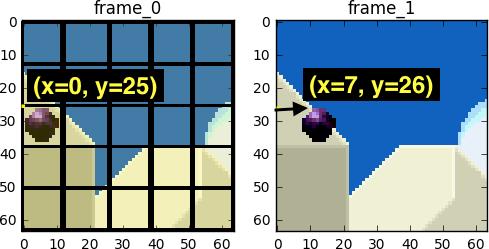
Dans le processus d'évaluation, nous voyons que la balle se déplace de (x=0, y=25) à (x=6, y=26), les valeurs x et y déterminent la direction du mouvement. Une autre étape que nous pouvons entreprendre pour préserver les bits est d'encoder uniquement la différence des vecteurs de mouvement entre la dernière position du bloc et la position prévue, donc le vecteur de mouvement final sera (x=6-0=6, y=26-25=1).
Dans une situation réelle, cette boule serait divisée en n blocs, mais cela ne change pas l'essence des choses.
Les objets dans le cadre se déplacent en trois dimensions, donc lorsque la boule se déplace, elle peut sembler visuellement plus petite (ou plus grande si elle se rapproche du spectateur). Il est normal qu'il n'y ait pas de correspondance parfaite entre les blocs. Voici une vue combinée de notre estimation et de l'image réelle.
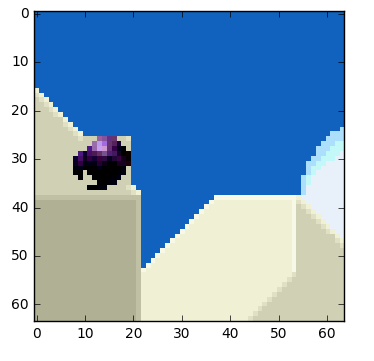
Mais nous voyons que lorsque nous appliquons une estimation de mouvement, les données à encoder sont sensiblement réduites par rapport à une méthode plus simple de calcul de la différence entre les images.
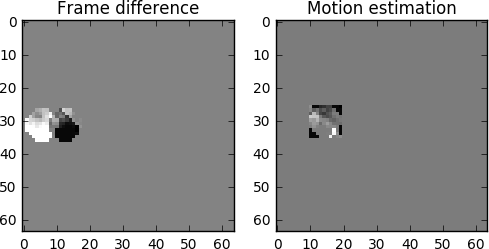
À quoi ressemblerait une véritable compensation de mouvement
Cette méthode est appliquée à tous les blocs simultanément. Souvent, notre balle en mouvement conditionnelle sera rapidement divisée en plusieurs blocs.
Vous pouvez vous-même explorer ces concepts en utilisant .
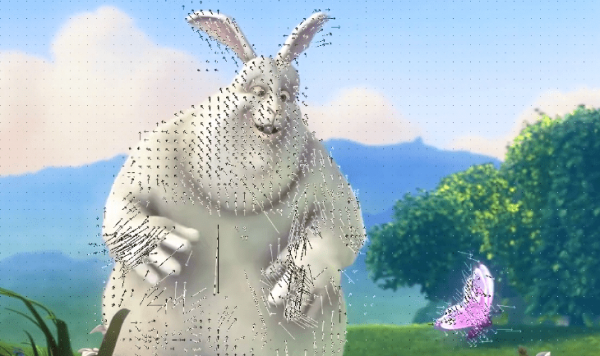
Pour voir les vecteurs de mouvement, vous pouvez créer une vidéo avec prédiction externe à l'aide de .
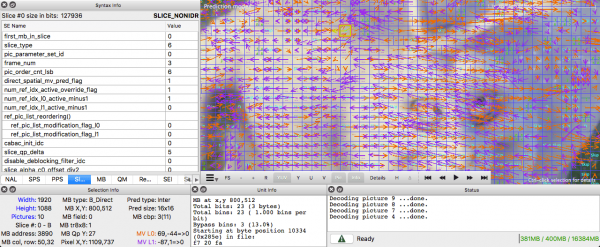
Vous pouvez également utiliser (il est payant, mais il existe une version d'essai gratuite limitée aux dix premières images).
Redondance spatiale (prévision interne)
Si nous analysons chaque image de la vidéo, nous découvrirons de nombreuses zones interconnectées.
Passons par cet exemple. Cette scène est principalement composée de couleurs bleu et blanche.
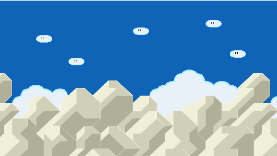
C'est un image I. Nous ne pouvons pas utiliser les images précédentes pour la prévision, mais nous pouvons le compresser. Nous allons encoder la sélection du bloc rouge. Si nous examinons ses voisins, nous remarquons qu'il y a certaines tendances de couleur autour de lui.
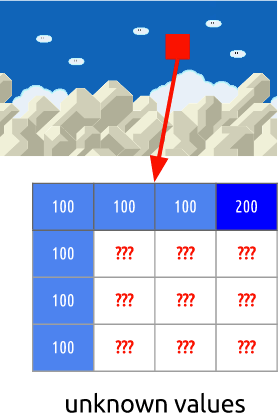
Nous supposons que dans l'image, les couleurs se propagent verticalement. Ce qui signifie que la couleur des pixels inconnus contiendra les valeurs de ses voisins.
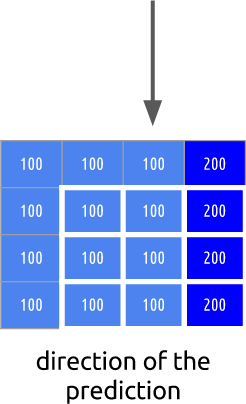
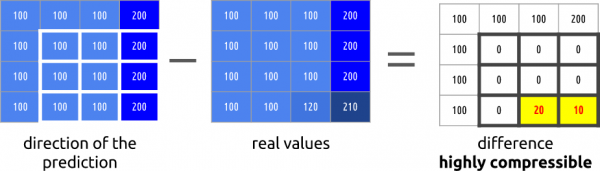
Cette prévision peut également être incorrecte. C'est pour cette raison qu'il est nécessaire d'appliquer cette méthode (prévision interne), puis de soustraire les valeurs réelles. Cela nous donnera un bloc résiduel, ce qui conduira à une matrice beaucoup plus compressée par rapport à l'original.
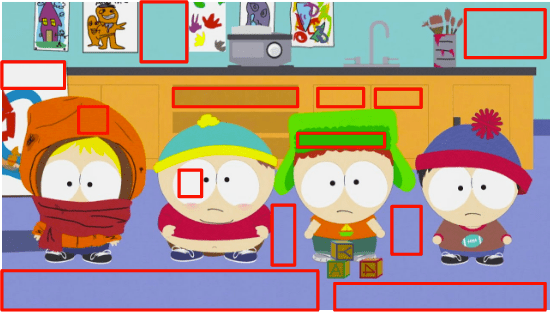
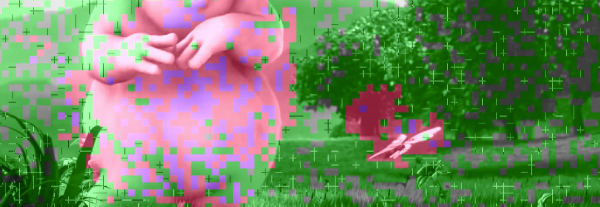
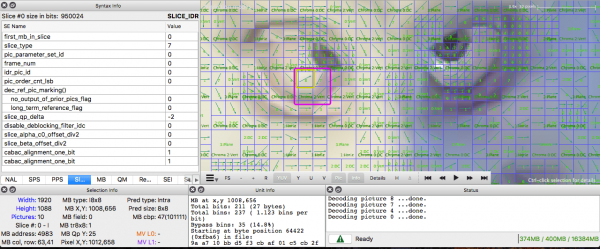
Si vous souhaitez vous exercer avec des prévisions internes, vous pouvez créer une vidéo avec des macro-blocs et leurs prévisions à l'aide de ffmpeg. Pour comprendre la signification de chaque couleur de bloc, vous devrez consulter la documentation de ffmpeg.
Ou vous pouvez utiliser Intel Video Pro Analyzer (comme je l'ai mentionné précédemment, la version d'essai gratuite est limitée aux 10 premières images, mais cela vous suffira au début).
Deuxième partie :
Source : habr.com
