

Première partie :
Quoi ? Un codec vidéo est une partie d'un logiciel matériel qui compresse et/ou décompresse des vidéos numériques.
Pourquoi ? Malgré certaines contraintes tant en bande passante qu'en capacité de stockage, le marché exige des vidéos de plus en plus de qualité. Vous vous souvenez, dans le dernier post, nous avions calculé le minimum nécessaire pour 30 fps, 24 bits par pixel, avec une résolution de 480×240 ? Cela donnait 82,944 Mbit/s non compressé. La compression est jusqu'à présent le seul moyen de transmettre des vidéos HD/FullHD/4K sur les écrans de télévision et sur Internet. Comment cela est-il réalisé ? Passons rapidement en revue les principales méthodes.
La traduction est réalisée avec le soutien de la société EDISON Software.
Nous sommes impliqués dansl'intégration de systèmes de surveillance vidéo , ainsi que .
Une erreur courante chez les débutants est de confondre un codec vidéo numérique et un conteneur vidéo numérique. Le conteneur est un format. Une enveloppe contenant des métadonnées vidéo (et peut-être audio). Une vidéo compressée peut être considérée comme une charge utile du conteneur.
Habituellement, l'extension d'un fichier vidéo indique son type de conteneur. Par exemple, un fichier video.mp4 est probablement un conteneur
MPEG-4 Part 14 , tandis qu'un fichier nommé video.mkv est probablementune matriochka. Avant de passer à ou .
Un peu d'histoire
, plongeons légèrement dans l'histoire pour mieux comprendre certains codecs anciens. Comment ?H.261
Le codec vidéo est apparu en 1990 (techniquement en 1988) et a été conçu pour fonctionner avec un débit de 64 Kbit/s. Il utilisait déjà des idées telles que la sous-échantillonnage chromatique, les blocs macro, etc. En 1995, la norme du codec vidéo H.263 a été publiée, en se développant jusqu'en 2001.En 2003, la première version
H.264/AVC a été finalisée. La même année, la société « TrueMotion » a publié son codec vidéo gratuit compressant des vidéos avec pertes appeléVP3. En 2008, Google a acheté cette société, publiantVP8 la même année. En décembre 2012, Google a lancé VP9, et il est supporté par environ ¾ du marché des navigateurs (y compris les appareils mobiles). C'est un nouveau codec vidéo gratuit et open-source développé parl'Alliance pour les médias ouverts.
AV1 — est un nouveau codec vidéo gratuit et open source, développé par l'Alliance pour les médias ouverts (AOMedia), qui comprend des entreprises emblématiques telles que : Google, Mozilla, Microsoft, Amazon, Netflix, AMD, ARM, NVidia, Intel et Cisco. La première version du codec 0.1.0 a été publiée le 7 avril 2016.
Naissance de l'AV1
Au début de 2015, Google travaillait sur VP10, Xiph (appartenant à Mozilla) travaillait sur Daala, et Cisco a développé son codec vidéo gratuit appelé Thor.
Ensuite MPEG LA a d'abord annoncé des limites annuelles pour HEVC (H.265) et des frais, huit fois plus élevés que pour H.264, mais ils ont rapidement modifié les règles :
sans limite annuelle,
des frais pour le contenu (0,5 % des revenus) et
des frais par unité de produit environ dix fois plus élevés que pour H.264.
L'Alliance pour les médias ouverts a été créée par des entreprises de divers secteurs : fabricants de matériel (Intel, AMD, ARM, Nvidia, Cisco), fournisseurs de contenu (Google, Netflix, Amazon), créateurs de navigateurs (Google, Mozilla) et d'autres.
Les entreprises avaient un objectif commun : un codec vidéo sans redevances de licence. Puis, il a été introduit AV1 avec une licence de brevet beaucoup plus simple. Timothy B. Terriberry a donné une présentation époustouflante, qui est devenue la source du concept actuel de l'AV1 et de son modèle de licence.
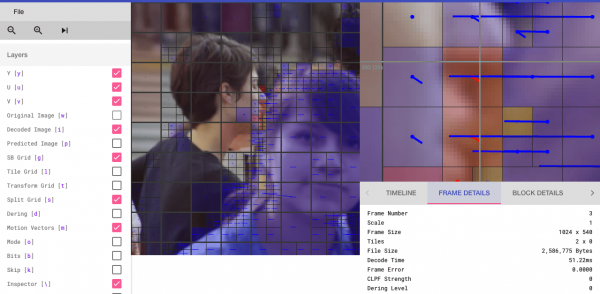
Vous serez surpris d'apprendre que l'on peut analyser le codec AV1 via un navigateur (ceux qui sont intéressés peuvent visiter).
Codec universel
Examinons les principaux mécanismes sous-jacents au codec vidéo universel. La plupart de ces concepts sont utiles et utilisés dans les codecs modernes, tels que C'est un nouveau codec vidéo gratuit et open-source développé par, AV1 et HEVC. Je préviens que beaucoup des choses expliquées seront simplifiées. Parfois, des exemples concrets seront utilisés (comme dans le cas de H.264) pour démontrer les technologies.
1ère étape - découpage de l'image
La première étape consiste à diviser le cadre en plusieurs sections, sous-sections, et ainsi de suite.
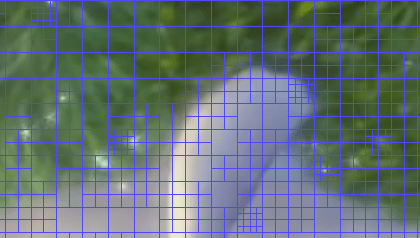
Pourquoi ? Il y a de nombreuses raisons. En divisant l'image, il est possible de prévoir plus précisément le vecteur de mouvement en utilisant de petites sections pour des parties mobiles. En revanche, pour un fond statique, il suffit souvent de sections plus grandes.
En général, les codecs organisent ces sections en segments (ou morceaux), macroblocs (ou blocs d'arbre de codage) et de nombreuses sous-sections. La taille maximale de ces sections varie, HEVC fixe 64×64, tandis qu'AVC utilise 16×16, et les sous-sections peuvent être divisées jusqu'à des tailles de 4×4.
Vous vous rappelez des types d'images de l'article précédent ? Cela peut également s'appliquer aux blocs, donc nous pouvons avoir un I-fragment, un B-bloc, un P-macrobloc, etc.
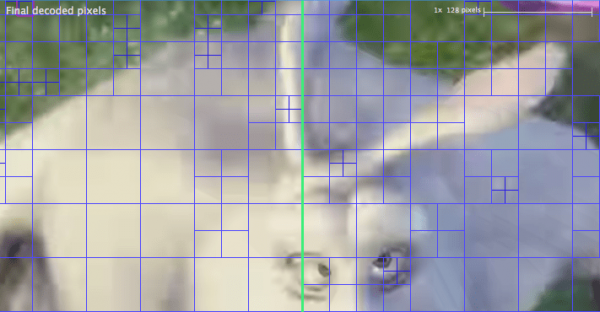
Pour ceux qui souhaitent pratiquer, regardez comment une image se divise en sections et sous-sections. Pour cela, vous pouvez utiliser ce qui a déjà été mentionné dans l'article précédent. (celui qui est payant, mais avec une version d'essai gratuite, limitée aux 10 premières images). Ici, les sections sont analysées. C'est un nouveau codec vidéo gratuit et open-source développé par:
Étape 2 - La prévision
Dès que nous avons nos sections, nous pouvons établir des prévisions astrologiques à leur sujet. Pour l'INTER-prévision il est nécessaire de transmettre les vecteurs de mouvement et le reste, tandis que pour la prévision INTRA, on transmet la direction de la prévision et le reste.
Étape 3 - La transformation
Après avoir obtenu le bloc résiduel (section prédite → section réelle), il est possible de le transformer de manière à savoir quels pixels peuvent être ignorés tout en préservant la qualité globale. Il existe certaines transformations qui offrent un comportement précis.
Bien qu'il existe d'autres méthodes, examinons plus en détail la transformation discrète du cosinus (DCT — de discrete cosine transform). Les principales fonctions de la DCT :
- Transforme les blocs de pixels en blocs de coefficients de fréquence de taille uniforme.
- Compresse la puissance, contribuant à éliminer la redondance spatiale.
- Assure l'inversibilité.
Le 2 février 2017, Cintra R.J. et Bayer F.M. ont publié un article sur la transformation semblable à la DCT pour la compression d'images, nécessitant seulement 14 additions.
Ne vous inquiétez pas si vous ne comprenez pas les avantages de chaque point. Maintenant, avec des exemples concrets, nous allons nous assurer de leur réelle valeur.
Prenons un bloc de pixels 8×8 :
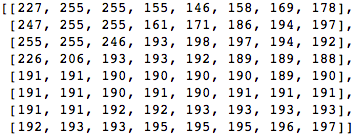
Ce bloc est rendu en l'image suivante de 8 par 8 pixels :
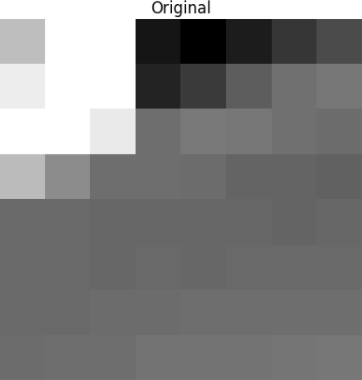
Appliquons la DCT à ce bloc de pixels et nous obtenons un bloc de coefficients de taille 8×8 :
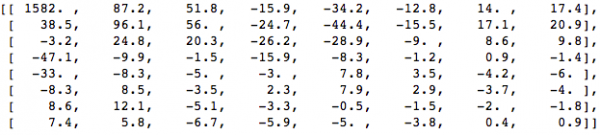
Et si nous rendons ce bloc de coefficients, nous obtenons l'image suivante :
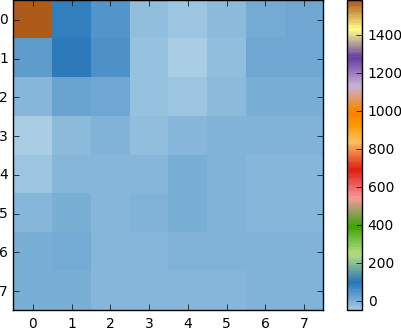
Comme nous pouvons le voir, cela ne ressemble pas à l'image originale. On peut remarquer que le premier coefficient diffère considérablement des autres. Ce premier coefficient est connu sous le nom de coefficient DC, représentant toutes les échantillons dans le tableau d'entrée, ressemblant à une valeur moyenne.
Ce bloc de coefficients a une propriété intéressante : il sépare les composants haute fréquence des composants basse fréquence.
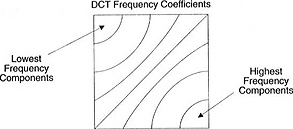
Dans l'image, la majeure partie de la puissance est concentrée sur des fréquences plus basses. Ainsi, si nous transformons l'image en ses composants fréquentiels et éliminons les coefficients de fréquence plus élevée, nous pouvons réduire la quantité de données nécessaires pour décrire l'image sans trop sacrifier la qualité.
La fréquence signifie à quelle vitesse le signal varie.
Essayons d'appliquer les connaissances acquises dans l'exemple de test en transformant l'image d'origine en sa fréquence (bloc de coefficients) en utilisant la DCT, puis en supprimant une partie des coefficients les moins importants.
Tout d'abord, transformons-le dans le domaine fréquentiel.
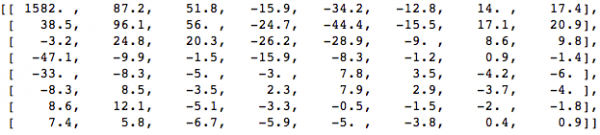
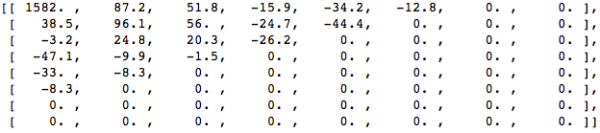
Ensuite, supprimons une partie (67 %) des coefficients, principalement dans le coin inférieur droit.
Enfin, reconstruisons l'image à partir de ce bloc de coefficients éliminé (rappelez-vous, cela doit être réversible) et comparons-la à l'original.
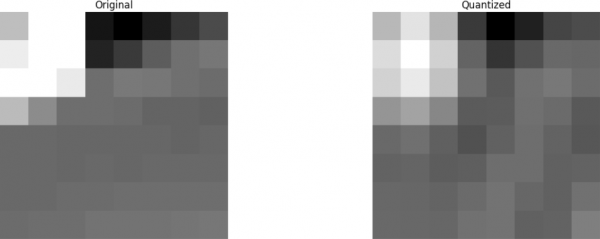
Nous voyons qu'elle ressemble à l'image d'origine, mais il y a de nombreuses différences par rapport à l'original. Nous avons éliminé 67,1875 % et avons tout de même obtenu quelque chose qui ressemble à la source d'origine. Il aurait été possible de supprimer les coefficients de manière plus réfléchie pour obtenir une image de meilleure qualité, mais cela fait déjà l'objet d'un autre sujet.
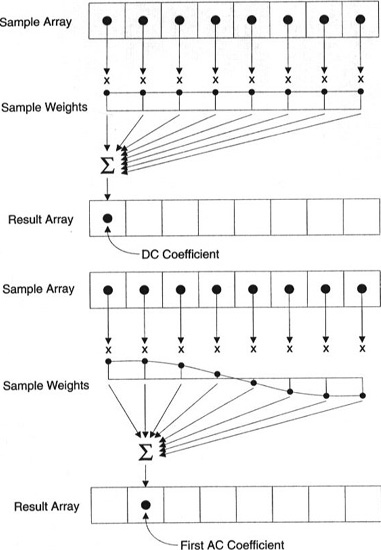
Chaque coefficient est formé en utilisant tous les pixels.
Important : chaque coefficient ne correspond pas directement à un pixel, mais représente une somme pondérée de tous les pixels. Ce graphique incroyable montre comment le premier et le deuxième coefficient sont calculés en utilisant des poids uniques pour chaque indice.
Vous pouvez également essayer de visualiser la DCT en regardant la formation d'image simple qui en découle. Par exemple, voici le symbole A, formé en utilisant chaque poids de coefficient :
Étape 4 - Quantification
Après avoir éliminé certains coefficients à l'étape précédente, à la dernière étape (transformation), nous procédons à une forme particulière de quantification. À ce stade, il est acceptable de perdre des informations. Autrement dit, nous allons quantifier les coefficients pour atteindre la compression.
Comment peut-on quantifier un bloc de coefficients ? L'une des méthodes les plus simples consiste à effectuer une quantification uniforme, où l'on prend un bloc, le divise par une valeur (par exemple 10) et arrondit le résultat.
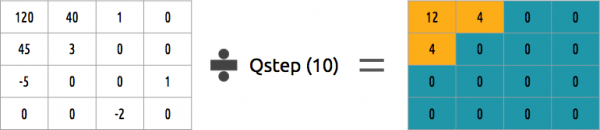
Pouvons-nous inverser ce bloc de coefficients ? Oui, nous le pouvons en multipliant par la même valeur par laquelle nous avons divisé.
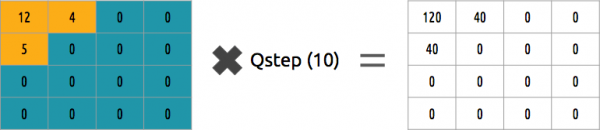
Cette approche n'est pas la meilleure, car elle ne tient pas compte de l'importance de chaque coefficient. On pourrait utiliser une matrice de quantificateurs au lieu d'une seule valeur, et cette matrice pourrait exploiter la propriété DCT, quantifiant la plupart des éléments du coin inférieur droit et une minorité des éléments du coin supérieur gauche.
Étape 5 — encodage d'entropie
Après avoir quantifié les données (blocs d'images, fragments, images), nous pouvons encore les compresser sans perte. Il existe de nombreuses méthodes algorithmiques pour la compression de données. Nous allons brièvement nous familiariser avec certaines d'entre elles, pour une compréhension plus approfondie, vous pouvez lire le livre « Understanding Compression: Data Compression for Modern Developers »»).
Encodage vidéo avec VLC
Supposons que nous avons un flux de caractères : a, e, r et t. La probabilité (entre 0 et 1) de la fréquence d'apparition de chaque caractère dans le flux est présentée dans ce tableau.
| a | e | r | t | |
|---|---|---|---|---|
| Probabilité | 0,3 | 0,3 | 0,2 | 0,2 |
Nous pouvons attribuer des codes binaires uniques (préférablement courts) aux caractères les plus probables, et des codes plus longs aux caractères moins probables.
| a | e | r | t | |
|---|---|---|---|---|
| Probabilité | 0,3 | 0,3 | 0,2 | 0,2 |
| Code binaire | 0 | 10 | 110 | 1110 |
Nous compressons le flux, en supposant que nous allons finalement dépenser 8 bits pour chaque caractère. Sans compression, chaque caractère nécessiterait 24 bits. Si chaque caractère est remplacé par son code, cela permet d'économiser de l'espace !
La première étape consiste à encoder le caractère e, qui est égal à 10, et le deuxième caractère est a, qui est ajouté (non mathématiquement) : [10] [0], et enfin, le troisième caractère t, ce qui fait que notre flux binaire final compressé est égal à [10] [0] [1110] ou encore 1001110, ce qui nécessite seulement 7 bits (3,4 fois moins d'espace que l'original).
Notez que chaque code doit être un code unique avec un préfixe. aidera à trouver ces chiffres. Bien que cette méthode ait ses défauts, il existe des codecs vidéo qui continuent à proposer cette méthode algorithmique pour la compression.
À la fois le codeur et le décodeur doivent avoir accès à la table des symboles avec leurs codes binaires. Il est donc également nécessaire d'envoyer la table dans les données d'entrée.
Codage arithmétique
Supposons que nous avons un flux de caractères : a, e, r, s et t, et leur probabilité est présentée dans ce tableau.
| a | e | r | s | t | |
|---|---|---|---|---|---|
| Probabilité | 0,3 | 0,3 | 0,15 | 0,05 | 0,2 |
Avec ce tableau, nous construirons des intervalles contenant tous les symboles possibles, triés par leur fréquence.
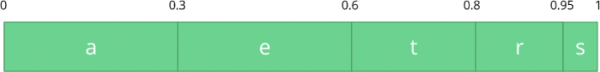
Maintenant, codons un flux de trois symboles : eat.
Nous commençons par choisir le premier symbole e, qui se situe dans l'intervalle de 0,3 à 0,6 (exclus). Prenons cet intervalle et le divisons à nouveau dans les mêmes proportions qu'auparavant, mais cette fois pour ce nouvel intervalle.
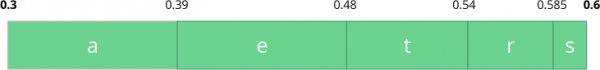
Continuons à coder notre flux eat. Maintenant, prenons le deuxième symbole a, qui se trouve dans le nouvel intervalle de 0,3 à 0,39, puis prenons notre dernier symbole t et, en répétant le même processus, nous obtenons le dernier sous-intervalle de 0,354 à 0,372.
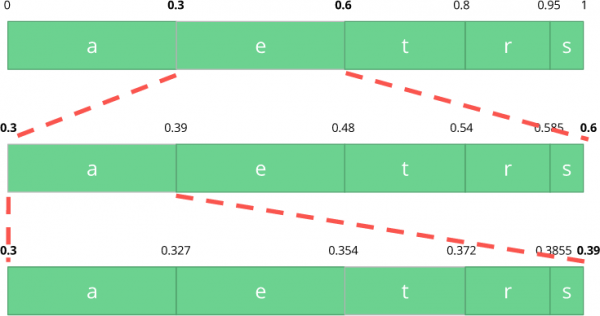
Il nous suffit de choisir un nombre dans le dernier sous-intervalle de 0,354 à 0,372. Choisissons 0,36 (mais nous pouvons choisir n'importe quel autre nombre dans cet intervalle). C'est seulement avec ce nombre que nous pourrons reconstruire notre flux d'origine. C'est comme si nous traçions une ligne à l'intérieur des intervalles pour coder notre flux.
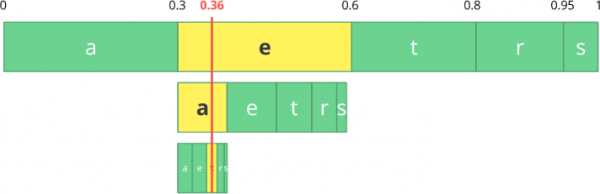
L'opération inverse (c'est-à-dire le décodage) est tout aussi simple : avec notre nombre 0,36 et notre intervalle de départ, nous pouvons lancer le même processus. Mais maintenant, en utilisant ce nombre, nous identifions le flux encodé avec ce nombre.
Avec le premier intervalle, nous remarquons que notre nombre correspond à une tranche, donc c'est notre premier symbole. Nous divisons à nouveau cet intervalle, effectuant le même processus qu'auparavant. Ici, nous pouvons remarquer que 0,36 correspond au symbole a, et après avoir répété le processus, nous arrivons au dernier symbole t (formant notre flux codé d'origine. eat).
Pour le codeur et le décodeur, il devrait y avoir une table de probabilités des symboles disponible, donc il est nécessaire d'envoyer celle-ci dans les données d'entrée.
Assez élégant, non ? Quelqu'un qui a inventé cette solution était sacrément intelligent. Certains codecs vidéo utilisent cette technique (ou, en tout cas, l'offrent comme option).
L'idée est de compresser sans perte un flux de bits quantifiés. Il manque probablement dans cet article des tonnes de détails, de raisons, de compromis, etc. Mais vous, si vous êtes développeur, devez en savoir plus. Les nouveaux codecs tentent d'utiliser différents algorithmes de codage d'entropie, tels que ANS.
Étape 6 — format du flux de bits
Après avoir fait tout cela, il reste à décompresser les images compressées dans le contexte des étapes effectuées. Il est nécessaire d'informer explicitement le décodeur des décisions prises par le codeur. Le décodeur doit disposer de toutes les informations nécessaires : profondeur de bits, espace colorimétrique, résolution, informations de prévisions (vecteurs de mouvement, prévisions INTER dirigées), profil, niveau, fréquence d'images, type de trame, numéro de trame et bien plus encore.
Nous allons faire un survol du flux de bits H.264. Notre première étape consiste à créer un flux de bits H.264 minimal (FFmpeg ajoute par défaut tous les paramètres d'encodage, tels que SEI NAL — nous découvrirons un peu plus loin ce que c'est). Nous pouvons faire cela en utilisant notre propre dépôt et FFmpeg.
./s/ffmpeg -i /files/i/minimal.png -pix_fmt yuv420p /files/v/minimal_yuv420.h264
Cette commande générera un flux de bits brut H.264 avec une image, une résolution de 64×64, avec un espace colorimétrique YUV420. L'image suivante sera utilisée comme trame.

Le flux de bits H.264
Standard AVC (H.264) définit que les informations seront envoyées dans des macroblocs (dans le sens du réseau), appelés NAL (c'est un niveau d'abstraction dans le réseau). Le principal objectif du NAL est de fournir une représentation « conviviale pour le réseau » de la vidéo. Cela devrait fonctionner sur les téléviseurs (basés sur des flux) et sur Internet (basé sur des paquets).

Il existe un marqueur de synchronisation pour déterminer les limites des éléments NAL. Chaque marqueur de synchronisation contient une valeur 0x00 0x00 0x01, excepté le tout premier, qui est égal à 0x00 0x00 0x00 0x01. Si nous exécutons hexdump pour le flux de bits H.264 généré, nous identifierons au moins trois motifs NAL au début du fichier.
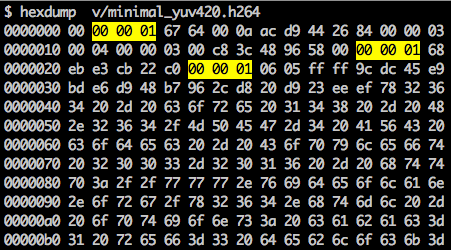
Comme déjà mentionné, le décodeur doit connaître non seulement les données de l'image, mais aussi les détails de la vidéo, du cadre, des couleurs, des paramètres utilisés et bien plus encore. Le premier octet de chaque NAL détermine sa catégorie et son type.
| Identifiant de type NAL | Description |
|---|---|
| 0 | Type inconnu |
| 1 | Fragment d'image codé sans IDR |
| 2 | Section de données codée du slice A |
| 3 | Section de données codée du slice B |
| 4 | Section de données codée du slice C |
| 5 | Fragment IDR codé de l'image IDR |
| 6 | Informations supplémentaires sur l'extension SEI |
| 7 | Ensemble de paramètres de séquence SPS |
| 8 | Ensemble de paramètres d'image PPS |
| 9 | Délimiteur d'accès |
| 10 | Fin de la séquence |
| 11 | Fin du flux |
| … | … |
Généralement, le premier NAL du flux binaire est SPS. Ce type de NAL est responsable de l'information sur les variables d'encodage communes telles que le profil, le niveau, la résolution, etc.
Si l'on saute le premier marqueur de synchronisation, nous pouvons décoder le premier octet pour savoir quel type de NAL est en premier.
Par exemple, le premier octet après le marqueur de synchronisation est égal à 01100111, où le premier bit (0) se trouve dans le champ forbidden_zero_bit. Les 2 bits suivants (11) nous indiquent le champ nal_ref_idc, qui indique si ce NAL est une référence ou non. Et les 5 bits restants (00111) nous indiquent le champ nal_unit_type, dans ce cas, c'est un bloc SPS (7) NAL.
Le deuxième octet (binaire=01100100, hex=0x64, déc=100) dans SPS NAL est le champ profile_idc, qui montre le profil utilisé par l'encodeur. Dans ce cas, un profil haute limité a été utilisé (c'est-à-dire un profil haute sans prise en charge du segment B bidirectionnel).
Si nous consultons la spécification du flux binaire H.264 pour SPS NAL, nous trouvons de nombreuses valeurs pour le nom du paramètre, la catégorie et la description. Par exemple, examinons les champs pic_width_in_mbs_minus_1 et pic_height_in_map_units_minus_1.
| Nom du paramètre | Catégorie | Description |
|---|---|---|
| pic_width_in_mbs_minus_1 | 0 | ue(v) |
| pic_height_in_map_units_minus_1 | 0 | ue(v) |
Si nous effectuons certaines opérations mathématiques avec les valeurs de ces champs, nous obtiendrons la résolution. Nous pouvons représenter 1920 x 1080 en utilisant pic_width_in_mbs_minus_1 avec la valeur 119 ((119 + 1) * macroblock_size = 120 * 16 = 1920). Encore une fois, pour économiser de l'espace, au lieu de coder 1920, nous avons fait cela avec 119.
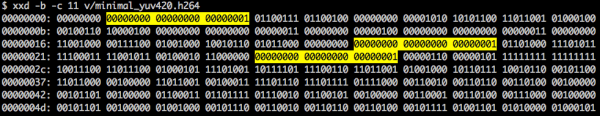
Si nous continuons à vérifier notre vidéo créée en binaire (par exemple : xxd -b -c 11 v/minimal_yuv420.h264), alors nous pouvons passer au dernier NAL, qui est lui-même le frame.

Ici, nous voyons ses 6 premiers valeurs octet : 01100101 10001000 10000100 00000000 00100001 11111111. Étant donné que l'on sait que le premier octet indique le type de NAL, dans ce cas (00101) c'est un fragment IDR (5), et ensuite on peut l'explorer davantage :
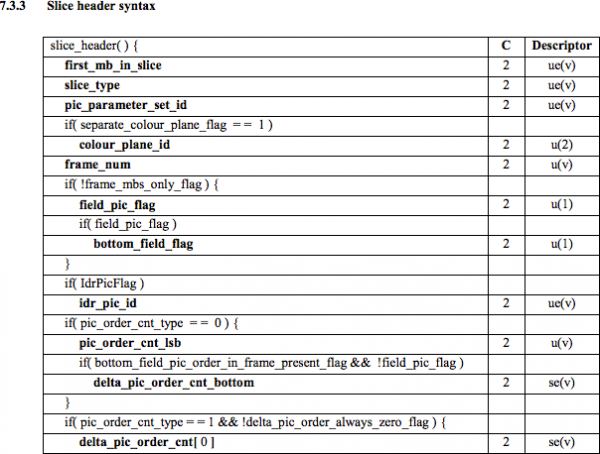
En utilisant les informations de la spécification, il est possible de décoder le type de fragment (slice_type) et le numéro de frame (frame_num) parmi d'autres champs importants.
Pour obtenir les valeurs de certains champs (ue(v), me(v), se(v) ou te(v), nous devons décoder le fragment en utilisant un décodeur spécial basé sur . Cette méthode est très efficace pour coder les valeurs des variables, surtout lorsqu'il y a beaucoup de valeurs par défaut.
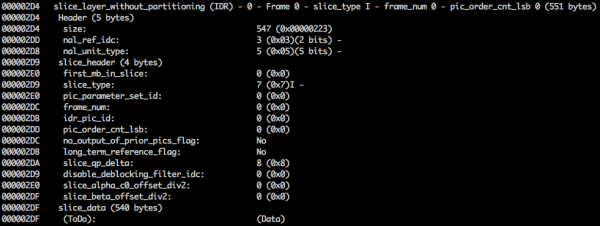
Valeurs slice_type et frame_num de cette vidéo sont égales à 7 (fragment I) et 0 (première image).
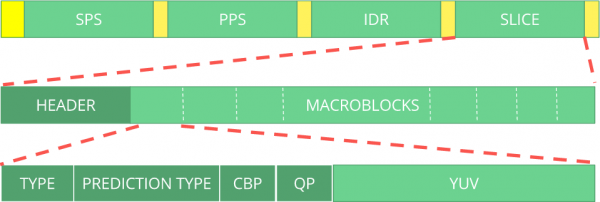
Le flux binaire peut être considéré comme un protocole. Pour en savoir plus sur le flux binaire, il convient de se référer à la spécification ITU H.264. Voici un schéma montrant où se trouvent les données de l'image (YUV en version compressée).
On peut explorer d'autres flux binaires, comme C'est un nouveau codec vidéo gratuit et open-source développé par, H.265 (HEVC) ou même notre nouveau meilleur flux binaire AV1. Sont-ils tous similaires ? Non, mais en ayant compris au moins un — il est beaucoup plus facile de comprendre les autres.
Vous voulez vous entraîner ? Explorez le flux binaire H.264
On peut générer une vidéo à une seule image et utiliser MediaInfo pour explorer le flux binaire H.264. En effet, rien n'empêche de jeter un œil au code source qui analyse le flux binaire H.264 (AVC).
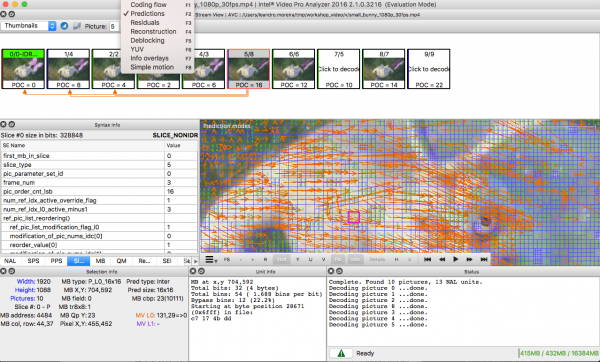
Pour la pratique, vous pouvez utiliser Intel Video Pro Analyzer (j'ai déjà mentionné que le logiciel est payant, mais qu'il existe une version d'essai gratuite, limitée à 10 images ?).
Aperçu
Notons que de nombreux codecs modernes utilisent le même modèle que celui que nous venons d'étudier. Voici, regardons le diagramme de bloc du codec vidéo Thor. Il contient toutes les étapes que nous avons suivies. Le but de cet article est que vous compreniez au moins mieux les innovations et la documentation de ce domaine.
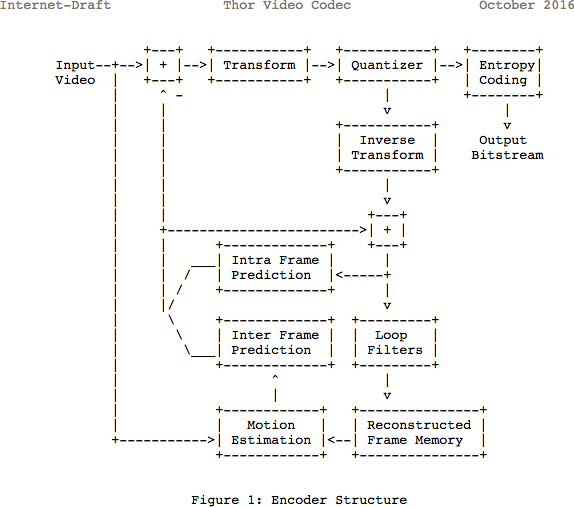
Plus tôt, nous avons estimé qu'il faudrait 139 Go d'espace disque pour stocker un fichier vidéo d'une heure à une qualité de 720p et 30 fps. Si l'on utilise les méthodes que nous avons abordées dans cet article (prévisions entre les images et internes, transformation, quantification, codage entropique, etc.), on peut obtenir (en se basant sur une dépense de 0,031 bit par pixel) une vidéo d'une qualité satisfaisante, occupant seulement 367,82 Mo, au lieu de 139 Go.
Comment H.265 atteint-il un meilleur taux de compression que H.264 ?
Maintenant que nous savons davantage sur le fonctionnement des codecs, il est plus facile de comprendre comment les nouveaux codecs peuvent permettre une résolution plus élevée avec moins de bits.
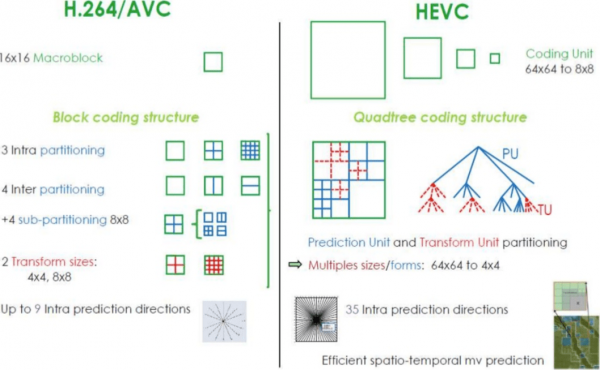
Lors de la comparaison AVC et HEVC, il ne faut pas oublier qu'il s'agit presque toujours d'un choix entre une plus grande charge pour le CPU et le taux de compression.
HEVC a plus d'options de sections (et de sous-sections) que AVC, plus de directions pour la prévision interne, un meilleur codage entropique et bien plus encore. Toutes ces améliorations ont permis de H.265 compresser 50 % de plus que H.264.
Première partie :
Source : habr.com
