

Le travail de recherche scientifique est sans doute la partie la plus intéressante de notre formation. L'idée est d'expérimenter dans le domaine choisi dès l'université. Par exemple, les étudiants en ingénierie logicielle et en apprentissage machine font souvent des recherches dans des entreprises (principalement JetBrains ou Yandex, mais pas seulement).
Dans ce post, je vais parler de mon projet en sciences informatiques. Dans le cadre de ce travail, j'ai étudié et mis en pratique des approches pour résoudre l'un des problèmes NP-difficiles les plus connus : le problème du couvercle de sommets.
Actuellement, un intérêt rapide se développe pour les problèmes NP-difficiles — les algorithmes paramétrés. Je vais essayer de vous mettre au courant, de vous parler de quelques algorithmes paramétrés simples et de décrire une méthode puissante qui m'a beaucoup aidé. J'ai présenté mes résultats au concours PACE Challenge : à la suite des tests ouverts, ma solution occupe la troisième place, et les résultats finaux seront connus le 1er juillet.
À propos de moi
Je m'appelle Vassily Alferov, je termine actuellement ma troisième année à la HSE de Saint-Pétersbourg. Je me passionne pour les algorithmes depuis mes années de lycée, lorsque j'étudiais à l'école 179 de Moscou et que je participais avec succès aux olympiades d'informatique.
Un nombre fini de spécialistes en algorithmes paramétrés entre dans un bar...
L'exemple est tiré du livre
Imaginez que vous êtes le gardien d'un bar dans une petite ville. Chaque vendredi, la moitié de la ville vient se détendre dans votre bar, ce qui vous cause pas mal de tracas : vous devez evincer les clients turbulents pour empêcher les bagarres. Finalement, cela vous ennuie, et vous décidez de prendre des mesures préventives.
Étant donné que votre ville est petite, vous savez exactement quelles paires de clients sont susceptibles de se battre s'ils sont dans le bar ensemble. Vous avez une liste de n personnes qui viendront ce soir au bar. Vous décidez de ne pas laisser entrer certains habitants de façon à ce que personne ne se batte. En même temps, votre direction ne veut pas perdre de profits et sera mécontente si vous ne laissez pas entrer plus de k personnes.
Malheureusement, le problème auquel vous êtes confronté est un problème NP-difficile classique. Vous pourriez le connaître sous le nom de , ou comme le problème du couplage de sommets. Pour de tels problèmes, il n'existe généralement pas d'algorithmes qui fonctionnent dans un délai raisonnable. Pour être précis, l'hypothèse ETH (Exponential Time Hypothesis), qui n'est pas prouvée et est assez forte, suggère que ce problème ne peut être résolu dans un temps acceptable.  , c'est-à-dire qu'il n'y a rien de notablement meilleur que la recherche exhaustive. Par exemple, supposons qu'un groupe de personnes vienne au bar n = 1000 personnes. Dans ce cas, la recherche exhaustive donnerait
 options, ce qui fait environ
 — horriblement beaucoup. Heureusement, votre direction vous a imposé une restriction k = 10, donc le nombre de combinaisons à examiner est beaucoup plus petit : le nombre des sous-ensembles de dix éléments est
 . C'est déjà mieux, mais ce n'est toujours pas faisable en une journée même sur un puissant cluster.
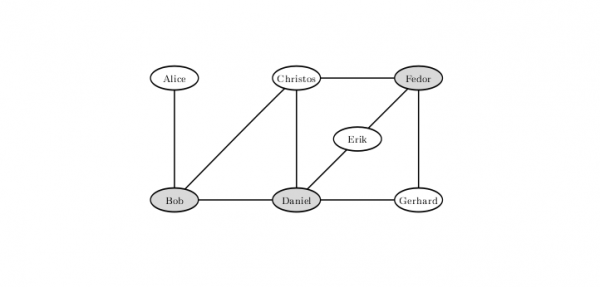
Pour éviter la probabilité de bagarres avec une telle configuration de relations tendues entre les clients du bar, il faut ne pas laisser entrer Bob, Daniel et Fiodor. Il n'existe pas de solution où seulement deux personnes sont laissées dehors.
Cela signifie-t-il qu'il est temps d'abandonner et de laisser entrer tout le monde ? Explorons d'autres options. Par exemple, on peut n'empêcher d'entrer que ceux qui pourraient se battre avec un grand nombre de personnes. Si quelqu'un peut se battre avec au moins k + 1 autres personnes, alors il ne doit pas être admis — sinon, il faudra interdire l'entrée à tous ceux k + 1 avec qui il pourrait se battre, ce qui ne manquera pas de contrarier la direction.
Supposons que vous ayez exclu toutes les personnes possibles selon ce principe. Alors, toutes les autres ne peuvent se battre avec pas plus de k personnes. En excluant k personnes, vous pouvez éviter au maximum  conflits. Cela signifie que si plus de
 personnes sont impliquées dans au moins un conflit, vous ne pourrez pas tous les empêcher. Évidemment, vous ferez entrer ceux qui ne sont pas en conflit, donc vous devez examiner tous les sous-ensembles de taille dix parmi deux cents personnes. Il y en a environ
 , et un tel nombre d'opérations peut déjà être traité sur un cluster.
S'il est possible de faire entrer des personnalités qui ne sont pas en conflit, que dire de celles qui participent à un seul conflit ? En réalité, nous pouvons également les laisser entrer, en fermant la porte à leur opposant. En effet, si Alice est en conflit seulement avec Bob, accueillir Alice parmi eux ne nous fera pas perdre : Bob peut avoir d'autres conflits et Alice, aucun. D'autant plus qu'il est insensé de ne laisser entrer aucun des deux. Après de telles opérations, il nous reste au maximum  des invités au destin indéterminé : au total, nous avons
 des conflits, chacun impliquant deux participants qui participent tous à au moins deux. Donc, il ne reste plus qu'à considérer
 des options, ce qui peut parfaitement être calculé en une demi-journée sur un ordinateur portable.
En réalité, avec des raisonnements simples, nous pouvons obtenir des conditions encore plus favorables. Notons que nous devons absolument résoudre tous les différends, c'est-à-dire choisir au moins une personne parmi chaque paire en conflit que nous ne laisserons pas entrer. Considérons l'algorithme suivant : prenons n'importe quel conflit, supprimons un participant et lançons de manière récursive sur le reste, puis supprimons l'autre et lançons aussi récursivement. Comme à chaque étape, nous éliminons quelqu'un, l'arbre de récursivité de cet algorithme est un arbre binaire de profondeur k, donc, le temps total de l'algorithme est  , où n — le nombre de sommets, et m — le nombre d'arêtes. Dans notre exemple, cela tourne autour de dix millions, ce qui peut être calculé en une fraction de seconde, non seulement sur un ordinateur portable, mais même sur un téléphone mobile.
L'exemple ci-dessus est un exemple de d'algorithme paramétré.Les algorithmes paramétrés sont des algorithmes qui fonctionnent en un temps f(k) poly(n), où p — un polynôme, où f — une fonction calculable arbitraire, et où k — un paramètre qui sera probablement beaucoup plus petit que la taille du problème.
Tous les raisonnements précédents conduisent à l'exemple de la kernelisation. — l'une des techniques communes pour créer des algorithmes paramétrés. La kernelisation consiste à réduire la taille d'un problème à une valeur limitée par une fonction d'un paramètre. Le problème résultant est souvent appelé noyau. Ainsi, par des raisonnements simples sur les puissances des sommets, nous avons obtenu un noyau quadratique pour le problème de Vertex Cover, paramétré par la taille de la réponse. Il existe d'autres paramètres qui peuvent être choisis pour ce problème (par exemple, Vertex Cover Above LP), mais nous allons discuter de ce paramètre spécifique.
Défi Pace
Compétition (Le Défi des Algorithmes Paramétrés et des Expériences Computationnelles) a été lancé en 2015 pour établir un lien entre les algorithmes paramétrés et les approches utilisées en pratique pour résoudre des problèmes computationnels. Les trois premières compétitions étaient consacrées à la recherche de la largeur d'une arbre de graphe (), à la recherche de l'arbre de Steiner () et à la recherche d'un ensemble de sommets coupant les cycles (). Cette année, l'un des problèmes dans lequel il était possible de tenter sa chance était le problème de couverture de sommets décrit ci-dessus.
La compétition gagne en popularité chaque année. Si l'on en croit les données préliminaires, cette année, 24 équipes ont participé à la compétition sur le problème de couverture de sommets. Il convient de noter que la compétition ne dure pas quelques heures et même pas une semaine, mais plusieurs mois. Les équipes ont la possibilité d'étudier la littérature, de concevoir leur propre idée originale et d'essayer de la mettre en œuvre. En substance, cette compétition représente un travail de recherche. Les idées des solutions les plus efficaces et la remise des prix aux vainqueurs se dérouleront conjointement avec la conférence (Symposium International sur la Programmation Paramétrée et Exacte) dans le cadre de la plus grande assemblée algorithmique annuelle en Europe . Pour plus d'informations sur la compétition elle-même, vous pouvez consulter , et les résultats des années précédentes sont disponibles .
Schéma de solution
Pour résoudre le problème de couverture de sommets, j'ai tenté d'appliquer des algorithmes paramétrés. Ceux-ci se composent généralement de deux parties : des règles de simplification (qui, idéalement, mènent à la kernelisation) et des règles de fractionnement. Les règles de simplification consistent en un prétraitement de l'entrée en temps polynomial. L'objectif de l'application de telles règles est de réduire le problème à un problème équivalent de taille plus petite. Les règles de simplification représentent la partie la plus coûteuse de l'algorithme, et l'application de cette partie conduit à un temps d'exécution global.  au lieu d'un simple temps polynomial. Dans notre cas, les règles de fractionnement reposent sur le fait que pour chaque sommet, il faut choisir soit lui, soit son voisin en réponse.
Le schéma général est le suivant : nous appliquons les règles de simplification, puis choisissons un sommet, et effectuons deux appels récursifs : dans le premier, nous le prenons en compte, et dans l'autre, nous prenons tous ses voisins. Nous appelons cela se fractionner (brancher) à partir de ce sommet.
Il y aura exactement un ajout à ce schéma dans le paragraphe suivant.
Idées pour les règles de fractionnement (branching)
Discutons de la manière de choisir le sommet sur lequel se fera le fractionnement.
L'idée principale est très gourmande du point de vue algorithmique : prenons le sommet de degré maximal et fractionnons-nous précisément à partir de celui-ci. Pourquoi semble-t-il que cela soit mieux ? Parce que dans la deuxième branche de l'appel récursif, nous éliminons ainsi beaucoup de sommets. On peut s'attendre à ce qu'il reste un petit graphe sur lequel nous travaillerons rapidement.
Cette approche, avec les techniques simples de kernelisation déjà discutées, montre des résultats plutôt satisfaisants, résolvant certains tests de plusieurs milliers de sommets. Mais, par exemple, elle fonctionne mal pour les graphes cubiques (c'est-à-dire les graphes dans lesquels le degré de chaque sommet est égal à trois).
Il y a encore une idée, basée sur une pensée assez simple : si le graphe est déconnecté, le problème sur ses composants de connexité peut être résolu indépendamment, en réunissant les réponses à la fin. C'est d'ailleurs la petite modification promise dans le schéma qui accélérera considérablement la solution : auparavant, dans ce cas, nous travaillions avec le produit des temps de calcul des réponses des composants, alors qu'à présent, nous travaillons avec la somme. Pour accélérer le fractionnement, il faut transformer un graphe connecté en déconnecté.
Comment faire cela ? Si le graphe a un point d'articulation, il faut le fragmenter exactement à ce point. Un point d'articulation est un sommet dont la suppression rend le graphe non connexe. On peut trouver tous les points d'articulation dans un graphe avec un algorithme classique en temps linéaire. Cette approche accélère considérablement le processus de fragmentation.
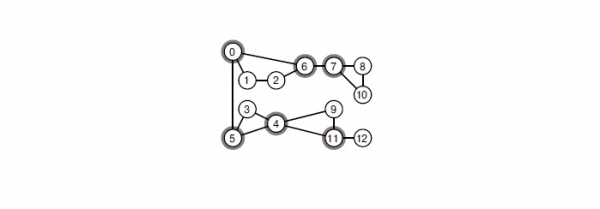
Lors de la suppression de l'un des sommets marqués, le graphe se divisera en composants connexes.
Nous allons le faire, mais nous voulons plus. Par exemple, rechercher dans le graphe de petites coupures de sommets et réaliser des fragmentations à partir de celles-ci. La méthode la plus efficace que je connaisse pour trouver la coupure minimale globale de sommets consiste à utiliser l'arbre de Gomory-Hu, qui se construit en temps cubique. Dans le PACE Challenge, la taille typique d'un graphe est de plusieurs milliers de sommets. Dans un tel scénario, chaque sommet de l'arbre de récursion doit exécuter des milliards d'opérations. Il s'avère donc qu'il est simplement impossible de résoudre la tâche dans le temps imparti.
Essayons d'optimiser la solution. La coupure minimale entre une paire de sommets peut être trouvée par n'importe quel algorithme construisant un flux maximal. On peut appliquer sur un tel réseau , qui, en pratique, fonctionne très rapidement. J'ai le soupçon qu'on peut théoriquement prouver une estimation sur le temps d'exécution  , ce qui est déjà tout à fait acceptable.
J'ai essayé plusieurs fois de rechercher des coupures entre des paires de sommets aléatoires et de choisir la plus équilibrée. Malheureusement, cela a donné de mauvais résultats lors des tests ouverts du PACE Challenge. J'ai comparé cela avec un algorithme se fragmentant sur les sommets de degré maximal, en le lançant avec une limitation sur la profondeur de descente. Après l'algorithme essayant de trouver une coupure de cette manière, il restait des graphes de plus grande taille. Cela est dû au fait que les coupures étaient très déséquilibrées : en supprimant 5-10 sommets, on n'arrivait qu'à détacher seulement 15-20.
Il convient de noter que dans les articles sur les algorithmes théoriquement les plus rapides, des techniques de choix de sommets pour la fragmentation beaucoup plus avancées sont utilisées. Ces techniques ont une mise en œuvre très complexe et souvent de mauvaises estimations en temps et en mémoire. Je n'ai pas réussi à en extraire de vraiment acceptables pour la pratique.
Comment appliquer les règles de simplification
Nous avons déjà des idées de kernelisation. Je me souviens :
- S'il y a un sommet isolé, il faut le supprimer.
- Si une arête de degré 1 existe, la supprimer et prendre son voisin en réponse.
- Si une arête de degré au moins k + 1, la prendre en réponse.
Pour les deux premiers, tout est clair, mais pour le troisième, il y a une astuce. Si dans le problème humoristique sur le bar, nous avions une limite supérieure sur k, dans le PACE Challenge, il faut simplement trouver un couplage de sommets de taille minimale. C'est une transformation typique de problèmes de recherche (Search Problem) en problèmes de décision (Decision Problem), souvent, on ne fait pas de distinction entre les deux types de problèmes. En pratique, si nous écrivons un solveur pour le problème du couplage des sommets, la différence peut exister. Par exemple, comme dans le troisième point.
D'un point de vue mise en œuvre, il existe deux approches. La première approche s'appelle l'Approfondissement itératif. Elle consiste à commencer à partir d'une certaine limite inférieure raisonnable sur la réponse, puis à lancer notre algorithme en utilisant cette limite comme une limite supérieure sur la réponse, sans descendre en récursivité au-dessous de cette limite. Si nous avons trouvé une réponse, elle est garantie optimale ; sinon, nous pouvons augmenter cette limite d'une unité et relancer.
L'autre approche consiste à conserver une certaine réponse optimale actuelle et à chercher une réponse de taille inférieure, en modifiant ce paramètre lors de la découverte. k pour couper davantage les branches superflues dans la recherche.
Après quelques expériences nocturnes, je me suis arrêté sur une combinaison de ces deux méthodes : d'abord, je lance mon algorithme avec une certaine profondeur de recherche (en choisissant pour qu'elle prenne un temps négligeable par rapport à la solution principale) et j'utilise la meilleure solution trouvée comme limite supérieure sur la réponse — c'est-à-dire sur ce fameux k.
Sommets de degré 2
Nous avons compris les sommets de degré 0 et 1. Il s'avère que cela peut également être fait avec les sommets de degré 2, mais cela nécessitera des opérations plus complexes sur le graphe.
Pour l'expliquer, il faut d'une certaine manière désigner les sommets. Appelons un sommet de degré 2 un sommet v, et ses voisins - des sommets x et y. Ensuite, nous aurons deux cas.
- Lorsque x et y — voisins. Alors nous pouvons prendre en réponse x et y, et v supprimer. Et en effet, dans ce triangle, il faut prendre au moins deux sommets en réponse et nous ne perdrons pas, si nous prenons x et y: ils ont probablement encore des voisins, mais v eux n'en ont pas.
- Lorsque x et y — pas des voisins. Il est alors affirmé que les trois sommets peuvent être fusionnés en un seul. L'idée est que dans ce cas, il existe une réponse optimale, où nous prendrons soit v, soit les deux sommets x et y. Dans le premier cas, nous devrons inclure tous les voisins dans la réponse x et y, tandis que dans le second, ce n'est pas nécessaire. Cela correspond exactement aux cas où nous ne prenons pas le sommet fusionné dans la réponse et lorsque nous le prenons. Il reste à noter que dans les deux cas, la réponse de cette opération diminue d'une unité.
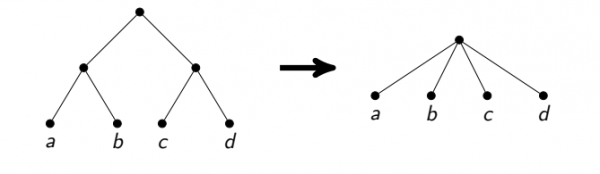
Il convient de noter qu'une telle approche est assez difficile à mettre en œuvre avec précision en temps linéaire. La fusion des sommets est une opération complexe, il faut copier les listes de voisins. Si cela n'est pas fait avec soin, on peut obtenir un temps de fonctionnement asymptotiquement sous-optimal (par exemple, si après chaque fusion, beaucoup d'arêtes sont copiées). Je me suis concentré sur la recherche de chemins entiers à partir de sommets de degré 2 et sur l'analyse de nombreux cas particuliers, tels que les cycles à partir de ces sommets ou à partir de tous les sommets sauf un.
De plus, cette opération doit être réversible, afin qu'à la sortie de la récursivité, nous puissions restaurer le graphe dans son état d'origine. Pour garantir cela, je n'ai pas vidé les listes d'arêtes des sommets fusionnés, après quoi je savais simplement quelles arêtes devaient être orientées où. Une telle implémentation des graphes nécessite également de la rigueur, mais offre un temps linéaire honnête. Et pour les graphes de plusieurs dizaines de milliers d'arêtes, cela tient parfaitement dans le cache du processeur, ce qui procure de grands avantages en vitesse.
Noyau linéaire
Enfin, la partie la plus intéressante du noyau.
Tout d'abord, rappelons qu'il est possible de chercher un couvercle minimum de sommets dans des graphes bipartis en  . Pour cela, il faut utiliser l'algorithme pour trouver le maximum appariement, puis utiliser le théorème .
L'idée du noyau linéaire est la suivante : d'abord, nous allons bifurquer le graphe, c'est-à-dire qu'au lieu de chaque sommet v , nous allons créer deux sommets  et
 , et pour chaque arête u — v , nous allons créer deux arêtes.
 et
 . Le graphe obtenu sera bipartite. Trouvons-y un couvercle de sommets minimum. Certaines sommets du graphe d'origine figureront là deux fois, certaines une seule fois, et certaines — jamais. Le théorème de Nemhauser-Trotter affirme que dans ce cas, il est possible de supprimer les sommets qui n'y figurent jamais et de prendre en réponse ceux qui apparaissent deux fois. De plus, il dit que parmi les sommets restants (ceux qui apparaissent une fois), il faut en prendre au moins la moitié en réponse.
Nous venons d'apprendre à laisser dans le graphe pas plus que 2k sommets. Et en effet, si dans le reste de la réponse — au moins la moitié de tous les sommets, alors en tout, il n'y a pas plus de sommets que 2k.
Ici, j'ai réussi à faire un petit pas en avant. Il est clair que le noyau construit de cette manière dépend de quel couvercle de sommets minimum dans le graphe bipartite nous avons pris. On souhaite en choisir un de sorte que le nombre de sommets restants soit minimal. Auparavant, cela n'était possible que dans un temps  . J'ai cependant élaboré une implémentation de cet algorithme en un temps
 , ce qui permet de chercher ce noyau sur des graphes de plusieurs centaines de milliers de sommets à chaque étape de la branche.
Résultat
La pratique montre que ma solution fonctionne bien sur des tests de plusieurs centaines de sommets et plusieurs milliers d'arêtes. Lors de tels tests, on peut raisonnablement s'attendre à ce qu'une solution soit trouvée en une demi-heure. La probabilité de trouver une réponse dans un temps acceptable augmente en principe si le graphe contient suffisamment de sommets de haute degré, par exemple un degré de 10 et plus.
Pour participer à la compétition, les solutions devaient être soumises sur . D'après le tableau qui y est présenté, Les résultats des tests fermés seront connus le premier juillet.
La recherche scientifique est sans doute la partie la plus intéressante de notre formation. L'idée est d'essayer, dès l'université, de se lancer dans la direction choisie.
Source : habr.com
