

L'article de l'équipe Stitch Fix propose d'utiliser l'approche des essais cliniques de non-infériorité dans les tests A/B marketing et produit. Cette approche est effectivement applicable lorsque nous testons une nouvelle solution qui présente des avantages non mesurables par les tests.
Le meilleur exemple est la réduction des coûts. Par exemple, nous automatisons le processus de réservation de la première leçon, mais nous ne voulons pas trop affecter le taux de conversion global. Ou nous testons des modifications ciblées sur un segment d'utilisateurs, tout en veillant à ce que les conversions des autres segments ne baissent pas trop (lors de tests de plusieurs hypothèses, n'oublions pas les ajustements).
Choisir la bonne borne de non-infériorité ajoute des difficultés supplémentaires lors de la conception du test. La question de la sélection de Δ n'est pas très bien abordée dans l'article. Il semble que ce choix ne soit pas complètement transparent, même dans les essais cliniques. Les publications médicales sur la non-infériorité rapportent que dans seulement la moitié des publications, le choix de la borne est justifié, et souvent ces justifications sont ambiguës ou peu détaillées.
Dans tous les cas, cette approche semble intéressante, car en réduisant la taille d'échantillon nécessaire, elle peut augmenter la rapidité des tests, et donc la vitesse de prise de décision. — Darya Mukhina, analyste produit de l'application mobile Skyeng.
L'équipe Stitch Fix aime tester différentes choses. En général, toute la communauté technologique aime réaliser des tests. Quelle version du site attire le plus d'utilisateurs – A ou B ? La version A du modèle recommandation génère-t-elle plus de revenus que la version B ? Presque toujours, pour vérifier les hypothèses, nous utilisons l'approche la plus simple du cours de statistique de base :
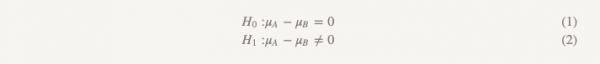
Bien que nous utilisions rarement ce terme, cette forme de test est appelée « test d'hypothèse de supériorité ». Avec cette approche, nous supposons qu'il n'y a aucune différence entre les deux options. Nous restons attachés à cette idée et n'abandonnons que si les données obtenues s'avèrent suffisamment convaincantes pour cela – c'est-à-dire démontrent qu'une des options (A ou B) est meilleure que l'autre.
La vérification de l'hypothèse de supériorité est adaptée à la résolution de nombreux problèmes. Nous ne publions une version B du modèle de recommandation que si elle est manifestement meilleure que la version A actuellement utilisée. Mais dans certains cas, cette approche ne fonctionne pas aussi bien. Examinons quelques exemples.
1) Nous utilisons un service tiers, qui aide à identifier les cartes bancaires contrefaites. Nous avons trouvé un autre service, qui coûte beaucoup moins cher. Si le service moins cher fonctionne aussi bien que celui que nous utilisons actuellement, nous le choisirons. Il n'est pas nécessaire qu'il soit meilleur que le service utilisé.
2) Nous souhaitons abandonner la source de données A et la remplacer par la source de données B. Nous pourrions envisager de retarder l'abandon de A si B produit des résultats très mauvais, mais continuer à utiliser A n'est pas une option viable.
3) Nous aimerions passer de l'approche de modélisationA à l'approche B, non pas parce que nous attendons de meilleurs résultats de B, mais parce que cela nous donne une plus grande flexibilité opérationnelle. Nous n'avons pas de raisons de croire que B sera pire, mais nous ne procéderons pas au changement si tel est le cas.
4) Nous avons apporté plusieurs améliorations qualitatives au design du site web (version B) et nous considérons que cette version est supérieure à la version A. Nous ne nous attendons pas à des changements dans le taux de conversion ou dans les indicateurs clés de performance que nous utilisons habituellement pour évaluer le site. Mais nous pensons qu'il y a des avantages en termes de paramètres qui sont soit inestimables, soit pour lesquels notre technologie n'est pas suffisante pour mesurer.
Dans tous ces cas, l'étude de la supériorité n'est pas la solution la plus appropriée. Mais la plupart des spécialistes l'utilisent par défaut dans de telles situations. Nous menons une expérience rigoureuse pour déterminer correctement la magnitude de l'effet. Si les versions A et B fonctionnent de manière très similaire, il est probable que nous ne parviendrons pas à rejeter l'hypothèse nulle. Tirons-nous la conclusion que A et B fonctionnent globalement de la même manière ? Non ! L'incapacité à rejeter l'hypothèse nulle et l'acceptation de l'hypothèse nulle ne sont pas la même chose.
Les calculs de la taille de l'échantillon que vous avez, bien sûr, effectués, sont généralement réalisés avec des limites plus strictes pour l'erreur de premier type (la probabilité de rejeter à tort l'hypothèse nulle, souvent appelée alpha), que pour l'erreur de second type (la probabilité de ne pas rejeter l'hypothèse nulle, étant donné que l'hypothèse nulle est fausse, souvent appelée bêta). Une valeur typique pour alpha est de 0,05, tandis qu'une valeur typique pour bêta est de 0,20, ce qui correspond à une puissance statistique de 0,80. Cela signifie que nous pouvons ne pas détecter l'effet réel de l'ampleur que nous avons indiquée dans nos calculs de puissance avec une probabilité de 20 %, et c'est un manque d'information assez sérieux. Prenons comme exemple les hypothèses suivantes :
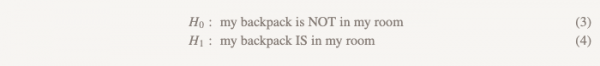
H0 : mon sac à dos n'est PAS dans ma chambre (3)
H1 : mon sac à dos est dans ma chambre (4)
Si j'ai fouillé ma chambre et trouvé mon sac à dos, super, je peux rejeter l'hypothèse nulle. Mais si j'ai regardé dans la chambre et n'ai pas pu trouver mon sac à dos (figure 1), quelle conclusion dois-je tirer ? Suis-je certain qu'il n'y est pas ? Ai-je cherché suffisamment soigneusement ? Et si je n'avais regardé que 80 % de la chambre ? Tirer la conclusion que le sac à dos n'est certainement pas dans la chambre serait une décision imprudente. Il n'est donc pas surprenant que nous ne puissions pas « accepter l'hypothèse nulle ».
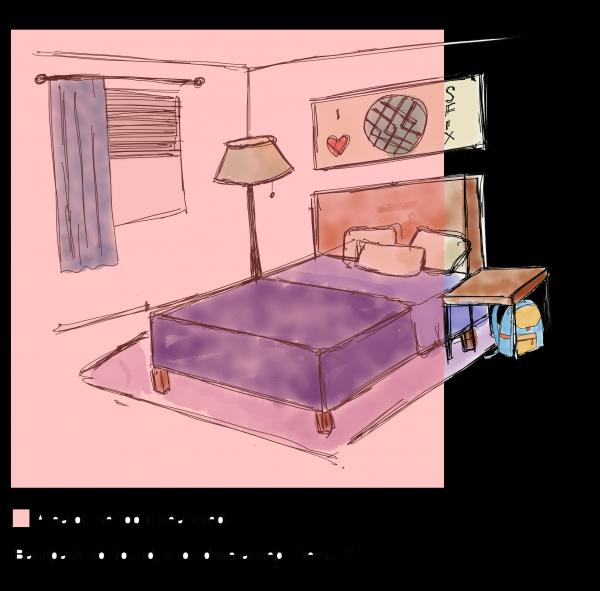
La zone que nous avons fouillée
Nous n'avons pas trouvé de sac à dos - devons-nous accepter l'hypothèse nulle ?
Figure 1. Fouiller 80 % de la chambre revient à mener une étude avec une puissance de 80 %. Si vous n'avez pas trouvé de sac à dos en examinant 80 % de la chambre, peut-on conclure qu'il n'y en a pas ?
Que doit donc faire un spécialiste des données dans cette situation ? Vous pouvez augmenter considérablement la puissance de l'étude, mais alors vous aurez besoin d'un échantillon beaucoup plus grand, et le résultat sera quand même insatisfaisant.
Heureusement, ces problèmes sont bien étudiés dans le monde des recherches cliniques. Le médicament B est moins cher que le médicament A ; on s'attend à ce que le médicament B provoque moins d'effets secondaires que le médicament A ; le médicament B est plus facile à transporter car il n'a pas besoin d'être réfrigéré, contrairement au médicament A. Vérifions l'hypothèse de l'efficacité non inférieure. Cela est nécessaire pour démontrer que la version B est tout aussi bonne que la version A — du moins dans une certaine limite prédéterminée de « non-infériorité », Δ. Plus tard, nous parlerons en détail de la façon de fixer cette limite. Mais pour le moment, supposons qu'il s'agit de la différence minimale, qui est pratiquement significative (dans le contexte des essais cliniques, cela s'appelle généralement la signification clinique).
Les hypothèses de non-infériorité renversent tout :
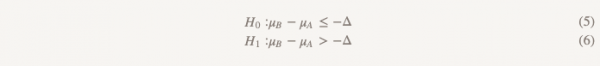
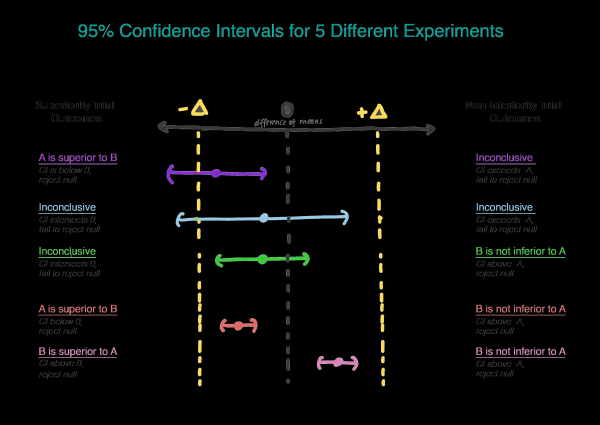
Maintenant, au lieu de supposer qu'il n'y a pas de différence, nous supposons que la version B est inférieure à la version A, et nous en resterons à cette hypothèse tant que nous ne prouverons pas le contraire. C'est précisément à ce moment-là qu'il est pertinent d'utiliser un test d'hypothèse unilatérale ! En pratique, cela peut être fait en construisant un intervalle de confiance et en déterminant si cet intervalle est vraiment supérieur à Δ (figure 2).
Choix de Δ
Comment bien choisir Δ ? Le processus de choix de Δ implique une justification statistique et une évaluation substantielle. Dans le monde des recherches cliniques, il existe des recommandations réglementaires qui stipulent que delta doit représenter la plus petite différence cliniquement significative — celle qui aura de l'importance en pratique. Voici une citation des directives européennes que vous pouvez utiliser pour vous auto-vérifier : « Si la différence a été choisie correctement, l'intervalle de confiance qui est entièrement compris entre –∆ et 0..., reste suffisant pour démontrer la non-infériorité. Si ce résultat ne semble pas acceptable, cela signifie que ∆ n'a pas été choisi de manière appropriée ».
Le delta ne doit certainement pas dépasser l'effet de la version A par rapport au vrai contrôle (placebo / absence de traitement), car cela nous amène à la conclusion que la version B est inférieure au vrai contrôle tout en montrant une « efficacité non inférieure ». Supposons qu'au moment de l'introduction de la version A, il y avait la version 0 ou que la fonction n'existait pas du tout (voir figure 3).
D'après les résultats du test d'hypothèse de supériorité, l'effet E a été identifié (c'est-à-dire supposément μ^A−μ^0=E). Maintenant, A est notre nouvelle référence, et nous voulons nous assurer que B n'est pas inférieur à A. Une autre façon d'écrire μB−μA≤−Δ (hypothèse nulle) est μB≤μA−Δ. Si nous supposons que faire est égal ou supérieur à E, alors μB ≤ μA−E ≤ placebo. Nous voyons maintenant que notre estimation pour μB dépasse complètement μA−E, ce qui réfute complètement l'hypothèse nulle et permet de conclure que B n'est pas inférieur à A, mais en même temps μB peut être ≤ μ placebo, ce qui n'est pas ce que nous recherchons. (figure 3).
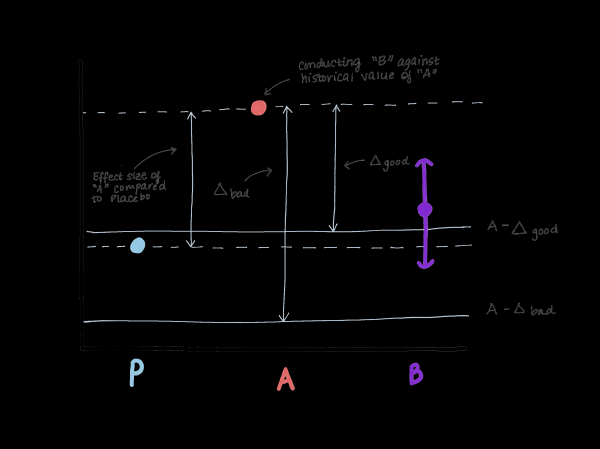
Figure 3. Illustration des risques liés au choix d'une limite d'efficacité non inférieure. Si la limite est trop élevée, on peut conclure que B n'est pas inférieur à A, mais qu'il est également indiscernable du placebo. Nous ne changerons pas un médicament qui est clairement plus efficace que le placebo (A) pour un médicament qui a la même efficacité que le placebo.
Choix de α
Passons au choix de α. On peut utiliser la valeur standard α = 0,05, mais ce n'est pas tout à fait juste. C'est comme lorsque vous achetez quelque chose en ligne et que vous utilisez plusieurs codes de réduction en même temps, même s'ils ne doivent pas être cumulés — c'est simplement une erreur du développeur et vous avez réussi à en profiter. Selon les règles, le valeur de α doit être égale à la moitié de la valeur de α utilisée lors du test de l'hypothèse de supériorité, c'est-à-dire 0,05 / 2 = 0,025.
Taille de l'échantillon
Comment évaluer la taille de l'échantillon ? Si vous pensez que la vraie différence des moyennes entre A et B est égale à 0, alors le calcul de la taille de l'échantillon sera le même que lors du test de l'hypothèse de supériorité, sauf que vous remplacerez la taille de l'effet par la limite d'efficacité non inférieure, à condition que vous utilisiez α non inférieure efficacité = 1 / 2α supériorité (αnon-inferiority=1/2αsuperiority). Si vous avez des raisons de croire que l'option B pourrait être légèrement inférieure à l'option A, mais que vous souhaitez prouver qu'elle n'est pas pire de plus de Δ, alors vous avez de la chance ! En fait, cela réduit la taille de votre échantillon, car il est plus facile de démontrer que B est inférieur à A si vous pensez réellement qu'il est légèrement inférieur et non équivalent.
Exemple avec une décision
Supposons que vous souhaitiez passer à la version B à condition qu'elle soit inférieure à la version A de pas plus de 0,1 point sur une échelle de satisfaction client de 5 points... Approchons ce problème en utilisant l'hypothèse de supériorité.
Pour tester l'hypothèse de supériorité, nous calculerions la taille de l'échantillon de la manière suivante :
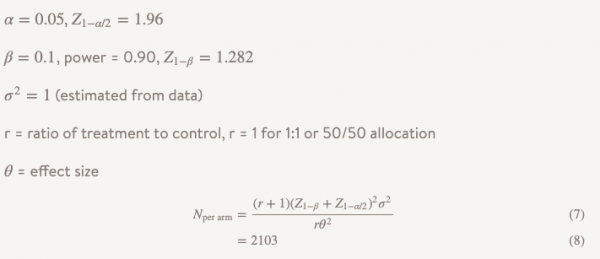
C'est-à-dire que si vous avez 2103 observations dans votre groupe, vous pouvez être sûr à 90 % de découvrir un effet d'une taille de 0,10 ou plus. Mais si la valeur de 0,10 est trop grande pour vous, il serait peut-être préférable de ne pas tester l'hypothèse de supériorité pour cela. Peut-être pour plus de fiabilité, vous décidez de réaliser une étude pour un effet plus petit, par exemple 0,05. Dans ce cas, vous aurez besoin de 8407 observations, soit un échantillon presque quadriplé. Mais que se passerait-il si nous respections notre taille d'échantillon initiale, mais augmentions la puissance à 0,99, afin que nous ne dussions pas douter si nous obtenions un résultat positif ? Dans ce cas, n pour un groupe serait de 3676, ce qui est déjà mieux, mais augmente la taille de l'échantillon de plus de 50 %. Et en fin de compte, nous ne pourrons toujours pas rejeter l'hypothèse nulle, mais pas obtenir de réponse à notre question.
Que faire si nous testions plutôt l'hypothèse d'une efficacité non inférieure ?
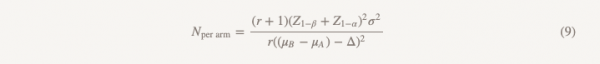
La taille de l'échantillon sera calculée selon la même formule, sauf pour le dénominateur.
Les différences par rapport à la formule utilisée pour tester l'hypothèse de supériorité sont les suivantes :
— Z1−α/2 est remplacé par Z1−α, mais si vous suivez les règles, vous remplacez α = 0,05 par α = 0,025, c'est-à-dire que c'est le même nombre (1,96)
— le dénominateur contient (μB−μA)
— θ (taille de l'effet) est remplacé par Δ (limite d'efficacité non inférieure)
Si nous supposons que µB = µA, alors (µB − µA) = 0 et le calcul de la taille de l'échantillon pour un seuil d'efficacité non inférieure correspond exactement à ce que nous obtiendrions en calculant le dépassement pour une taille d'effet de 0,1, excellent ! Nous pouvons mener une étude de la même ampleur avec différentes hypothèses et une autre approche des conclusions, et nous obtiendrons la réponse à la question à laquelle nous voulons vraiment répondre.
Maintenant, supposons que nous ne pensons en fait pas que µB = µA et
pensions que µB est légèrement moins bon, peut-être de 0,01 unité. Cela augmente notre dénominateur, réduisant la taille de l'échantillon pour le groupe à 1737.
Que se passe-t-il si la version B est en réalité meilleure que la version A ? Nous réfutons l'hypothèse nulle stipulant que B est pire que A de plus de Δ et acceptons l'hypothèse alternative que B, si elle est moins bonne, n'est pas pire que Δ et peut-être meilleure. Essayez d'intégrer cette conclusion dans une présentation interfonctionnelle et voyez ce que cela donne (sérieusement, essayez). Dans une situation où il faut se concentrer sur la perspective, personne ne veut accepter « pas pire que Δ et peut-être mieux ».
Dans ce cas, nous pouvons mener une étude qui s'appelle très brièvement « test d'hypothèse sur le fait qu'une option dépasse l'autre ou lui cède ». Elle utilise deux ensembles d'hypothèses :
Le premier ensemble (identique à celui utilisé pour tester l'hypothèse de non-infériorité) :
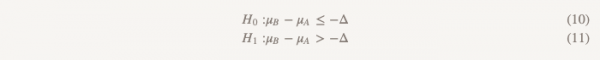
Le second ensemble (identique à celui utilisé pour tester l'hypothèse de supériorité) :
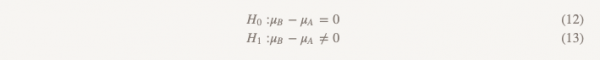
Nous testons la seconde hypothèse uniquement si la première est rejetée. Lors des tests séquentiels, nous maintenons le niveau global des erreurs de premier type (α). En pratique, cela peut être réalisé en créant un intervalle de confiance à 95 % pour la différence entre les moyennes et en vérifiant si tout l'intervalle dépasse -Δ. Si l'intervalle ne dépasse pas -Δ, nous ne pouvons pas rejeter l'hypothèse nulle et nous arrêtons. Si tout l'intervalle dépasse effectivement -Δ, nous continuerons et verrons si l'intervalle contient 0.
Il existe un autre type d'études que nous n'avons pas abordé – les études d'équivalence.
Les recherches de ce type peuvent être remplacées par des études visant à tester l'hypothèse de non-infériorité, mais elles comportent une distinction importante. Un essai pour tester une hypothèse de non-infériorité vise à montrer que l'option B est au moins aussi bonne que A. En revanche, une étude d'équivalence vise à prouver que l'option B est au moins aussi bonne que A, tout en démontrant que A est également aussi bon que B, ce qui est plus complexe. En substance, nous essayons de déterminer si tout l'intervalle de confiance pour la différence des moyennes se situe entre −Δ et Δ. Ces études nécessitent des tailles d'échantillon plus importantes et sont donc réalisées moins fréquemment. Ainsi, la prochaine fois que vous menerez une étude où votre objectif principal est de vous assurer que la nouvelle version n'est pas inférieure, ne vous contentez pas de la "non-réfutation de l'hypothèse nulle". Si vous souhaitez tester une hypothèse réellement significative, envisagez différentes options.
Source : habr.com
