

L'article original est publié sur le site et a été publié sur 3DNews avec l'autorisation de l'auteur. Nous reproduisons le texte complet de l'article, à l'exception d'un grand nombre de liens — ceux-ci seront utiles à ceux qui s'intéressent réellement au sujet et souhaiteraient explorer les aspects théoriques de la photographie computationnelle plus en profondeur, mais pour le grand public, nous avons jugé ce matériel excessif.
Aujourd'hui, aucune présentation de smartphone ne se passe sans parler de ses appareils photo. Chaque mois, nous entendons parler d'un nouveau succès des caméras mobiles : Google apprend au Pixel à prendre des photos dans l'obscurité, Huawei à zoomer comme une jumelle, Samsung intègre un lidar, et Apple crée les coins les plus ronds du monde. Les innovations affluent de partout.
Les reflex numériques semblent stagner. Sony bombarde tout le monde avec de nouveaux capteurs chaque année, tandis que les fabricants mettent paresseusement à jour le dernier chiffre de version et continuent à fumer tranquillement sur le côté. J'ai un reflex à 3000 dollars sur ma table, mais en voyage, je prends un iPhone. Pourquoi ?
Comme le disait un classique — je suis allé sur Internet avec cette question. On discute de «algorithmes» et de «réseaux neuronaux», sans avoir la moindre idée de la façon dont ils affectent la photographie. Les journalistes annoncent bruyamment le nombre de mégapixels, les blogueurs réalisent en chœur des unboxings sponsorisés, et les esthètes se plongent dans «la perception sensible de la palette couleur du capteur». Comme d'habitude.
J'ai dû m'asseoir, passer la moitié de ma vie et comprendre tout par moi-même. Dans cet article, je vous raconterai ce que j'ai appris.
Qu'est-ce que la photographie computationnelle ?
Partout, y compris sur Wikipédia, on donne une définition approchante : la photographie computationnelle — toutes les techniques de capture et de traitement d'images où des calculs numériques sont utilisés au lieu de transformations optiques. Tout est correct, sauf que cela n'explique rien. Cela inclut même l'autofocus, mais n'intègre pas l'optique à lentille qui nous a déjà apporté beaucoup de choses utiles. L'imprécision des définitions officielles semble suggérer que nous n'y comprenons rien.
Pionnier de la photographie computationnelle, le professeur de Stanford Marc Levoy (qui est également actuellement responsable de la caméra du Google Pixel) propose une autre définition : un ensemble de méthodes de vision par ordinateur qui améliorent ou étendent les capacités de la photographie numérique, à l'aide desquelles on obtient une photographie ordinaire qui n'aurait pas pu être prise de manière traditionnelle par cette caméra. Dans cet article, je m'en tiens à sa définition.
Ainsi, tout est la faute des smartphones.
Les smartphones n'avaient d'autre choix que de donner naissance à un nouveau type de photographie : la photographie computationnelle.
Leurs petits capteurs bruyants et leurs minuscules objectifs peu lumineux auraient dû, selon toutes les lois de la physique, engendrer seulement de la douleur et de la souffrance. Et c'est ce qu'ils ont fait, jusqu'à ce que leurs développeurs découvrent habilement comment utiliser leurs forces pour surmonter leurs faiblesses : des obturateurs électroniques rapides, des processeurs puissants et des logiciels.
La plupart des recherches marquantes dans le domaine de la photographie computationnelle ont eu lieu entre 2005 et 2015, ce qui, dans le monde scientifique, est considéré comme littéralement hier. En ce moment, sous nos yeux et dans nos poches, un nouveau domaine de connaissances et de technologies se développe, un domaine qui n'a jamais existé auparavant.
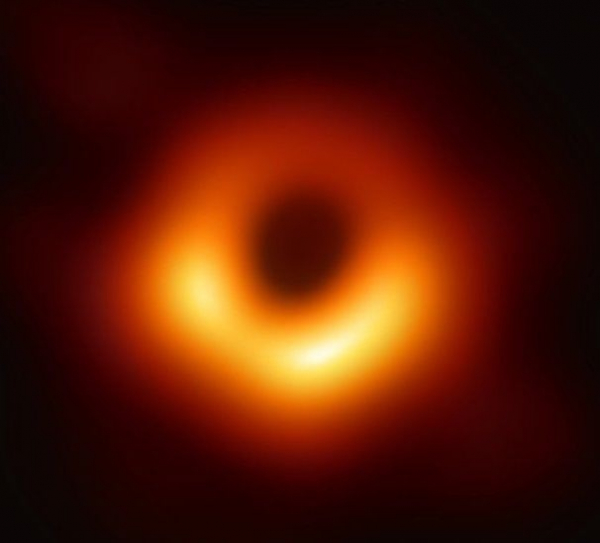
La photographie computationnelle ne se limite pas aux selfies avec bokeh neuronaux. La récente photographie d'un trou noir n'aurait pas vu le jour sans les méthodes de la photographie computationnelle. Pour prendre une telle photo avec un télescope ordinaire, il aurait fallu que celui-ci ait la taille de la Terre. Cependant, en combinant les données de huit radiotélescopes situés à différents endroits de notre planète et en écrivant quelques scripts en Python, nous avons obtenu la première photographie au monde de l'horizon des événements. Cela fonctionne aussi pour des selfies.
Début : traitement d'image numérique
Imaginons que nous soyons revenus en 2007. Notre maman est l'anarchie, et nos photos sont des JPEG bruyants de 0,6 Mpx, prises sur un skateboard. C'est à peu près à cette époque que nous commençons à ressentir un irrépressible désir d'appliquer des presets pour cacher la pauvreté des capteurs mobiles. Ne nous en privons pas.
Matin et Instagram
Avec l'arrivée d'Instagram, tout le monde est devenu obsédé par les filtres. En tant que personne qui, à une époque, a rétro-ingénierie X-Pro II, Lo-Fi et Valencia, bien sûr à des fins de recherche (lol), je me souviens encore qu'ils étaient composés de trois éléments :
- Réglages des couleurs (Teinte, Saturation, Luminosité, Contraste, Niveaux, etc.) – des coefficients numériques simples, tout comme dans n'importe quel preset que les photographes utilisaient depuis des temps immémoriaux.
- Les cartes de mappage des teintes (Tone Mapping) – des vecteurs de valeurs, chacune d'elles nous indiquait : « La couleur rouge avec une nuance de 128 doit être transformée en nuance de 240 ».
- Un overlay – une image semi-transparente de poussière, de grain, de vignette, et de tout le reste qu'on peut superposer pour obtenir un effet de vieux film pas du tout banal. Cela n'était pas toujours présent.
Les filtres modernes ne se sont pas éloignés de ce trio, ils sont devenus juste un peu plus complexes mathématiquement. Avec l'avènement des shaders matériels et d'OpenCL sur les smartphones, ils ont rapidement été réécrits pour le GPU, et cela était considéré comme incroyablement cool. Pour l'année 2012, bien sûr. Aujourd'hui, n'importe quel collégien peut faire pareil en CSS, et il n'obtiendra même pas de mention à sa remise de diplômes.
Cependant, le progrès des filtres aujourd'hui ne s'est pas arrêté. Les gars de Dehancer, par exemple, se concentrent beaucoup sur les filtres non linéaires – au lieu du ton-mapping prolétarien, ils utilisent des transformations non linéaires plus complexes, ce qui, selon eux, ouvre beaucoup plus de possibilités.
Les transformations non linéaires peuvent faire beaucoup de choses, mais elles sont incroyablement complexes, et nous, les humains, sommes incroyablement bêtes. Dès que la science aborde les transformations non linéaires, nous préférons nous tourner vers les méthodes numériques et remplir partout de réseaux de neurones pour qu'ils écrivent des chefs-d'œuvre à notre place. Cela a également été le cas ici.
Automatisation et rêves du bouton « chef-d'œuvre »
Lorsque tout le monde s'est habitué aux filtres, nous avons commencé à les intégrer directement dans les caméras. L'histoire cache qui parmi les fabricants a été le premier, mais juste pour comprendre à quel point cela remonte – dans iOS 5.0, qui est sorti en 2011, il y avait déjà une API publique pour l'Auto Amélioration des Images. Seul Jobs sait combien de temps cela a été utilisé avant d'être ouvert au public.
L'automatisation faisait la même chose que chacun de nous en ouvrant une photo dans un éditeur – elle relevait les ombres et les lumières, ajoutait de la saturation, supprimait les yeux rouges et corrigeait la teinte de la peau. Les utilisateurs ne se doutaient même pas que « l'appareil photo considérablement amélioré » dans le nouveau smartphone n'était que le résultat de quelques nouveaux shaders. Il restait encore cinq ans avant la sortie de Google Pixel et le lancement du buzz sur la photographie computationnelle.
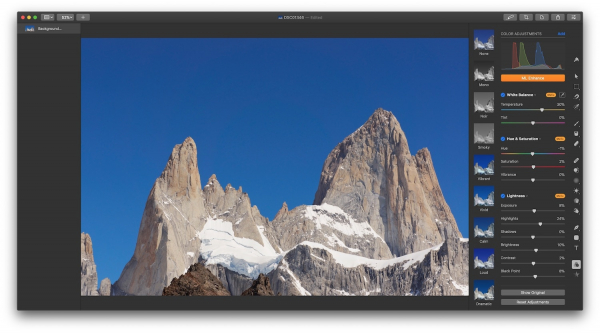
Aujourd'hui, les batailles pour le bouton « chef-d'œuvre » se sont déplacées dans le domaine de l'apprentissage automatique. Après avoir joué avec le ton-mapping, tout le monde s'est précipité pour entraîner des CNN et des GAN à ajuster les paramètres à la place de l'utilisateur. En d'autres termes, déterminer à partir d'une image d'entrée un ensemble de paramètres optimaux qui rapprocheraient cette image d'une certaine compréhension subjective de « bonne photographie ». Cela a été réalisé dans Pixelmator Pro et d'autres éditeurs. Comme on peut le deviner, cela ne fonctionne pas toujours très bien.
Le stacking — 90 % du succès des appareils photo mobiles
La véritable photographie computationnelle a commencé avec le stacking — le superposition de plusieurs photos les unes sur les autres. Pour un smartphone, il n'est pas difficile de prendre une dizaine de clichés en une demi-seconde. Dans leurs caméras, il n'y a pas de pièces mécaniques lentes : l'ouverture est fixe, et au lieu d'un obturateur mobile, il y a un obturateur électronique. Le processeur ordonne simplement au capteur combien de microsecondes il doit capturer des photons sauvages, puis lit le résultat.
Techniquement, un téléphone peut prendre des photos à la vitesse de la vidéo, et des vidéos avec la résolution d'une photo, mais tout dépend de la vitesse du bus et du processeur. C'est pourquoi il y a toujours des limites logicielles.
Le stacking existe avec nous depuis longtemps. Même nos grands-parents installaient des plugins sur Photoshop 7.0 pour assembler plusieurs photos en un HDR éclatant ou créer une panorama de 18000 × 600 pixels et... en réalité, personne n'a jamais vraiment su quoi faire avec après. C'étaient des temps enrichissants, mais hélas, chaotiques.
Aujourd'hui, nous avons grandi et appelons cela la « photographie epsilon » — lorsque, en modifiant l'un des paramètres de la caméra (exposition, mise au point, position) et en assemblant les images obtenues, nous obtenons quelque chose qui ne pouvait pas être capturé en une seule prise. Mais c'est un terme pour les théoriciens, en pratique, un autre nom a pris racine — le stacking. Aujourd'hui, en fait, 90 % des innovations dans les appareils photo mobiles sont basées sur cela.
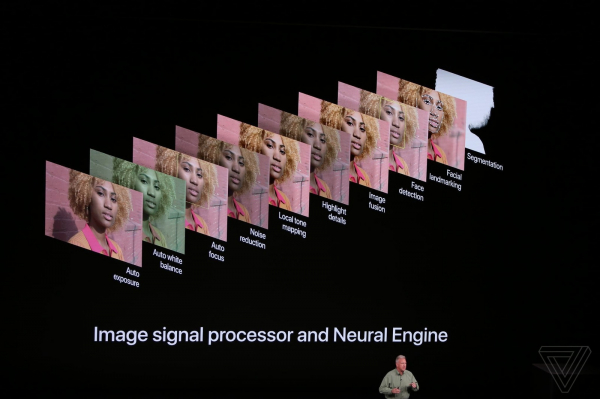
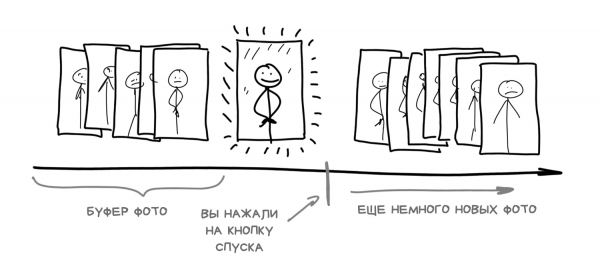
Une chose à laquelle beaucoup ne pensent pas, mais qui est importante pour comprendre toute la photographie mobile et computationnelle : la caméra dans un smartphone moderne commence à prendre des photos dès que vous ouvrez son application. Ce qui est logique, car elle doit bien transmettre l'image à l'écran. Cependant, en plus de l'écran, elle enregistre des images en haute résolution dans son propre tampon circulaire, où elles sont conservées encore quelques secondes.
Lorsque vous appuyez sur le bouton « prendre une photo », celle-ci est en fait déjà capturée, l'appareil photo prend simplement la dernière photo du buffer.
C'est ainsi que fonctionne n'importe quel appareil photo mobile aujourd'hui. Du moins, dans tous les modèles phares, pas dans les appareils bas de gamme. La mise en mémoire tampon permet non seulement de réaliser un déclenchement sans délai, dont les photographes rêvent depuis longtemps, mais même un délai négatif — lorsque vous appuyez sur le bouton, le smartphone regarde dans le passé, extrait les 5 à 10 dernières photos du buffer et commence à les analyser intensément et à les assembler. Il n'est plus nécessaire d'attendre que le téléphone prenne des photos pour le HDR ou le mode nuit, — il suffit de les récupérer du buffer, l'utilisateur ne s'en rend même pas compte.
D'ailleurs, c'est grâce au délai négatif que la fonction Live Photo a été réalisée sur les iPhones, tandis qu'un équivalent a été introduit par HTC dès 2013 sous le nom étrange de Zoe.
Stacking par exposition — HDR et lutte contre les variations de luminosité
La capacité des capteurs d'appareil photo à enregistrer toute la gamme de luminosité que nos yeux peuvent voir est un sujet de débat ancien et passionné. Certains disent que non, car l'œil peut voir jusqu'à 25 stops d'exposition, tandis que même le meilleur capteur plein format ne peut en extraire que 14 au maximum. D'autres considèrent la comparaison comme incorrecte, car l'œil est aidé par le cerveau, qui ajuste automatiquement la pupille et complète l'image par ses propres réseaux neuronaux, et le domaine dynamique instantané de l'œil est en réalité bien plus proche de 10 à 14 stops. Laissons ces débats aux meilleurs penseurs du canapé d'Internet.
Le fait est incontestable : en prenant des amis en photo devant un ciel lumineux sans HDR, sur n'importe quel appareil photo mobile, vous obtenez soit un ciel normal avec des visages noirs, soit des amis bien dessinés mais un ciel brûlé.
La solution a déjà été trouvée : élargir la gamme de luminosité grâce au HDR (High Dynamic Range). Il faut prendre plusieurs photos avec des temps d'exposition différents et les combiner. Pour qu'une soit « normale », une autre soit plus claire, la troisième plus sombre. Nous prenons les zones sombres de l'image claire et remplissons les zones surexposées avec l'image sombre — et voilà. Reste à résoudre le problème du bracketing automatique : combien décaler l'exposition de chaque image pour ne pas exagérer, mais un étudiant en deuxième année d'une école technique saura maintenant déterminer la luminosité moyenne de l'image.
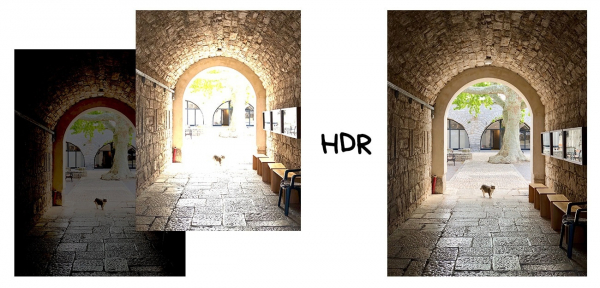
Sur les derniers iPhone, Pixel et Galaxy, le mode HDR s'active automatiquement lorsque l'algorithme simple à l'intérieur de la caméra détecte que vous photographiez quelque chose de contrasté par une journée ensoleillée. On peut même remarquer comment le téléphone bascule en mode enregistrement en tampon pour sauvegarder des images décalées en exposition : la fréquence d'images (fps) de la caméra diminue et l'image devient plus riche. Le moment du changement est bien visible sur mon iPhone X lorsque je prends des photos à l'extérieur. Observez votre smartphone la prochaine fois aussi.
L'inconvénient du HDR avec bracketing d'exposition est son incapacité totale dans des conditions de faible éclairage. Même sous une lampe de chevet, les images sont si sombres que l'ordinateur ne peut pas les aligner et les assembler. Pour résoudre le problème de la lumière, en 2013, Google a présenté une autre approche du HDR dans le smartphone Nexus de l'époque. Il utilisait le stacking temporel.
Le stacking temporel est une simulation de longue exposition et de time-lapse.
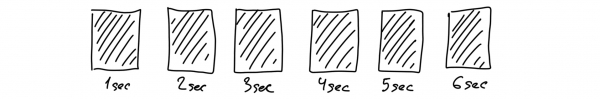
Le stacking temporel permet d'obtenir une longue exposition à partir d'une série de courtes. Les pionniers étaient des passionnés de photographie qui capturaient les traces des étoiles dans le ciel nocturne, trouvant pénible d'ouvrir l'obturateur pendant deux heures. Il était difficile de calculer tous les réglages à l'avance, et le moindre mouvement pouvait gâcher l’image. Ils ont donc décidé d'ouvrir l'obturateur seulement pendant quelques minutes, mais plusieurs fois, puis rentraient chez eux pour assembler les images dans Photoshop.
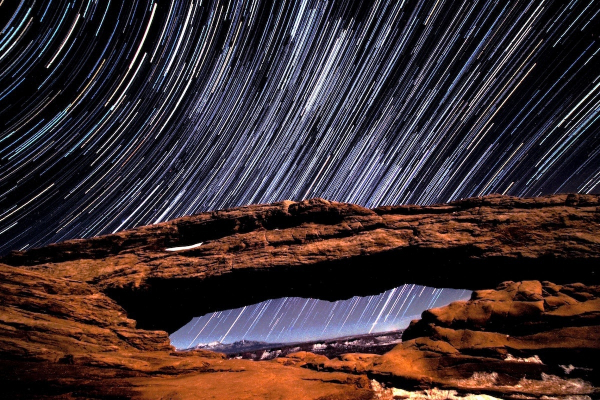
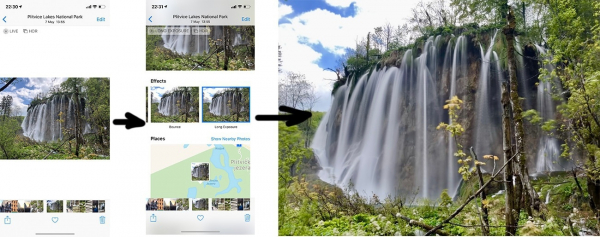
Ainsi, la caméra n'a jamais effectivement photographié en longue exposition, mais nous obtenions un effet d'imitation en superposant plusieurs images prises consécutivement. Pour les smartphones, de nombreuses applications ont longtemps été développées utilisant cette astuce, mais elles ne sont plus nécessaires depuis que cette fonctionnalité a été intégrée dans presque toutes les caméras standard. Aujourd'hui, même un iPhone peut facilement assembler une longue exposition à partir de Live Photo.
Revenons à Google et à son HDR nocturne. Il s'est avéré qu'il est possible de réaliser un bon HDR dans l'obscurité grâce au bracketing temporel. La technologie a fait ses débuts dans le Nexus 5 et s'appelait HDR+. Les autres téléphones Android l'ont reçue comme un cadeau. La technologie est toujours si populaire qu'elle est mise en avant même lors des présentations des derniers Pixel.
Le HDR+ fonctionne de manière assez simple : en détectant que vous photographiez dans l'obscurité, l'appareil photo décharge dans le buffer les 8 à 15 dernières photos en RAW pour les superposer. De cette manière, l'algorithme collecte plus d'informations sur les zones sombres de l'image afin de minimiser le bruit — des pixels où, pour une raison quelconque, l'appareil photo n'a pas pu collecter toutes les informations et a failli.
C'est comme si vous ne saviez pas à quoi ressemble un capybara et demandiez à cinq personnes de le décrire — leurs récits seraient à peu près similaires, mais chacun mentionnerait un détail unique. Ainsi, vous collecteriez plus d'informations que si vous ne demandiez qu'à une seule personne. C'est la même chose avec les pixels.
L'addition des photos prises depuis un même point donne le même effet trompeur d'exposition longue que pour les étoiles mentionnées plus haut. L'exposition de dizaines de photos s'additionne, les erreurs sur l'une sont minimisées sur les autres. Imaginez combien de fois il faudrait déclencher l'obturateur d'un reflex pour atteindre un tel résultat.
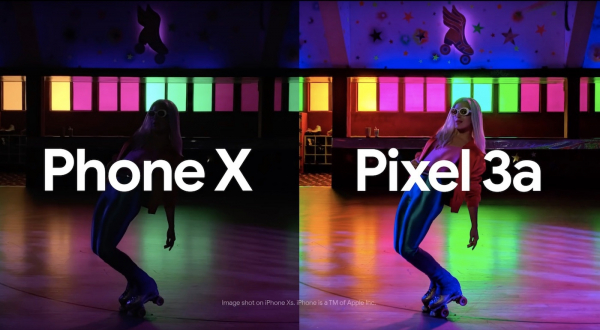
Il ne restait plus qu'à résoudre le problème de la correction colorimétrique automatique — les photos prises dans l'obscurité sont généralement uniformément jaunes ou vertes, alors que nous voulons quelque chose qui ressemble à la lumière du jour. Dans les premières versions du HDR+, cela était résolu par un simple ajustement des paramètres, comme dans des filtres de type Instagram. Par la suite, nous avons fait appel aux réseaux de neurones.
C'est ainsi qu'est née la technologie Night Sight — la "photographie nocturne" sur les Pixel 2 et 3. Dans la description, il est clairement indiqué : « Techniques d'apprentissage machine reposant sur le HDR+, qui font fonctionner le Night Sight ». En gros, c'est une automatisation de l'étape de correction des couleurs. La machine a été formée sur un ensemble de données de photos "avant" et "après" pour transformer un ensemble de photographies sombres en une belle image.
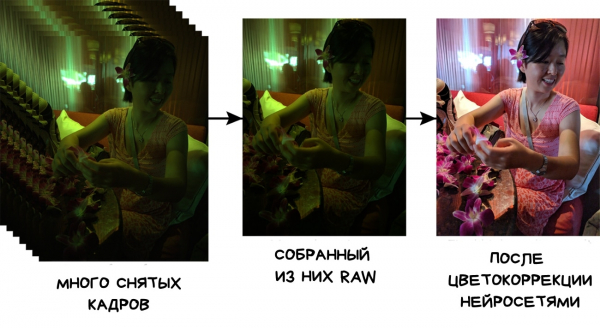
Au fait, l'ensemble de données a été mis à disposition publiquement. Peut-être que les gars d'Apple le prendront et apprendront enfin à leurs téléphones en verre à bien photographier dans l'obscurité.
De plus, Night Sight utilise le calcul du vecteur de mouvement des objets dans le cadre pour normaliser le flou qui résulte inévitablement d'une longue exposition. Ainsi, le smartphone peut prendre des parties nettes d'autres images et les coller ensemble.
Le stacking par mouvement — panorama, super zoom et lutte contre le bruit
La panorama est un loisir populaire chez les habitants des zones rurales. Il n'existe apparemment aucun cas où une photo de saucisse aurait intéressé quelqu'un en dehors de son auteur, mais il est impossible de ne pas en parler — pour beaucoup, cela a marqué le début du stacking.
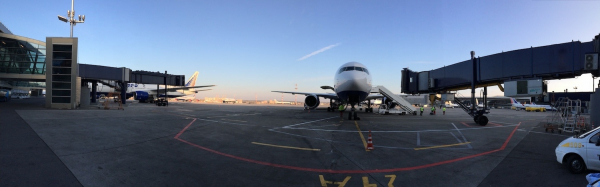
La première utilisation utile de la panorama est la création d'une photo de plus haute résolution que celle fournie par le capteur de la caméra grâce à l'assemblage de plusieurs images. Les photographes utilisent depuis longtemps divers logiciels pour ces fameuses photos à super résolution — lorsque des photos légèrement décalées se complètent entre les pixels. On peut ainsi obtenir des images de plusieurs centaines de gigapixels, ce qui est très utile si vous devez les imprimer sur une affiche publicitaire de la taille d'une maison.
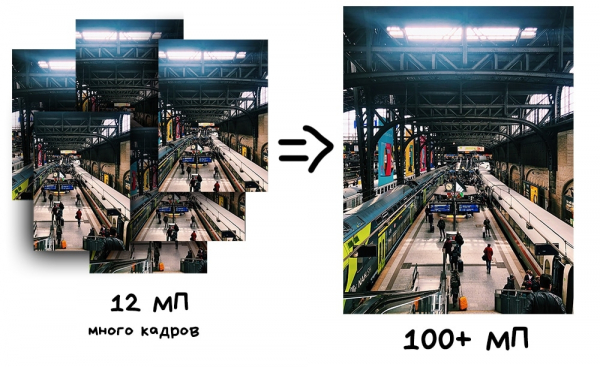
Une autre approche, déjà plus intéressante — le Pixel Shifting. Certains appareils sans miroir comme Sony et Olympus ont commencé à le supporter depuis 2014, mais le résultat devait quand même être assemblé manuellement. Des innovations typiques pour les grands appareils.
Les smartphones, quant à eux, ont réussi ici pour une drôle de raison — lorsque vous prenez une photo, vos mains tremblent. Ce qui semble être un problème a posé les bases de la mise en œuvre de la super résolution native sur les smartphones.
Pour comprendre comment cela fonctionne, il faut se rappeler comment est constituée la matrice de toute caméra. Chaque pixel (photodiode) ne peut enregistrer que l'intensité de la lumière — c'est-à-dire le nombre de photons entrants. Cependant, un pixel ne peut pas mesurer sa couleur (longueur d'onde). Pour obtenir une image en RGB, il a donc fallu mettre en place des solutions de contournement — couvrir toute la matrice d'un réseau de petits verres colorés. La réalisation la plus populaire s'appelle le filtre de Bayer et est utilisée aujourd'hui dans la plupart des capteurs. Cela ressemble à l'image ci-dessous.
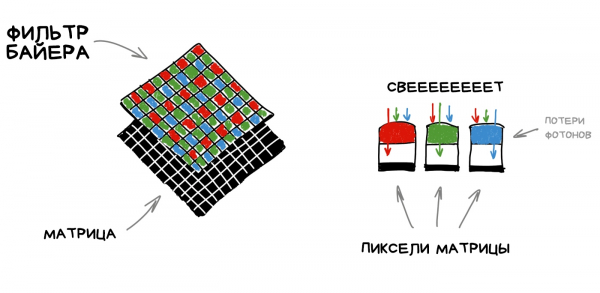
Il s'avère que chaque pixel de la matrice ne capte qu'une composante R, G ou B, car les autres photons sont impitoyablement reflétés par le filtre de Bayer. Les composants manquants sont calculés par une simple moyenne des valeurs des pixels adjacents.
Il y a plus de cellules vertes dans le filtre Bayer, car cela a été fait par analogie avec l'œil humain. Ainsi, sur 50 millions de pixels de la matrice, le vert va capter 25 millions, le rouge et le bleu 12,5 millions chacun. Le reste sera moyenné — ce processus est appelé débayerisation ou démozaïquage, et c'est une solution assez grossière sur laquelle tout repose.
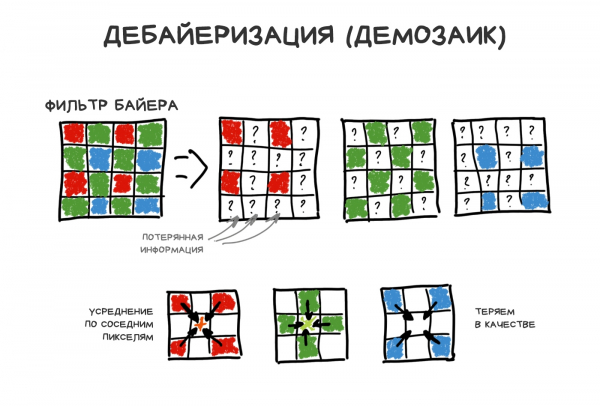
En réalité, chaque matrice a son propre algorithme de démozaïquage breveté, mais dans cette histoire, nous allons l'ignorer.
D'autres types de matrices (comme le Foveon) ne se sont pas encore vraiment répandus. Bien que certains fabricants essaient d'utiliser des matrices sans filtre Bayer pour améliorer la netteté et la plage dynamique.
Lorsque la lumière est faible ou que les détails de l'objet sont très petits, nous perdons beaucoup d'informations, car le filtre Bayer coupe sans vergogne les photons de longueurs d'onde indésirables. C'est pourquoi le Pixel Shifting a été inventé — décalant la matrice d'un pixel vers le haut, le bas, la droite ou la gauche, afin de capter tout cela. La photo résultante n'est pas quatre fois plus grande, comme on pourrait le penser, mais le processeur utilise ces données pour enregistrer plus précisément la valeur de chaque pixel. Il average non pas par rapport aux voisins, mais par rapport à quatre valeurs de lui-même, pour ainsi dire.
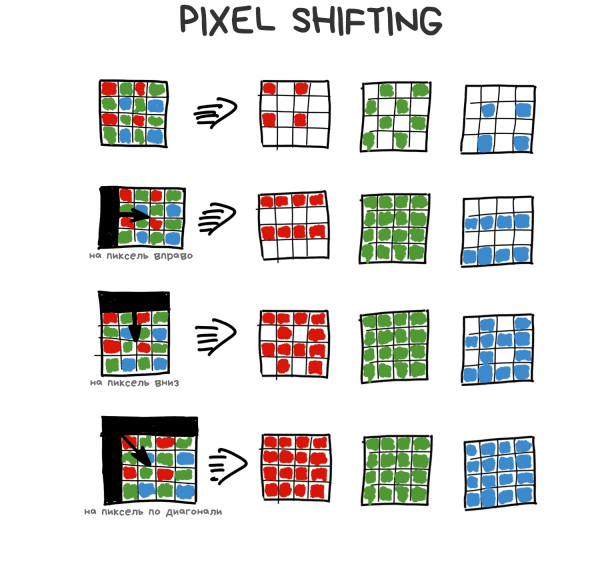
La tremblote de nos mains lors de la prise de photos avec le téléphone rend ce processus inévitable. Dans les dernières versions de Google Pixel, cette fonctionnalité est réalisée et s'active toujours lorsque vous utilisez le zoom sur le téléphone - cela s'appelle Super Res Zoom (oui, j'aime aussi leur nom sans pitié). Les Chinois ont également copié cela dans leurs smartphones, bien que cela ait été un peu moins réussi.
Le superposition de plusieurs photos légèrement décalées permet de rassembler plus d'informations sur la couleur de chaque pixel, et donc de réduire le bruit, d'augmenter la netteté et d'augmenter la résolution sans augmenter le nombre physique de mégapixels de la matrice. Les flagship Android modernes le font automatiquement, sans que leurs utilisateurs n'y pensent même.
Le stacking par mise au point — n'importe quelle profondeur de champ et refocus en post-production.
La méthode provient de la macrophotographie, où une faible profondeur de champ a toujours été un problème. Pour que l'objet entier soit en focus, il fallait prendre plusieurs photos en déplaçant la mise au point d'avant en arrière, pour ensuite les assembler en une seule image nette. Cette même méthode était souvent utilisée par les amateurs de photographie de paysage, rendant le premier plan et l'arrière-plan aussi nets que possible.
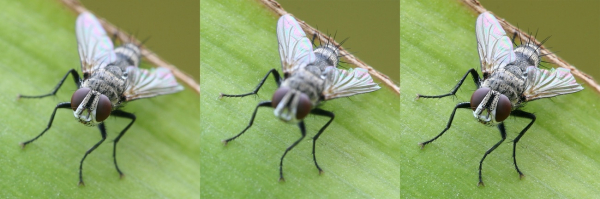
Tout cela a également migré vers les smartphones, bien sûr sans trop de battage médiatique. En 2013, le Nokia Lumia 1020 sort avec l'application 'Refocus', suivi en 2014 par le Samsung Galaxy S5 avec le mode 'Selective Focus'. Ils fonctionnaient selon le même principe : en appuyant sur le bouton, ils prenaient rapidement 3 photos — une avec la mise au point 'normale', une avec la mise au point décalée vers l'avant et une avec la mise au point décalée vers l'arrière. Le programme alignait les images et permettait de choisir l'une d'elles, ce qui était présenté comme un véritable contrôle de la mise au point en post-production.
Aucune autre retouche n'était nécessaire, car même ce simple hack était suffisant pour clouer un peu plus le couvercle sur Lytro et ses analogues avec leur mise au point réelle. D'ailleurs, parlons d'eux (maître des transitions de niveau 80).
Matrices computationnelles – champs lumineux et plénoptiques.
Comme nous l'avons compris plus haut, nos matrices sont un véritable cauchemar sur des béquilles. Nous sommes simplement habitués et essayons de vivre avec ça. En termes de conception, elles ont peu changé depuis le début des temps. Nous avons simplement perfectionné le processus industriel – réduit la distance entre les pixels, lutté contre le bruit et les interférences, ajouté des pixels spéciaux pour le fonctionnement de l'autofocus à phase. Mais il suffit de prendre même le reflex numérique le plus cher et d'essayer de photographier un chat en mouvement dans une pièce éclairée – le chat, pour dire le moins, l'emportera.
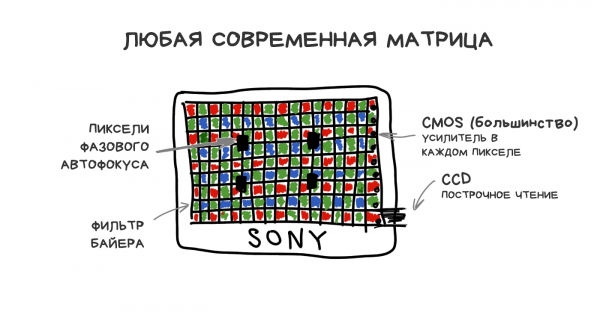
Nous essayons depuis longtemps d'inventer quelque chose de meilleur. De nombreuses tentatives et recherches dans ce domaine peuvent être retrouvées sous les requêtes 'capteur computationnel' ou 'capteur non-Bayer', et même l'exemple de Pixel Shifting ci-dessus peut être considéré comme une tentative d'amélioration des matrices par le biais de calculs. Toutefois, les histoires les plus prometteuses au cours des vingt dernières années viennent du monde des soi-disant caméras plénoptiques.
Pour que vous ne vous endormiez pas d'impatience face aux mots compliqués à venir, je vous livre une info : la caméra des derniers Google Pixel est en fait 'un peu' plénoptique. Juste deux pixels, mais cela lui permet même de calculer la profondeur de champ optique réelle sans avoir besoin d'une seconde caméra comme les autres.
La plénoptique est une arme puissante qui n'a pas encore été utilisée. Je vais partager un lien vers l'un de mes récents articles préférés , d'où j'ai emprunté des exemples.
Bientôt, chaque appareil photo sera plénoptique.
Inventée en 1994, assemblée à Stanford en 2004. La première caméra grand public, Lytro, a été lancée en 2012. L'industrie de la VR expérimente activement avec des technologies similaires.
La différence entre une caméra ordinaire et une caméra plénoptique réside dans une seule modification : le capteur est recouvert d'une grille de lentilles, chacune d'elles recouvrant plusieurs pixels réels. Voici comment cela fonctionne :
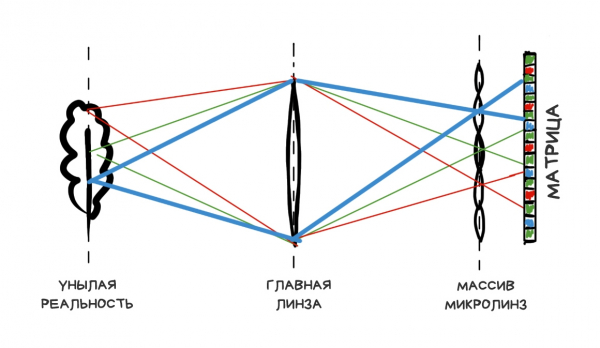
si l'on calcule correctement la distance entre la grille et le capteur, ainsi que la taille de l'ouverture, l'image résultante comportera des clusters de pixels bien définis, comme de mini-versions de l'image originale.
Il s'avère que si vous prenez un pixel central de chaque cluster et assemblez l'image uniquement à partir de ceux-ci, elle ne sera pas différente de celle prise avec une caméra ordinaire. Oui, nous perdrons un peu de résolution, mais nous demanderons simplement à Sony d'ajouter encore quelques mégapixels dans les nouveaux capteurs.
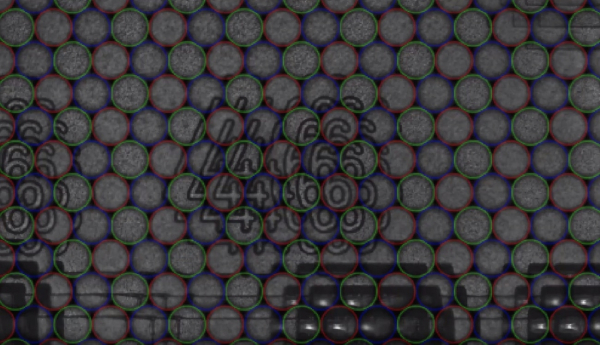
Le plaisir ne fait que commencer. Si vous prenez un autre pixel de chaque cluster et à nouveau assemblez l'image, vous obtiendrez à nouveau une photo normale, mais comme si elle avait été prise avec un décalage d'un pixel. Ainsi, en ayant des clusters de 10 × 10 pixels, nous obtiendrons 100 images de l'objet sous "quelques" angles différents.
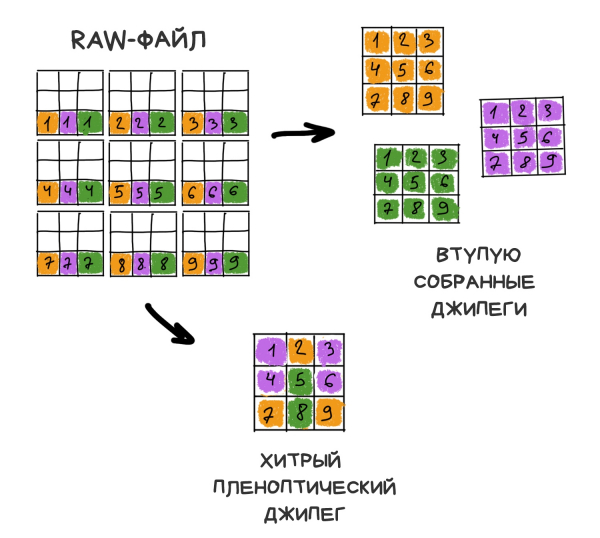
Plus la taille du cluster est grande, plus il y a d'images, mais la résolution est moins bonne. Dans le monde des smartphones avec des capteurs de 41 mégapixels, nous pouvons un peu négliger la résolution, mais il y a une limite à tout. Il faut trouver un équilibre.
D'accord, nous avons assemblé une caméra plénoptique, et qu'est-ce que cela nous apporte ?
Un refocus honnête.
La fonctionnalité dont tous les journalistes parlaient dans leurs articles sur Lytro est la possibilité d'une correction de mise au point réaliste en post-production. Par 'réaliste', je veux dire que nous n'appliquons pas de divers algorithmes de défloutage, mais utilisons uniquement les pixels à notre disposition, les choisissant ou les moyennant à partir des clusters dans un ordre approprié.
Une photo RAW d'une caméra plénoptique a un aspect étrange. Pour obtenir un JPEG net habituel à partir de celle-ci, il faut d'abord le reconstruire. Pour ce faire, il faut sélectionner chaque pixel du JPEG à partir des clusters RAW. Selon comment nous les choisissons, le résultat changera.
Par exemple, plus un cluster est éloigné de l'endroit où le faisceau original tombe, plus ce faisceau devient flou. C'est une question d'optique. Pour obtenir une image décalée en focus, il suffit de sélectionner des pixels à la distance souhaitée par rapport à l'original — soit plus près, soit plus loin.
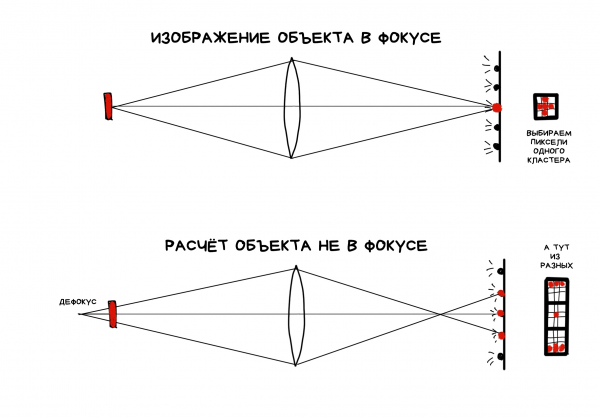
Le décalage de focus vers soi était plus compliqué — il y avait physiquement moins de ces pixels dans les clusters. Au début, les développeurs ne voulaient même pas permettre à l'utilisateur de faire la mise au point manuellement — la caméra le décidait automatiquement par logiciel. Cette perspective n’a pas plu aux utilisateurs, donc la fonctionnalité a été ajoutée dans les mises à jour ultérieures sous le nom de « mode créatif », mais le refocus y était sévèrement limité exactement pour cette raison.
Carte de profondeur et 3D avec une seule caméra
Une des opérations les plus simples en plénoptiques est l'obtention d'une carte de profondeur. Pour cela, il suffit de rassembler deux images différentes et de calculer combien les objets sont déplacés entre elles. Plus le déplacement est important, plus ils sont éloignés de la caméra.
Récemment, Google a acheté et mis fin à Lytro, mais a utilisé ses technologies pour son VR et… pour la caméra du Pixel. À partir du Pixel 2, la caméra est devenue « un peu » plénoptique pour la première fois, mais avec des clusters de seulement deux pixels. Cela a permis à Google de ne pas installer de deuxième caméra, comme tous les autres, mais de calculer la carte de profondeur uniquement à partir d'une seule photo.
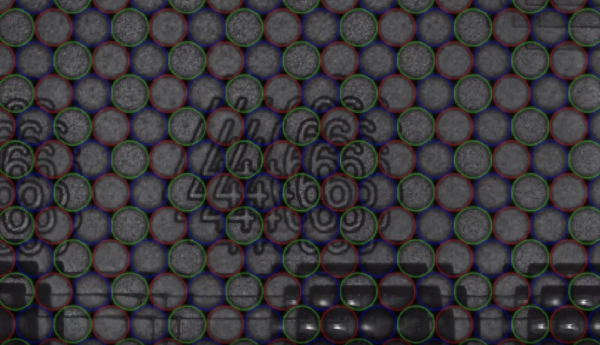
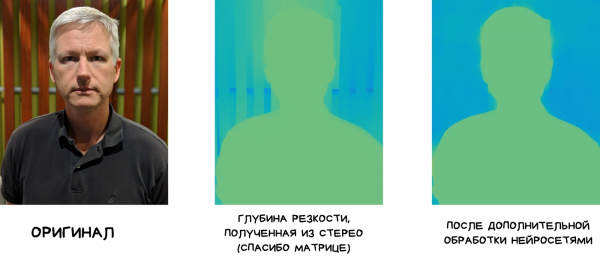
La carte de profondeur est construite à partir de deux images décalées d'un subpixel. Cela suffit largement pour calculer une carte de profondeur binaire et séparer le premier plan de l'arrière-plan, floutant ce dernier dans le bokeh tendance. Le résultat de cette séparation est encore lissé et « amélioré » par des réseaux neuronaux formés pour améliorer les cartes de profondeur (et non pas flouter, comme beaucoup le pensent).
Le fait est que la plénoptique dans les smartphones nous a été offerte presque gratuitement. Nous installions déjà des lentilles sur ces minuscules capteurs pour augmenter le flux lumineux. Dans les prochains Pixel, Google prévoit d'aller encore plus loin en couvrant quatre photodiodes avec une lentille.
Source : 3dnews.ru
