

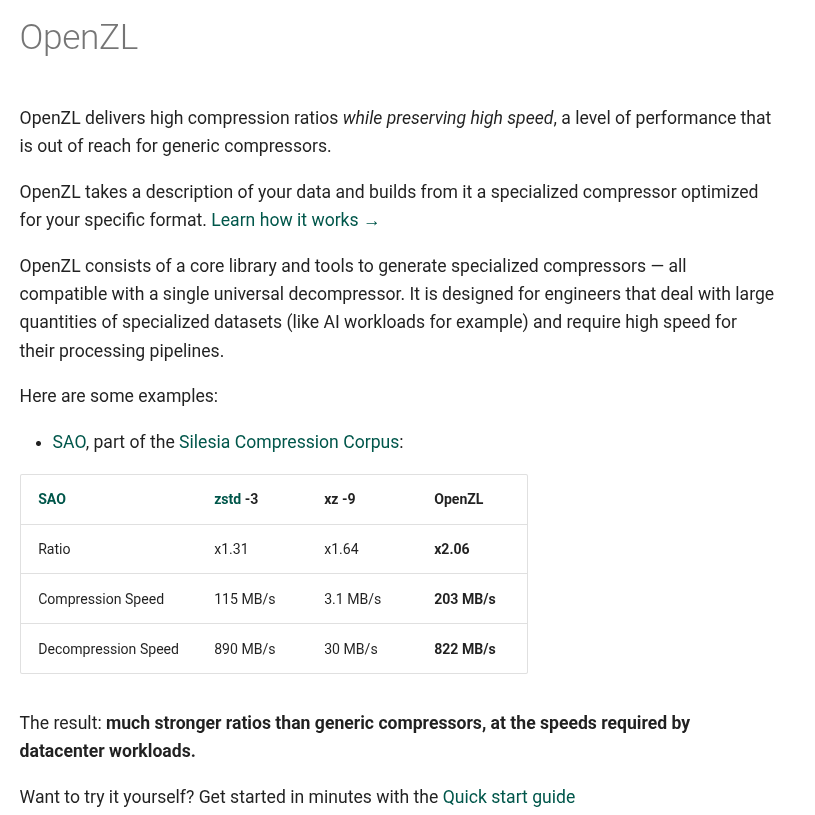
Après sept mois de développement, la version 0.2.0 du framework a été publiée OpenZL, conçu pour créer des compresseurs de données sans perte.
Le framework se compose d'une bibliothèque de base et d'outils pour créer des compresseurs spécialisés, décrits dans le langage SDDL.
Pour créer un bon compresseur spécialisé, il y a deux étapes :
- Analyse des données pour extraire la structure.
- Utilisation de bons compresseurs backend, qui utilisent la structure obtenue pour atteindre une bonne compression.
OpenZL fournit des outils pour les deux étapes.
Le projet est écrit en C et C++ et est distribué sous la licence BSD.
Principales modifications
SDDL2
SDDL a été complètement réécrit depuis le début pour atteindre les objectifs de conception prévus. Si la version démo initiale était un environnement d'exécution simplifié, SDDL2 est un véritable compilateur : l'analyseur syntaxique transmet les données à l'analyseur sémantique, qui à son tour passe l'arbre syntaxique abstrait typé (AST) à l'optimiseur, et l'optimiseur gère le générateur de code qui génère le bytecode de la machine virtuelle.
Le résultat clé est une analyse syntaxique instantanée. Lorsque la position d'un enregistrement peut être complètement déterminée uniquement par les paramètres et les constantes, le moteur accède directement à n'importe quel champ, sans scanner les octets précédents, ce qui permet un accès sans copie et une bande passante de plusieurs Go/s.
Le langage lui-même a évolué avec l'ensemble d'outils. Maintenant, il prend en charge des blocs when pour des emplacements conditionnels, des enregistrements paramétrés et anonymes, l'accès aux membres des champs d'enregistrements, ainsi que des opérateurs bit à bit et logiques.
En ce qui concerne la convivialité pour les développeurs, l'étape d'analyse sémantique détecte désormais les références indéfinies, les incohérences de types et les erreurs d'arité au moment de la compilation – avec indication des emplacements dans le code source – et une extension VS Code a été publiée pour la coloration syntaxique des fichiers .sddl.
Nouveau codec LZ intégré
OpenZL inclut désormais son propre codec LZ, présenté sous la forme de ZL_GRAPH_LZ, ainsi qu'un profil de compression séquentielle dans l'outil zli. Le développement du codec se poursuit : un ensemble de fonctionnalités est en cours d'expansion et des améliorations de performances dans le traitement des petites entrées sont en cours. À ce jour, il prend en charge une fonctionnalité équivalente à celle de zstd niveau 1, avec une taille de fenêtre de compression de 64 Ko.
OpenZL permet de repenser chaque étape du pipeline LZ afin d'augmenter la vitesse. Son architecture en graphe permet également de combiner les étapes de codage d'entropie au lieu d'utiliser un seul pipeline qui convient également à tous les cas d'utilisation. Ensuite, plusieurs étapes peuvent être combinées en une seule opération pour augmenter la vitesse de traitement. Cela permet à OpenZL d'assurer une vitesse de compression 10 % supérieure et une vitesse de décompression 70 % plus élevée par rapport à Zstandard de niveau 1 sur la base Silesia dans nos tests:
| Compresseur | Taux de compression | Vitesse de compression | Vitesse de décompression |
|---|---|---|---|
| OpenZL LZ niveau 1 | 2.74 | 466 Mo/s | 2288 Mo/s |
| Zstd niveau 1 avec taille de fenêtre de 64 Ko | 2.74 | 419 Mo/s | 1254 Mo/s |
| Zstd niveau 1 | 2.89 | 424 Mo/s | 1345 Mo/s |
Prise en charge de très grandes entrées
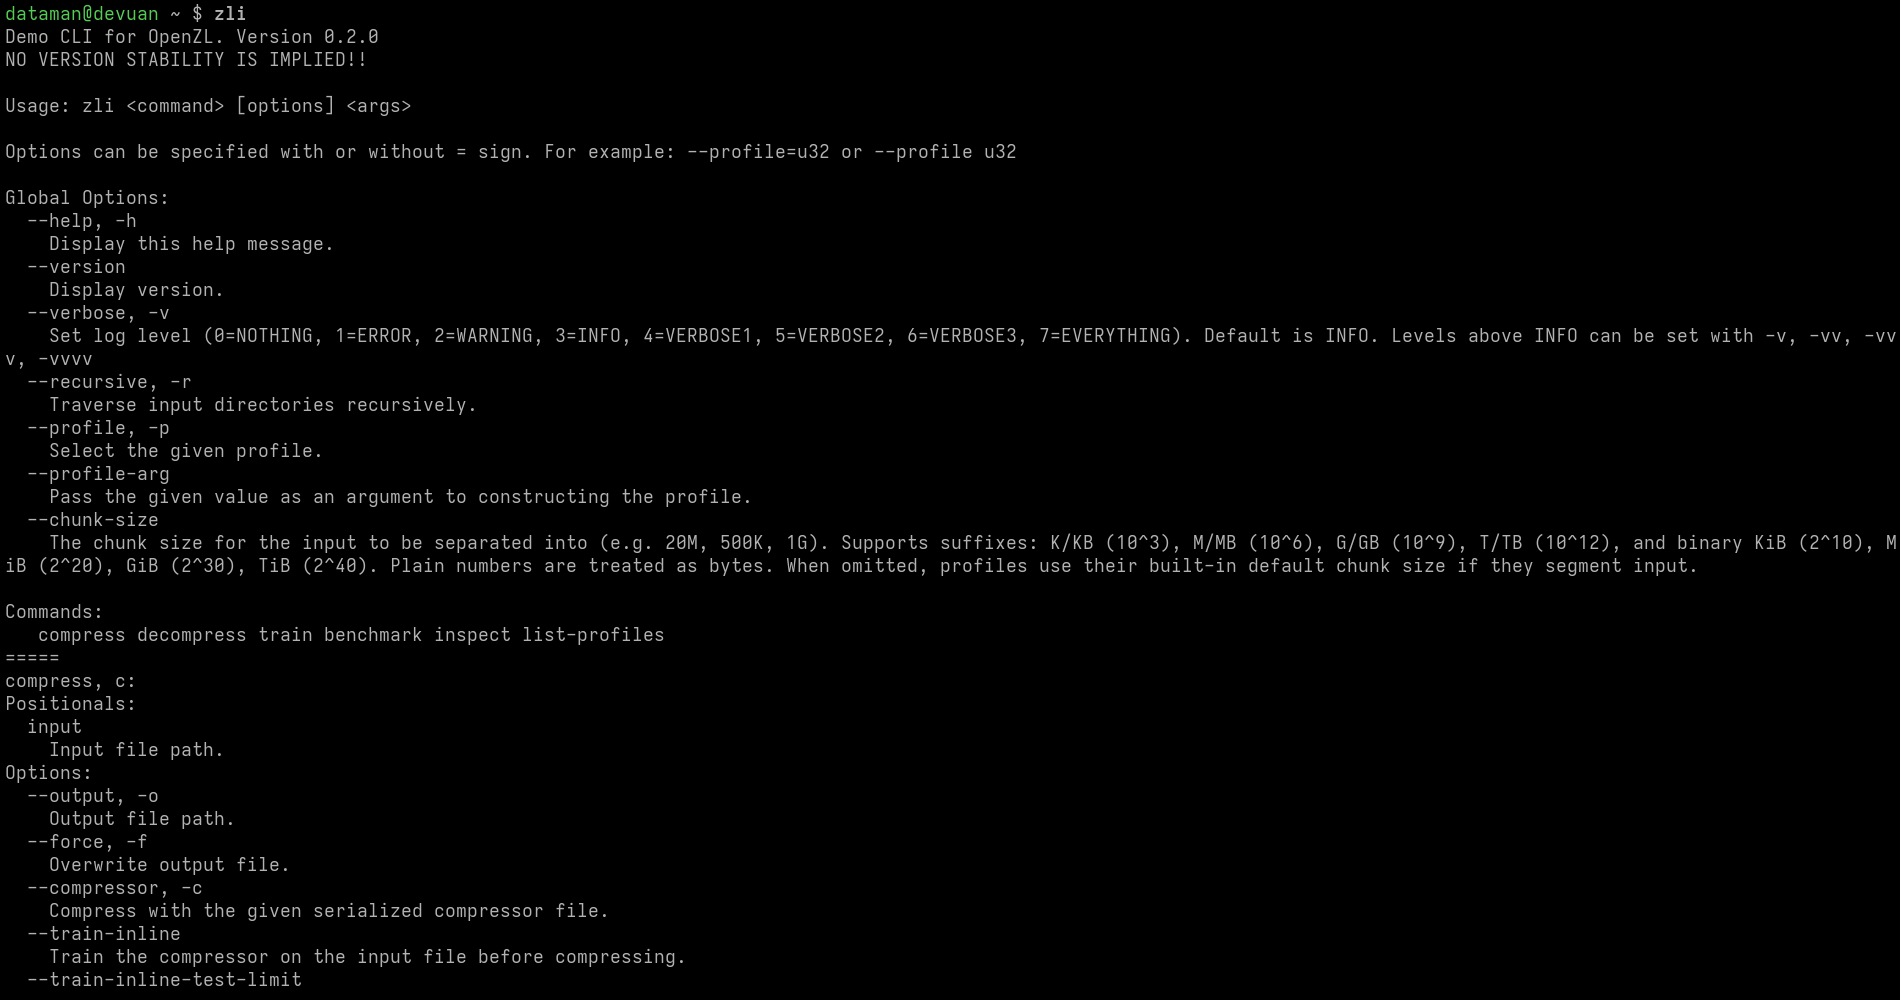
zli prend désormais en charge le traitement d'énormes données d'entrée (de plusieurs gigaoctets). Avant la compression, ces données sont maintenant automatiquement divisées en segments de taille gérée (par défaut – environ 16 Mo), ce qui permet de limiter la mémoire utilisée, d'améliorer la localité des données et ouvre des possibilités de traitement parallèle. Une fonction similaire de fragmentation automatique est implémentée dans SDDL2 lors de travaux basés sur un schéma. De nouveaux segmentateurs ont été créés ou mis à jour – pour CSV, Parquet et données numériques standard – et tous les segmentateurs sont maintenant sérialisables et configurables, de sorte que la configuration choisie peut être enregistrée dans le compresseur et réutilisée ultérieurement.
Cela s'applique de manière transparente lors de la compression. Notez que le pipeline d'apprentissage est différent et reste inchangé, il n'est donc pas destiné à recevoir de gigantesques données d'entrée comme matériel d'apprentissage.
Améliorations dans le visualiseur de graphe en ligne (essayer)
Le visualiseur reconnaît désormais les tracés de compression et de décompression du début à la fin.
Le panneau de prévisualisation du flux permet de visualiser les octets passant effectivement par chaque bord, et grâce aux éléments de contrôle de recadrage, même les flux volumineux restent faciles à manipuler.
Le panneau de configuration regroupe tous les paramètres d'affichage au même endroit, et l'ensemble complet de touches de raccourci – navigation dans les directions, itération ordonnée, déploiement et repli, sélection des nœuds – permet d'utiliser l'outil sans souris de manière conviviale.
Les traces ont maintenant des versions, la compression par blocs est affichée correctement, et zli peut enfin générer ses propres traces avec les nouvelles options —trace et —trace-streams-dir.
Divers
- Plusieurs codecs ont été ajoutés au répertoire. Les codecs Partition et bitpack utilisent désormais un décodeur combiné. Le codec Floating-point bitsplit dispose d'encodeurs et de décodeurs spécifiques pour les formats fp16, fp32, fp64 et bf16 avec des accélérations spécialisées. Des fonctionnalités de division en tenant compte de la plage (split_byrange), un multiplexeur de longueur, un codec sentinel, un graphique lz4 et de petites fonctions auxiliaires comme tryParseInt et splitByParam ont été ajoutés.
- L'API a été ordonnée.
- Le test de fuzzing a été amélioré.
- Le processus de construction et d'emballage a été optimisé pour un plus grand nombre de plateformes.
Source : linux.org.ru

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish