

Un guide détaillé sur l'optimisation de l'environnement Linux pour maximiser la performance du traitement des requêtes HTTP a été publié. Les méthodes proposées ont permis d'augmenter la performance du gestionnaire JSON basé sur la bibliothèque libreactor dans l'environnement Amazon EC2 (4 vCPU) de 224 000 requêtes API par seconde avec les paramètres par défaut d'Amazon Linux 2 avec noyau 4.14 à 1,2 million de requêtes par seconde après optimisation (augmentation de 436 %), tout en réduisant les latences de traitement des requêtes de 79 %. Les méthodes proposées ne sont pas spécifiques à libreactor et fonctionnent avec d'autres serveurs http, y compris nginx, Actix, Netty et Node.js (libreactor a été utilisé dans les tests car la solution basée sur lui a montré la meilleure performance).
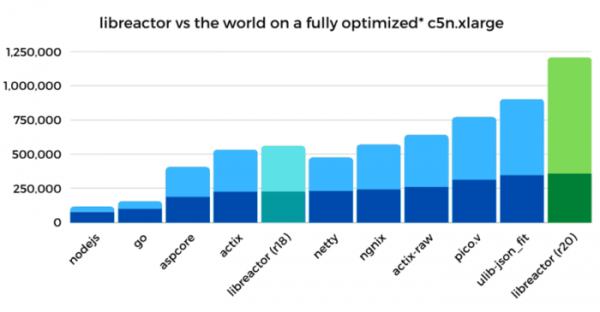
Optimisations principales :
- Optimisation du code libreactor. Une version R18 du set Techempower a été utilisée comme base, qui a été améliorée en supprimant le code limitant le nombre de cœurs CPU utilisés (l'optimisation a permis d'accélérer de 25-27 %), en le compilant avec GCC avec les options « -O3 » (augmentation de 5-10 %) et « -march-native » (5-10 %), en remplaçant les appels read/write par recv/send (5-10 %) et en réduisant les frais généraux lors de l'utilisation de pthreads (2-3 %). L'augmentation totale de la performance après optimisation du code a été de 55 %, tandis que le débit est passé de 224k req/s à 347k req/s.
- Désactivation de la protection contre les vulnérabilités causées par l'exécution spéculative des instructions. L'utilisation des paramètres au démarrage du noyau « nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off » a permis d'augmenter la performance de 28 %, tandis que le débit est passé de 347k req/s à 446k req/s. L'augmentation due au paramètre « nospectre_v1 » (protection contre Spectre v1 + SWAPGS) était de 1-2 %, « nospectre_v2 » (protection contre Spectre v2) — 15-20 %, « pti=off » (Spectre v3/Meltdown) — 6 %, « mds=off tsx_async_abort=off » (MDS/Zombieload et TSX Asynchronous Abort) — 6 %. Les paramètres de protection contre les attaques L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass et SRBDS ont été laissés inchangés, car ils n'influençaient pas la performance, étant donné qu'ils ne recoupaient pas avec la configuration testée (par exemple, spécifiques à KVM, la virtualisation imbriquée et d'autres modèles de CPU).
- Désactivation des mécanismes d'audit et de verrouillage des appels système à l'aide de la commande « auditctl -a never,task » et en spécifiant l'option « —security-opt seccomp=unconfined » lors du démarrage du conteneur docker. L'augmentation totale de la performance a été de 11 %, tandis que le débit est passé de 446k req/s à 495k req/s.
- Désactivation d'iptables/netfilter en téléchargeant les modules du noyau qui leur sont associés. L'idée de désactiver le pare-feu, qui n'était pas utilisé dans une solution serveur spécifique, a été motivée par les résultats du profilage, selon lesquels l'exécution de la fonction nf_hook_slow prenait 18 % du temps. Il est noté que nftables fonctionne plus efficacement qu'iptables, mais qu'Amazon Linux continue d'utiliser iptables. Après la désactivation d'iptables, le gain de performance a été de 22 %, et le débit est passé de 495k req/s à 603k req/s.
- Réduction de la migration des gestionnaires entre les différents cœurs CPU pour améliorer l'efficacité de l'utilisation du cache processeur. L'optimisation a été réalisée à la fois au niveau du couplage des processus libreactor aux cœurs CPU (CPU Pinning) et par le biais de l'affectation des gestionnaires réseau du noyau (Receive Side Scaling). Par exemple, irqbalance a été désactivé et des liaisons explicites des files d'attente aux CPU ont été établies dans /proc/irq/$IRQ/smp_affinity_list. Pour utiliser un même cœur CPU pour le traitement du processus libreactor et de la file d'attente réseau des paquets entrants, un gestionnaire BPF dédié a été utilisé, connecté via le drapeau SO_ATTACH_REUSEPORT_CBPF lors de la création du socket. Pour lier les files d'attente des paquets sortants au CPU, les paramètres dans /sys/class/net/eth0/queues/tx-/xps_cpus ont été modifiés. Le gain de performance total a été de 38 %, et le débit est passé de 603k req/s à 834k req/s.
- Optimisation du traitement des interruptions et utilisation du polling. L'activation du mode adaptive-rx dans le pilote ENA et les manipulations avec sysctl net.core.busy_read ont permis d'augmenter la performance de 28 % (le débit est passé de 834k req/s à 1,06M req/s, et la latence a diminué de 361μs à 292μs).
- Désactivation des services système entraînant des blocages inutiles dans la pile réseau. La désactivation de dhclient et la configuration adresses IP manuelle ont conduit à une augmentation de la performance de 6 %, et le débit est passé de 1,06M req/s à 1,12M req/s. La raison de l'impact de dhclient sur la performance a été analysée par un trafic à l'aide de socket brut.
- Lutte contre le Spin Lock. Passer la pile réseau en mode « noqueue » via sysctl « net.core.default_qdisc=noqueue » et « tc qdisc replace dev eth0 root mq » a entraîné un gain de performance de 2 %, et le débit est passé de 1,12M req/s à 1,15M req/s.
- Des optimisations finales mineures, telles que la désactivation de GRO (Generic Receive Offload) avec la commande « ethtool -K eth0 gro off » et le remplacement de l'algorithme de contrôle de congestion cubic par reno via sysctl « net.ipv4.tcp_congestion_control=reno ». L'augmentation globale de performance a été de 4 %. La capacité a augmenté de 1,15 M req/s à 1,2 M req/s.
En plus des optimisations réussies, l'article examine également les méthodes qui n'ont pas conduit à l'augmentation de performance attendue. Par exemple, les suivantes se sont révélées inefficaces :
- Une exécution distincte de libreactor n'a pas présenté de différence de performance par rapport à son exécution dans un conteneur. Le remplacement de writev par send, l'augmentation de maxevents dans epoll_wait, ainsi que les expériences avec les versions et les options de GCC n'ont pas eu d'impact (l'effet n'était perceptible que pour les options « -O3 » et « -march-native »).
- La mise à jour du noyau Linux vers les versions 4.19 et 5.4, l'utilisation des planificateurs SCHED_FIFO et SCHED_RR, les manipulations de sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 et clocksource=tsc n'ont pas eu d'effet sur la performance.
- Dans le pilote ENA, l'activation des modes Offload (segmentation, scatter-gather, rx/tx checksum), la compilation avec l'option « -O3 » et l'application des paramètres ena.rx_queue_size et ena.force_large_llq_header n'ont pas influencé les performances.
- Les modifications apportées à la pile réseau n'ont pas entraîné une augmentation de performance :
- Désactivation d'IPv6 : ipv6.disable=1
- Désactivation de VLAN : modprobe -rv 8021q
- Désactivation de la vérification de l'origine des paquets
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (effet négatif)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Source : opennet.ru

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish