

La sortie du projet Vortex 3.0 est disponible, développant un GPGPU basé sur l'architecture de jeu d'instructions RISC-V, conçu pour effectuer des calculs parallèles à l'aide de l'API OpenCL et du modèle d'exécution SIMT (Single Instruction, Multiple Threads). Le projet peut également être utilisé pour mener des recherches dans le domaine de la 3D et pour développer de nouvelles architectures GPU. Les schémas, descriptions des blocs matériels en Verilog, simulateurs, pilotes et documentation de projet associée sont distribués sous la licence Apache 2.0.
Le GPGPU est basé sur l'ISA RISC-V classique, étendu par des instructions supplémentaires pour prendre en charge les fonctions GPU et la gestion des flux. Les modifications apportées à l'architecture du jeu d'instructions RISC-V sont minimales et, lorsque cela est possible, utilisent déjà des instructions vectorielles existantes. Parmi les instructions supplémentaires : « tex » pour accélérer le traitement des textures ; vx_rast pour gérer la rasterisation, vx_rop pour le traitement des fragments, profondeur et transparence ; vx_imadd pour exécuter l'opération « multiplier et additionner » ; vx_wspawn, vx_split, vx_join, vx_tmc et vx_bar pour activer des groupes de flux (wavefront) exécutés en parallèle par SIMD Engine.
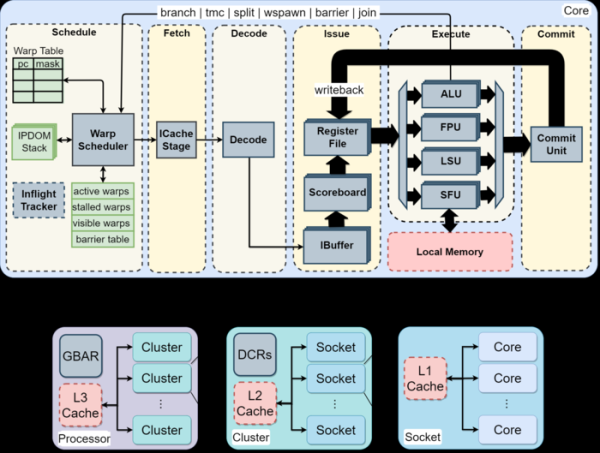
Le GPGPU développé prend en charge les architectures de jeu d'instructions RISC-V 32 bits et 64 bits RV32IMF et RV64IMAFD, et peut inclure une mémoire partagée facultative, des caches de niveaux L1, L2 et L3, ainsi qu'un nombre configurable de cœurs, de blocs de tâches (warps) et de flux. De plus, pour chaque cœur, il est possible d'activer un nombre configurable d'ALU, FPU, LSU et SFU. Des FPGA Xilinx et Altera peuvent être utilisés pour la création de prototypes, et pour simuler le fonctionnement de la puce, Verilator (simulateur Verilog), RTLSIM (simulation RTL) et SimX (simulation logicielle) peuvent être utilisés.
Pour le développement d'applications, un kit d'outils est proposé, incluant des variantes de PoCL adaptées au travail avec Vortex (compilateur et runtime OpenCL), LLVM/Clang, GCC et Binutils. Le projet prend en charge la spécification OpenCL 1.2 et le support des représentations intermédiaires des shaders SPIR-V est réalisé par traduction en OpenCL.
Parmi les changements dans Vortex 3.0 :
- Un pipeline graphique matériel a été ajouté, incluant des blocs pour la rasterisation, le mélange de textures et la fusion des sorties (OM — Output Merger). Pour Mesa, basé sur le pipeline graphique réalisé et le rasteriseur logiciel lavapipe, un pilote Vulkan vortexpipe a été préparé.
- Les capacités du cœur tensoriel, conçu pour accélérer l'exécution des modèles d'apprentissage automatique, ont été étendues avec l'implémentation du support de la parcimonie structurée pour la compression des matrices de poids.
- L'opération WGMMA (multiplication de matrices au niveau du groupe de déformation) a été mise en œuvre pour la multiplication de matrices en mode asynchrone.
- Un moteur DXA (Accélération du Transfert de Données) a été ajouté pour accélérer le transfert de données de la mémoire globale à la mémoire locale.
- Une nouvelle architecture basée sur le processeur de commandes (CP, Command Processor) et le planificateur matériel de cœurs de calcul (KMU - Kernel Management Unit) a été mise en œuvre, permettant de décharger vers le chip les opérations de répartition des flux de calcul.
- Une nouvelle bibliothèque runtime a été proposée, fonctionnant en mode non-bloquant et fournissant des abstractions traduisibles en commandes exécutées au niveau matériel en asynchrone. Le support des files d'attente, des événements, des modules et de la synchronisation basée sur des barrières asynchrones avec la sémantique arrive/wait/event est inclus.
- Le soutien aux instructions RISC-V raccourcies (RVC) a été ajouté.
- La prise en charge matérielle des opérations atomiques (Hardware Atomics) a été mise en œuvre.
- L'unité de calcul en virgule flottante (FPU) a été entièrement refaite, avec de nouveaux blocs de multiplicateurs (Wallace-tree, Folded-radix) et d'additionneurs (Kogge-Stone) proposés.
- Une pile de mémoire virtuelle basée sur un contrôleur de mémoire (MMU) avec prise en charge de l'architecture d'adressage virtuel 32 bits SV32 a été ajoutée.
- Le support de l'extension RISC-V Zicond avec la mise en œuvre d'opérations conditionnelles est disponible.
- La gestion de l'horloge (clock gating) a été intégrée.
- Le support du langage HIP (Heterogeneous Interface for Portability) a été réalisé via le cadre chipStar, qui traduit HIP en SPIR-V.
- Une intégration complète avec le simulateur GEM5 a été assurée et le support pour le simulateur SimX sur l'architecture TLM (Transaction-Level Modeling) a été ajouté.
- Le support des outils Synopsys et Yosys pour la synthèse logique pour la fabrication de puces a été ajouté, ainsi que le soutien à l'utilisation des bibliothèques d'éléments standards ASAP7 (7nm), SAED14 (14nm) et NanGate (15nm).
- L'outil de référence a été mis à jour vers LLVM 20 et POCL 7.0.
Source : opennet.ru
