

Les plus grandes entreprises de développement dans le domaine de l'apprentissage automatique ont présenté le projet OpenXLA, visant le développement collaboratif d'outils pour la compilation et l'optimisation de modèles pour les systèmes d'apprentissage automatique. Sous l'égide du projet, le développement d'outils permettant d'unifier la compilation de modèles préparés dans les frameworks TensorFlow, PyTorch et JAX a été pris en charge, pour un apprentissage et une exécution efficaces sur différents GPU et accélérateurs spécialisés. Des entreprises telles que Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba et Amazon se sont jointes à la collaboration sur le projet.
On s'attend à ce qu'en raison de l'unification des efforts des équipes de recherche de premier plan et des représentants de la communauté, le développement des systèmes d'apprentissage automatique soit stimulé et que la fragmentation de l'infrastructure pour différents frameworks et équipements soit résolue. OpenXLA permet de réaliser un support efficace pour divers matériels, quelle que soit la base sur laquelle le modèle d'apprentissage automatique a été créé. On prévoit qu'OpenXLA permettra de réduire le temps d'entraînement des modèles, d'augmenter la bande passante, de diminuer les latences, de réduire les coûts des ressources informatiques et d'accélérer la mise sur le marché des produits.
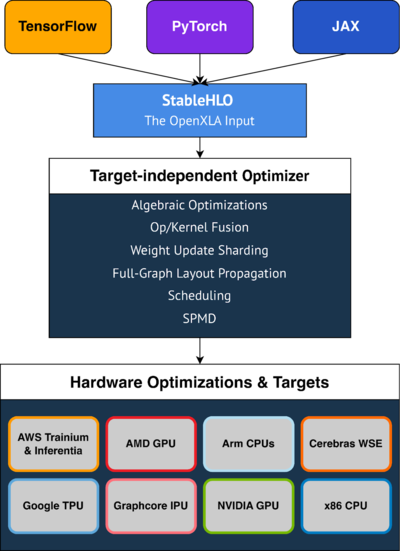
OpenXLA se compose de trois composants principaux, dont le code est distribué sous licence Apache 2.0 :
- XLA (Accelerated Linear Algebra) — un compilateur permettant d'optimiser les modèles d'apprentissage automatique pour une exécution à haute performance sur différentes plateformes matérielles, y compris les GPU, CPU et accélérateurs spécialisés de divers fabricants.
- StableHLO — spécification et mise en œuvre de base d'un ensemble d'opérations de haut niveau (HLO, High-Level Operations) à utiliser dans les modèles des systèmes d'apprentissage automatique. Il sert de couche intermédiaire entre les frameworks d'apprentissage automatique et les compilateurs, transformant le modèle pour l'exécution sur un matériel spécifique. Des couches pour la génération de modèles au format StableHLO ont été préparées pour les frameworks PyTorch, TensorFlow et JAX. Un ensemble MHLO a été utilisé comme base pour StableHLO, qui a été étendu avec un support de sérialisation et de versioning.
- IREE (Environnement d'exécution de représentation intermédiaire) — un compilateur et un runtime qui transforme les modèles d'apprentissage automatique en une représentation intermédiaire universelle, basée sur le format MLIR (Représentation intermédiaire multi-niveau) du projet LLVM. Par conséquent, on note la possibilité de compilation anticipée, le support de la gestion des flux, la possibilité d'utiliser des éléments dynamiques dans les modèles, ainsi que l'optimisation pour différents CPU et GPU, avec peu de surcharge.
Principaux avantages de l'outil OpenXLA :
- Atteinte d'une performance optimale sans avoir à plonger dans l'écriture de code spécifique à certains dispositifs. Fourniture d'optimisations prêtes à l'emploi, incluant la simplification des expressions algébriques, la gestion efficace de la mémoire, et la planification de l'exécution en tenant compte de la réduction des pics de consommation de mémoire et des surcharges.
- Simplification du scalage et de la parallélisation des calculs. Le développeur n'a qu'à ajouter des annotations pour un sous-ensemble de tenseurs critiques, à partir desquelles le compilateur peut générer automatiquement le code pour des calculs parallèles.
- Assurance de portabilité grâce au support de différentes plateformes matérielles, telles que les GPU AMD et NVIDIA, les CPU basés sur les architectures x86 et ARM, ainsi que les accélérateurs ML TPU de Google, AWS Trainium Inferentia, Graphcore et Cerebras Wafer-Scale Engine.
- Support de l'intégration d'extensions permettant des fonctionnalités supplémentaires, comme le support d'écriture de primitives d'apprentissage profond à l'aide de CUDA, HIP, SYCL, Triton et d'autres langages pour des calculs parallèles. Possibilité de réglage manuel des goulets d'étranglement dans les modèles.
Source : opennet.ru
