

La société Stability AI a publié la deuxième version de son système d'apprentissage automatique Stable Diffusion, capable de synthétiser et de modifier des images en fonction d'un modèle proposé ou d'une description textuelle en langage naturel. Le code des outils pour former le réseau de neurones et générer des images est écrit en Python en utilisant le framework PyTorch et est publié sous licence MIT. Les modèles déjà entraînés sont ouverts sous une licence permissive Creative ML OpenRAIL-M, permettant une utilisation à des fins commerciales. Un générateur d'images en ligne de démonstration est également disponible.
Améliorations clés dans la nouvelle version de Stable Diffusion :
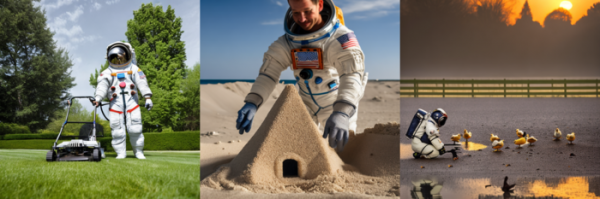
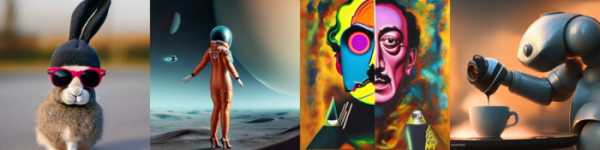
- Un nouveau modèle de synthèse d'images à partir de descriptions textuelles a été créé — SD2.0-v, prenant en charge la génération d'images avec une résolution de 768×768. Ce nouveau modèle a été entraîné à l'aide de la collection LAION-5B, qui comprend 5,85 milliards d'images avec des descriptions textuelles. Le modèle utilise le même ensemble de paramètres que le modèle Stable Diffusion 1.5, mais se distingue par le passage à un encodeur fondamentalement différent, OpenCLIP-ViT/H, ce qui a considérablement amélioré la qualité des images résultantes.

- Une version simplifiée, SD2.0-base, a été préparée, entraînée sur des images de 256×256 avec un modèle classique de prédiction du bruit et prenant en charge la génération d'images avec une résolution de 512×512.

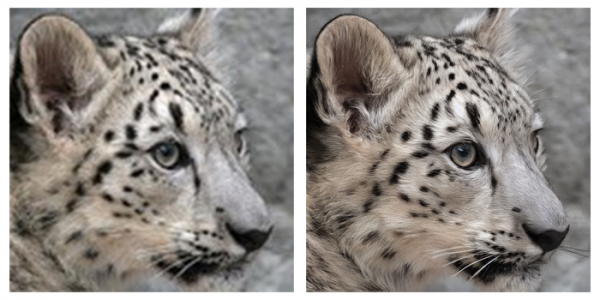
- La possibilité d'utiliser la technologie de super-sampling (Super Resolution) a été fournie pour augmenter la résolution de l'image d'origine sans perte de qualité, en utilisant des algorithmes de mise à l'échelle spatiale et de reconstruction des détails. Le modèle de traitement d'images fourni (SD20-upscaler) prend en charge une augmentation d'échelle quadruple, ce qui permet de former des images avec une résolution de 2048×2048.

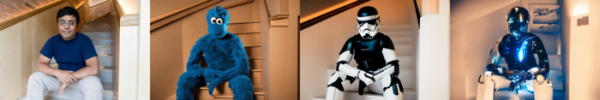
- Un modèle SD2.0-depth2img a été proposé, prenant en compte la profondeur et la disposition spatiale des objets. Pour l'estimation monoculaire de la profondeur, le système MiDaS est utilisé. Le modèle permet de synthétiser de nouvelles images en utilisant une autre image comme modèle, qui peuvent radicalement différer de l'original, tout en conservant la composition générale et la profondeur. Par exemple, il est possible d'utiliser la pose d'une personne sur une photo pour former un autre personnage dans la même pose.


- Le modèle pour la modification d'images a été mis à jour — SD 2.0-inpainting, permettant de remplacer et de modifier des parties de l'image à l'aide de suggestions textuelles.
- Les modèles ont été optimisés pour une utilisation sur des systèmes ordinaires avec un seul GPU.
Source : opennet.ru
