

Dans cet article, nous allons parler des dépendances fonctionnelles dans les bases de données : ce que c'est, où elles sont appliquées et quels algorithmes existent pour les rechercher.
Nous examinerons les dépendances fonctionnelles dans le contexte des bases de données relationnelles. Pour faire simple, dans ces bases de données, l'information est stockée sous forme de tables. Par la suite, nous utiliserons des notions approximatives qui ne sont pas interchangeables dans la stricte théorie relationnelle : la table elle-même sera appelée relation, les colonnes — attributs (leur ensemble constituant le schéma de la relation), et un ensemble de valeurs d'une ligne sur un sous-ensemble d'attributs — un tuple.
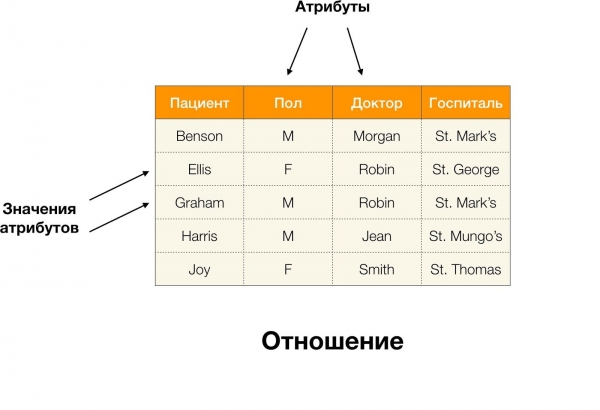
Par exemple, dans la table ci-dessus, (Benson, M, M organ) est un tuple selon les attributs (Patient, Sexe, Médecin).
Plus formellement, cela s'écrit sous la forme suivante :  [Patient, Sexe, Médecin] = (Benson, M, M organ).
Nous pouvons maintenant introduire le concept de dépendance fonctionnelle (DF) :
Définition 1. Une relation R satisfait une DF X → Y (où X, Y ⊆ R) si et seulement si, pour tous les tuples  ,
 ∈ R, il est vrai que : si
 [X] =
 [X], alors
 [Y] =
 [Y]. Dans ce cas, on dit que X (déterminant, ou ensemble d'attributs déterminants) détermine fonctionnellement Y (ensemble dépendant).
En d'autres termes, la présence de la DF X → Y signifie que si nous avons deux tuples dans R et qu'ils coïncident selon les attributs X, ils coïncideront également selon les attributs Y.
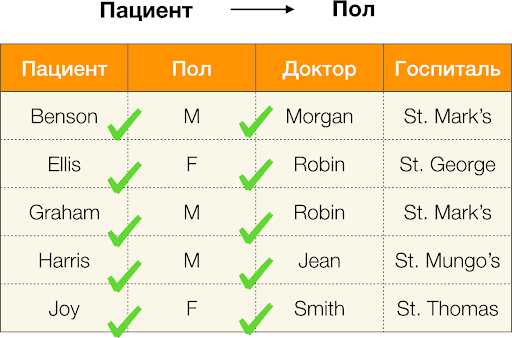
Maintenant, procédons dans l'ordre. Considérons les attributs Patient et Genre pour lesquels nous voulons savoir s'il existe des dépendances entre eux. Pour cet ensemble d'attributs, les dépendances suivantes peuvent exister :
- Patient → Sexe
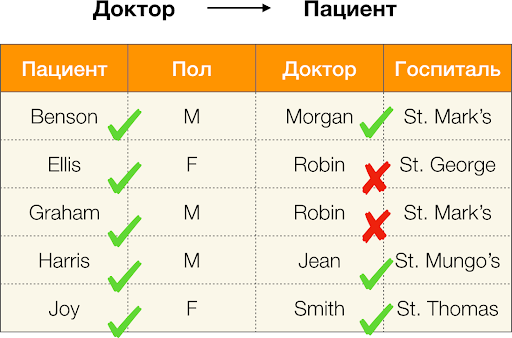
- Sexe → Patient
Selon la définition ci-dessus, pour que la première dépendance soit maintenue, chaque valeur unique de la colonne Patient doit correspondre à une seule valeur de la colonne Genre. Pour notre table exemple, c'est effectivement le cas. Cependant, dans l'autre sens, cela ne fonctionne pas, c'est-à-dire que la seconde dépendance n'est pas satisfaite, et l'attribut Genre n'est pas un déterminant pour Patient.De même, si l'on considère la dépendance Médecin → Patient, on peut constater qu'elle est violée, car la valeur Robin pour cet attribut a plusieurs valeurs différentes — Ellis et Graham..
Ainsi, les dépendances fonctionnelles permettent de définir les relations existantes entre les ensembles d'attributs d'une table. À partir de maintenant, nous allons examiner les relations les plus intéressantes, c'est-à-dire celles X → Y, qui sont :
- non triviales, c'est-à-dire que la partie droite de la dépendance n'est pas un sous-ensemble de la gauche (Y ̸⊆ X);
- minimales, c'est-à-dire qu'il n'existe pas de dépendance de forme Z → Y, que Z ⊂ X.
Les dépendances examinées jusqu'à présent étaient strictes, c'est-à-dire qu'elles ne prévoyaient aucune violation dans la table, mais il existe également des dépendances qui autorisent une certaine incohérence entre les valeurs des tuples. Ces dépendances sont classées dans une catégorie distincte, appelées approximatives, et il leur est permis de violer un certain nombre de tuples. Ce nombre est régulé par le coefficient d'erreur maximale emax. Par exemple, une part d'erreur  = 0.01 peut signifier que la dépendance peut être violée sur 1 % des tuples dans l'ensemble d'attributs considéré. En d'autres termes, pour 1000 enregistrements, un maximum de 10 tuples peuvent violer la DF. Nous allons examiner une métrique légèrement différente, basée sur les valeurs distinctes des tuples comparés. Pour la dépendance X → Y sur la relation r elle est considérée ainsi :

Calculons l'erreur pour Médecin → Patient de l'exemple précédent. Nous avons deux tuples, dont les valeurs diffèrent par l'attribut Patient, mais coïncident sur Médecin:  [Médecin, Patient] = (Robin, EllisDeep Speech
 [Médecin, Patient] = (Robin, Graham). Selon la définition de l'erreur, nous devons prendre en compte toutes les paires conflictuelles, ce qui signifie qu'il y en aura deux : (
 ,
 ) et son inversion (
 ,
 ). Substituons dans la formule et nous obtiendrons :

Et maintenant, essayons de répondre à la question : « Pourquoi tout cela ? ». En réalité, les DF peuvent être de différentes sortes. Le premier type est constitué de dépendances qui sont définies par l'administrateur lors de la conception de la base de données. Elles sont généralement peu nombreuses, strictes, et leur principale application est la normalisation des données et la conception du schéma relationnel.
Le second type est constitué de dépendances représentant des données « cachées » et des relations auparavant inconnues entre des attributs. Autrement dit, ces dépendances n'étaient pas envisagées au moment de la conception et sont découvertes sur un ensemble de données existant, permettant ensuite de tirer des conclusions sur les informations stockées en se basant sur de nombreuses fonctions découvertes. C'est précisément avec ces dépendances que nous travaillons. Elles sont le sujet d'un domaine entier du data mining avec différentes techniques de recherche et des algorithmes construits sur leur base. Voyons comment les dépendances fonctionnelles trouvées (précises ou approximatives) peuvent être utiles dans certaines données.
Aujourd'hui, l'un des principaux domaines d'application des dépendances est le nettoyage des données. Cela implique le développement de processus pour identifier les « données sales » suivis de leur correction. Des exemples typiques de « données sales » incluent les doublons, les erreurs dans les données ou les fautes de frappe, les valeurs manquantes, les données obsolètes, les espaces superflus, etc.
Exemple d'erreur dans les données :
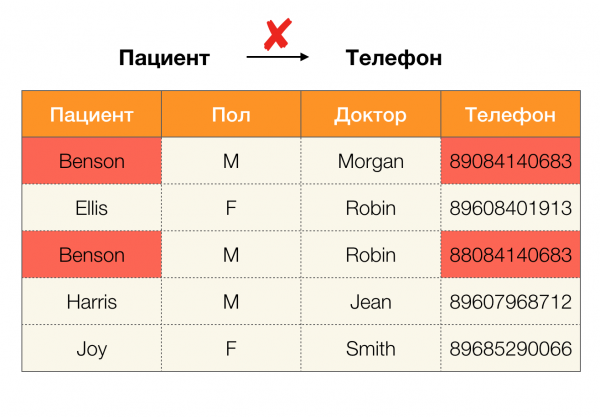
Exemple de doublons dans les données :
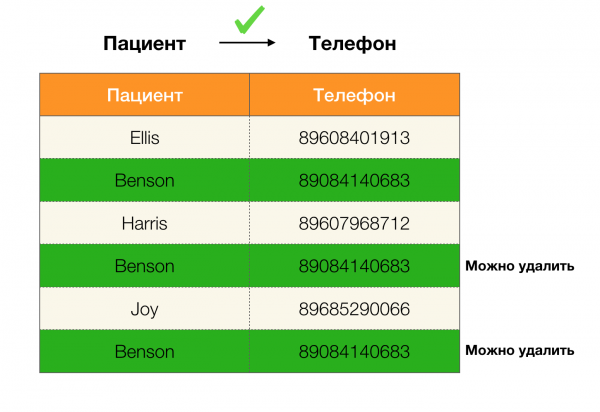
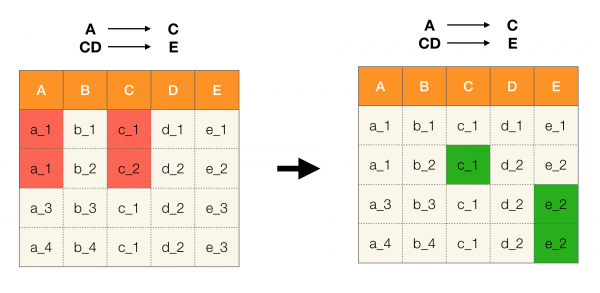
Par exemple, nous avons un tableau et un ensemble de fonctions qui doivent être respectées. Le nettoyage des données dans ce cas implique de modifier les données de manière à ce que les fonctions soient valides. De plus, le nombre de modifications doit être minimal (il existe des algorithmes spécifiques pour ce processus, sur lesquels nous ne nous concentrerons pas dans cet article). Ci-dessous se trouve un exemple de telle transformation des données. À gauche, la relation initiale, qui, de toute évidence, ne respecte pas les fonctions nécessaires (en rouge, un exemple de violation d'une des fonctions). À droite, la relation mise à jour, dans laquelle les cellules vertes montrent les valeurs modifiées. Après avoir effectué cette procédure, les dépendances nécessaires ont été rétablies.
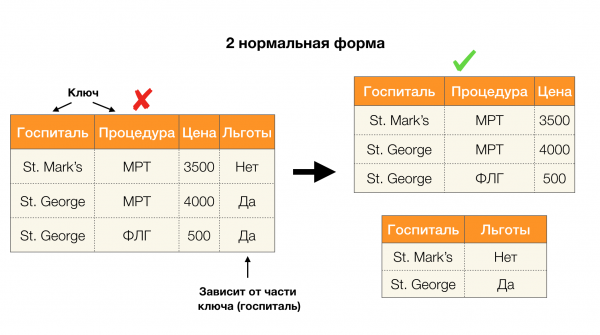
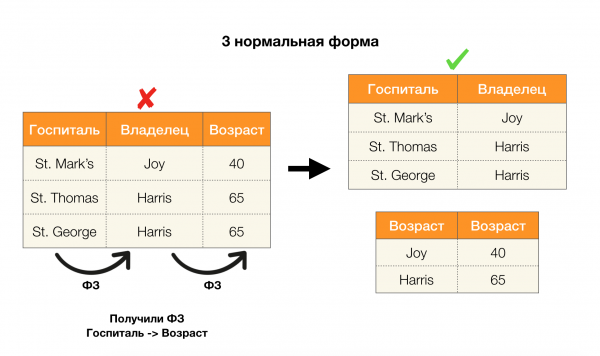
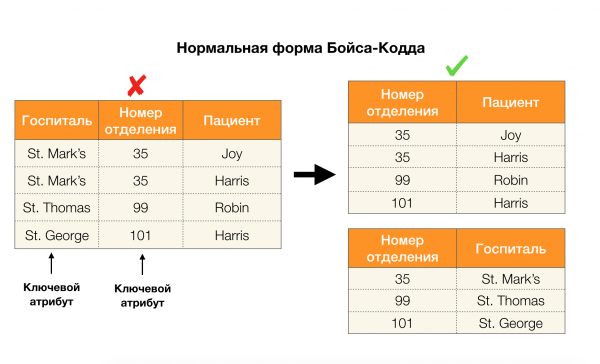
Un autre domaine populaire d'application est la conception de bases de données. Il convient de rappeler les formes normales et la normalisation. La normalisation est le processus d'adaptation d'une relation à un ensemble de critères spécifiques, chacun d'eux étant défini par une forme normale de manière distincte. Nous ne détaillerons pas les critères des différentes formes normales (cela est fait dans n'importe quel livre d'introduction sur les bases de données), mais nous noterons simplement que chacune utilise à sa manière le concept de dépendances fonctionnelles. En effet, les dépendances fonctionnelles sont en soi des contraintes d'intégrité, prises en compte lors de la conception de la base de données (dans le contexte de cette tâche, les dépendances fonctionnelles sont parfois appelées super-clés).
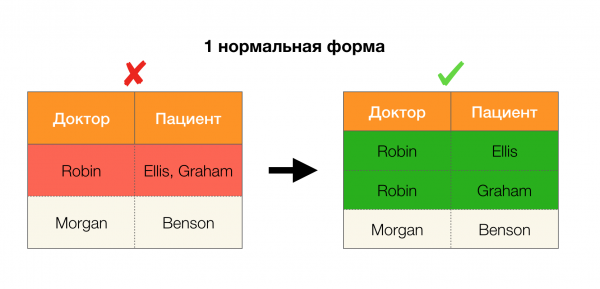
Considérons leur application pour les quatre formes normales sur l'image ci-dessous. Rappelons que la forme normale de Boyce-Codd est plus stricte que la troisième forme, mais moins stricte que la quatrième. Nous ne considérerons pas cette dernière pour l'instant, car sa mise en place nécessite une compréhension des dépendances multivaluées, qui ne sont pas d'intérêt dans cet article.
Un autre domaine où les dépendances ont trouvé leur application est la réduction de la dimensionnalité de l'espace des caractéristiques dans des tâches telles que la construction d'un classificateur bayésien naïf, l'extraction de caractéristiques significatives et la reparamétrisation d'un modèle de régression. Dans les articles originaux, cette tâche est appelée définition des caractéristiques redondantes (feature redundancy) et pertinentes (feature relevancy) [5, 6], et elle est résolue avec l'utilisation active de concepts de bases de données. Avec l'émergence de tels travaux, nous pouvons dire qu'aujourd'hui, il y a une demande pour des solutions permettant de combiner bases de données, analytique et mise en œuvre des problèmes d'optimisation mentionnés ci-dessus en un seul outil [7, 8, 9].
Il existe de nombreux algorithmes (à la fois modernes et moins récents) pour rechercher des dépendances fonctionnelles dans un ensemble de données. Ces algorithmes peuvent être classés en trois groupes :
- Algorithmes utilisant la traversée de treillis algébriques (Lattice traversal algorithms)
- Algorithmes basés sur la recherche de valeurs cohérentes (Difference- and agree-set algorithms)
- Algorithmes basés sur des comparaisons par paires (Dependency induction algorithms)
Une brève description de chaque type d'algorithme est présentée dans le tableau ci-dessous :
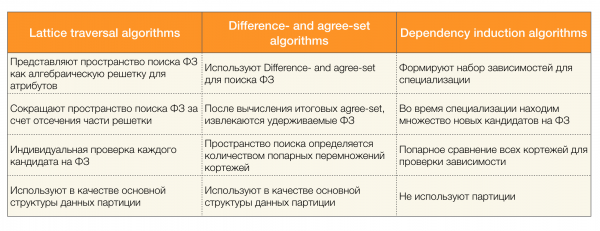
Pour en savoir plus sur cette classification, vous pouvez lire [4]. Voici des exemples d'algorithmes pour chacun des types :
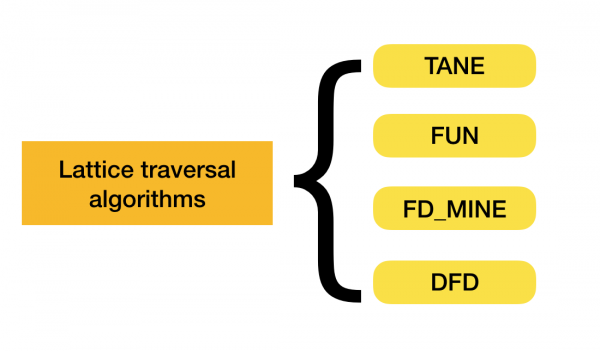
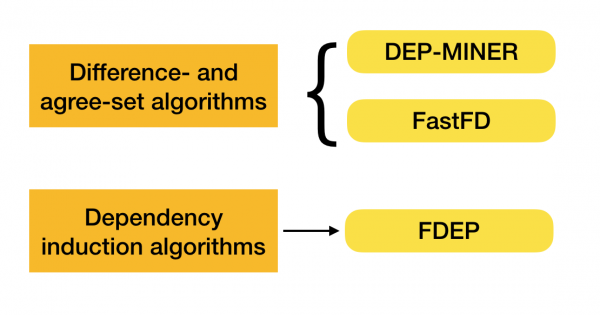
De nouveaux algorithmes apparaissent actuellement, combinant plusieurs approches pour identifier les dépendances fonctionnelles. Des exemples d'algorithmes tels que Pyro [2] et HyFD [3] seront analysés dans les prochains articles de cette série. Dans cet article, nous examinerons uniquement les concepts de base et la lemma nécessaires à la compréhension des techniques de détection de dépendances.
Commçons par les aspects fondamentaux : les ensembles difference et agree-set, utilisés dans le deuxième type d'algorithmes. L'ensemble difference représente un ensemble de tuples qui ne correspondent pas en valeurs, tandis que l'agree-set, à l'inverse, consiste en des tuples qui correspondent en valeurs. Il est important de noter que dans ce cas, nous considérons uniquement la partie gauche de la dépendance.
Un autre concept important mentionné précédemment est la lattic algebra. Comme de nombreux algorithmes modernes fonctionnent avec ce concept, il est nécessaire d'avoir une idée de ce que cela signifie.
Pour introduire le concept de lattic, une définition d'un ensemble partiellement ordonné (ou partially ordered set, abrégé en poset) est nécessaire.
Définition 2. On dit qu'un ensemble S est partiellement ordonné par une relation binaire ⩽, si pour tous a, b, c ∈ S, les propriétés suivantes sont vérifiées :
- Réflexivité, c'est-à-dire a ⩽ a
- Antisymmétrie, c'est-à-dire que si a ⩽ b et b ⩽ a, alors a = b
- Transitivité, c'est-à-dire que pour a ⩽ b et b ⩽ c, il s'ensuit que a ⩽ c
Cette relation est appelée relation (non stricte) d'ordre partiel et l'ensemble lui-même est un ensemble partiellement ordonné. Notation formelle : ⟨S, ⩽⟩.
Comme exemple le plus simple d'un ensemble partiellement ordonné, on peut prendre l'ensemble de tous les nombres naturels N avec la relation d'ordre habituelle ⩽. Il est facile de vérifier que tous les axiomes nécessaires sont satisfaits.
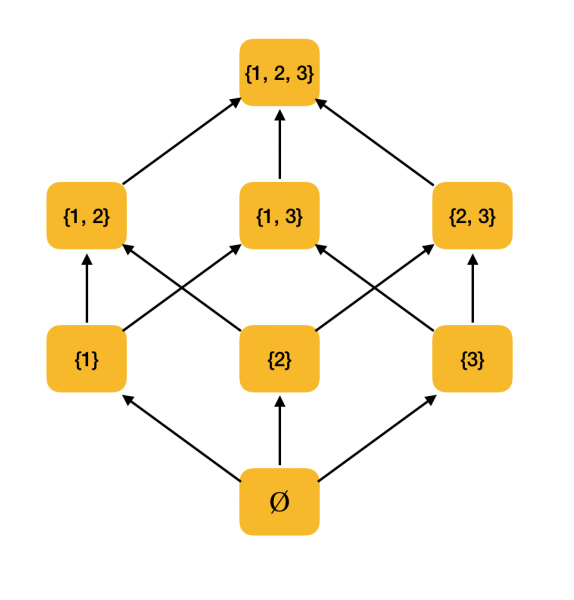
Un exemple plus substantiel. Considérons l'ensemble de tous les sous-ensembles {1, 2, 3}, ordonné par la relation d'inclusion ⊆. En effet, cette relation satisfait toutes les conditions d'un ordre partiel, donc ⟨P({1, 2, 3}), ⊆⟩ est un ensemble partiellement ordonné. L'image ci-dessous illustre la structure de cet ensemble : si l’on peut atteindre un élément à partir d'un autre par les flèches, alors ils sont en relation d'ordre.
Nous aurons besoin de deux autres définitions simples en mathématiques : le suprémum (supremum) et l'infimum (infimum).
Définition 3. Soit ⟨S, ⩽⟩ un ensemble partiellement ordonné, A ⊆ S. La borne supérieure de A est un élément u ∈ S tel que ∀x ∈ S : x ⩽ u. Soit U l'ensemble de toutes les bornes supérieures de S. S'il existe un élément minimal dans U, il est alors appelé suprémum et noté sup A.
De même, le concept de borne inférieure exacte est introduit.
Définition 4. Soit ⟨S, ⩽⟩ un ensemble partiellement ordonné, A ⊆ S. La borne inférieure de A est un élément l ∈ S tel que ∀x ∈ S : l ⩽ x. Soit L l'ensemble de toutes les bornes inférieures de S. S'il existe un élément maximal dans L, il est alors appelé infimum et noté inf A.
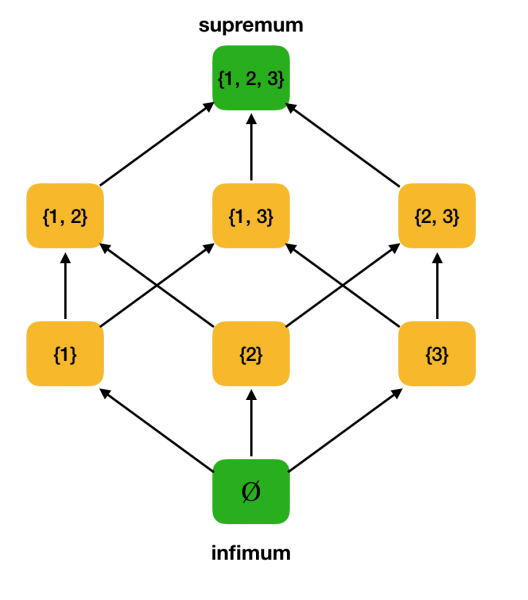
Considérons l'exemple de l'ensemble partiellement ordonné ⟨P ({1, 2, 3}), ⊆⟩ et trouvons en son sein le suprémum et l'infimum :
Nous pouvons maintenant formuler la définition d'une latticielle algébrique.
Définition 5. Soit ⟨P, ⩽⟩ un ensemble partiellement ordonné tel que chaque sous-ensemble de deux éléments possède des bornes supérieures et inférieures exactes. Alors P est appelé latticielle algébrique. On note sup{x, y} comme x ∨ y, et inf{x, y} comme x ∧ y.
Vérifions que notre exemple de travail ⟨P ({1, 2, 3}), ⊆⟩ est bien une latticielle. En effet, pour tous a, b ∈ P ({1, 2, 3}), a ∨ b = a ∪ b, et a ∧ b = a ∩ b. Par exemple, considérons les ensembles {1, 2} et {1, 3} et trouvons leur infimum et suprémum. Si nous les coupons, nous obtenons l'ensemble {1}, qui sera l'infimum. Le suprémum résultera de leur union — {1, 2, 3}.
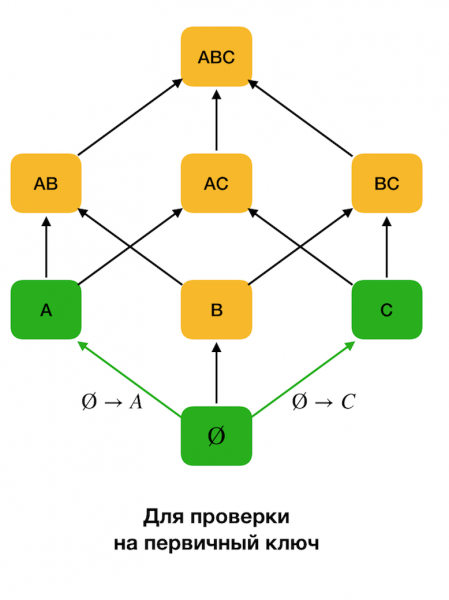
Dans les algorithmes de découverte des dépendances, l'espace de recherche est souvent représenté sous la forme d'une latticielle, où les ensembles d'un seul élément (considérons le premier niveau de la latticielle de recherche, où la partie gauche des dépendances se compose d'un seul attribut) représentent chaque attribut de la relation source.
Au début, on considère des dépendances de type ∅ → Un attribut individuel. Cette étape permet de déterminer quels attributs sont des clés primaires (pour ces attributs, il n'existe pas de déterminants, et donc la partie gauche est vide). Ensuite, ces algorithmes remontent dans la latticielle. Il est à noter que l'on peut ne pas parcourir entièrement la latticielle, c'est-à-dire que si l'on fournit une taille maximale souhaitée pour la partie gauche, l'algorithme ne progressera pas au-delà de ce niveau.
L'illustration ci-dessous montre comment utiliser une grille algébrique dans une tâche de recherche de FD. Ici, chaque arête (X, XY) représente une dépendance X → Y. Par exemple, nous avons passé le premier niveau et savons qu'une dépendance est maintenue A → B (représentons cela par un lien vert entre les sommets A et B). Cela signifie qu'ensuite, lorsque nous avancerons dans la grille, nous pouvons ignorer la dépendance A, C → B, car elle ne sera déjà plus minimale. De même, nous ne la vérifierions pas si la dépendance C → B.
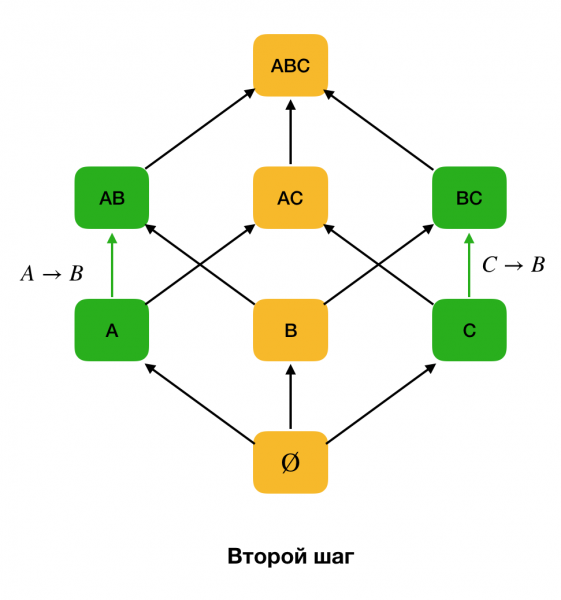
était maintenue. En outre, il est généralement reconnu que tous les algorithmes modernes de recherche de FD utilisent une structure de données appelée partition (dans l'original — stripped partition [1]). La définition formelle d'une partition est la suivante :
Définition 6. Soit X ⊆ R un ensemble d'attributs pour la relation r. Un cluster est un ensemble d'indices de tuples dans r qui ont la même valeur pour X, c'est-à-dire c(t) = {i|ti[X] = t[X]}. Une partition est un ensemble de clusters, excluant les clusters de longueur unitaire :

En termes simples, une partition pour l'attribut X est un ensemble de listes où chaque liste contient les numéros de lignes ayant des valeurs identiques pour X. Dans la littérature moderne, la structure représentant les partitions est appelée index de liste de position (PLI). Les clusters de longueur unitaire sont exclus afin de compresser le PLI, car ce sont des clusters contenant uniquement le numéro d'enregistrement avec une valeur unique, qui sera toujours facile à établir.
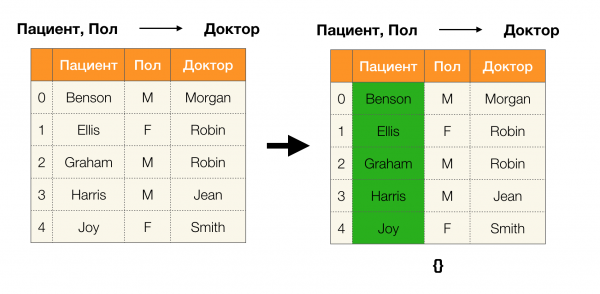
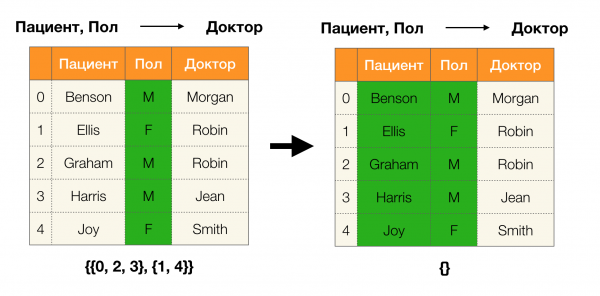
Considérons un exemple. Revenons à la même table avec les patients et construisons des partitions pour les colonnes Patient et Genre (une nouvelle colonne à gauche indique les numéros de ligne de la table) :
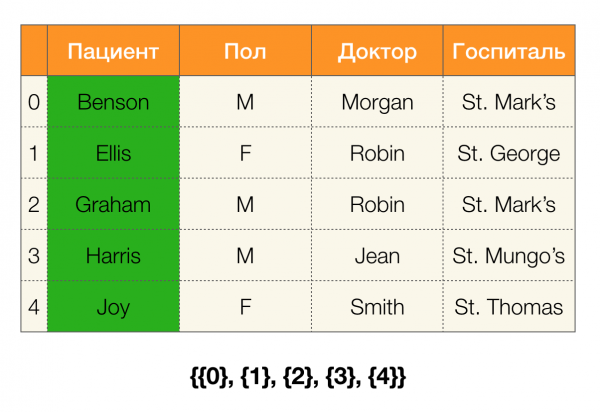
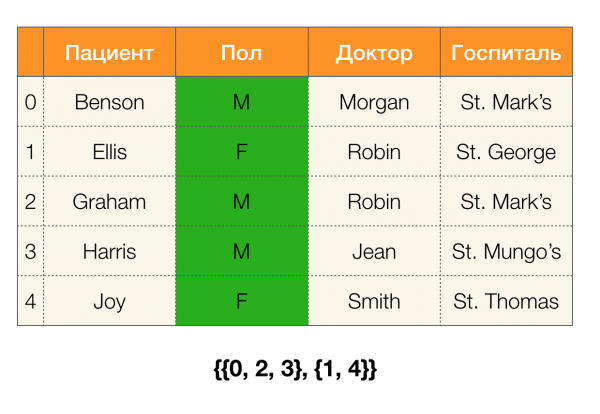
En même temps, selon la définition, la partition pour la colonne Patient sera en fait vide, car les clusters unitaires sont exclus de la partition.
Les partitions peuvent être obtenues par plusieurs attributs. Et pour cela, il existe deux méthodes : parcourir la table et construire la partition immédiatement pour tous les attributs nécessaires, ou bien la construire en utilisant l'opération d'intersection de partitions par sous-ensemble d'attributs. Les algorithmes de recherche de FD utilisent la seconde option.
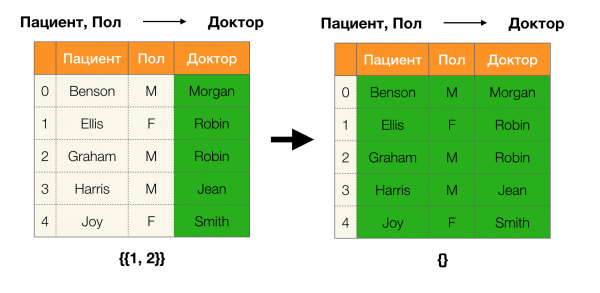
En termes simples, pour obtenir par exemple une partition pour les colonnes ABC, on peut prendre les partitions pour AC et B (ou tout autre ensemble de sous-ensembles non chevauchants) et les croiser entre eux. L'opération de croisement de deux partitions met en évidence les clusters de longueur maximale, communs aux deux partitions.
Prenons un exemple :
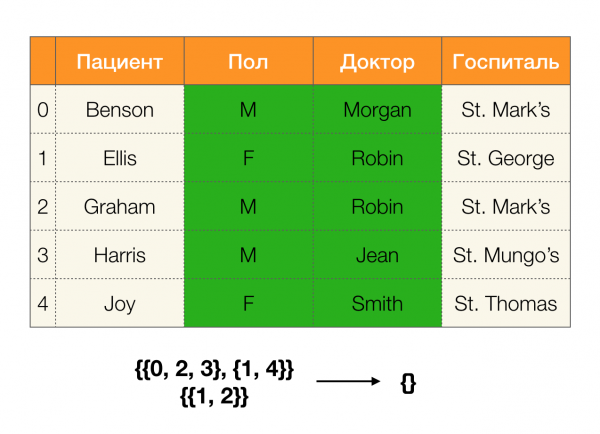
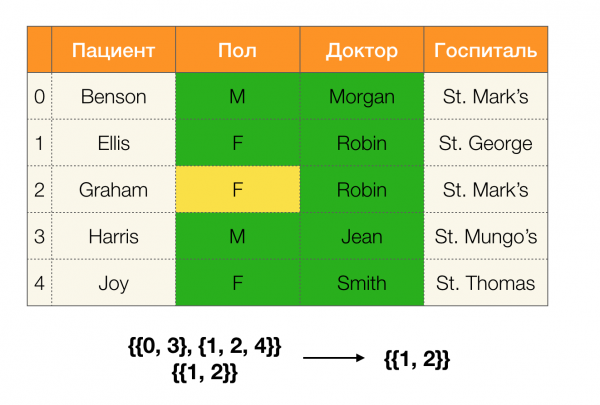
Dans le premier cas, nous avons obtenu une partition vide. En examinant le tableau, il est vrai qu'il n'y a pas de valeurs identiques pour les deux attributs. Si nous modifions légèrement le tableau (cas de droite), nous obtiendrons une intersection non vide. En effet, les lignes 1 et 2 contiennent vraiment des valeurs identiques pour les attributs. Genre et Docteur.
Ensuite, nous aurons besoin d'un concept tel que la taille de la partition. Formulons-le :

En d'autres termes, la taille de la partition représente le nombre de clusters entrant dans la partition (rappelons que les clusters uniques ne sont pas inclus dans la partition !) :
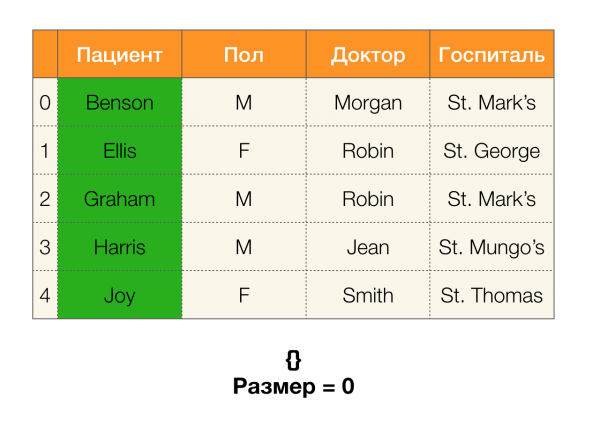
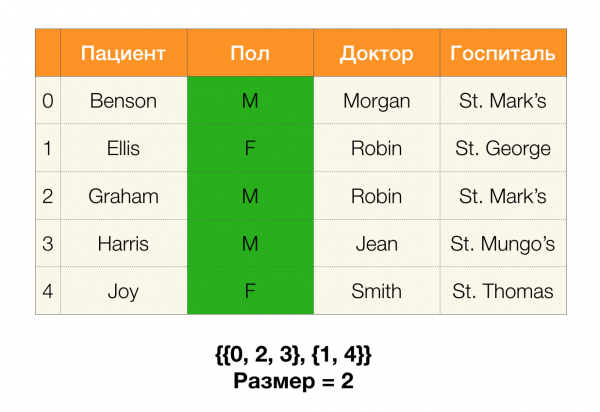
Nous pouvons maintenant définir l'un des lemmes clés qui, pour les partitions données, permet de déterminer si la dépendance est maintenue ou non :
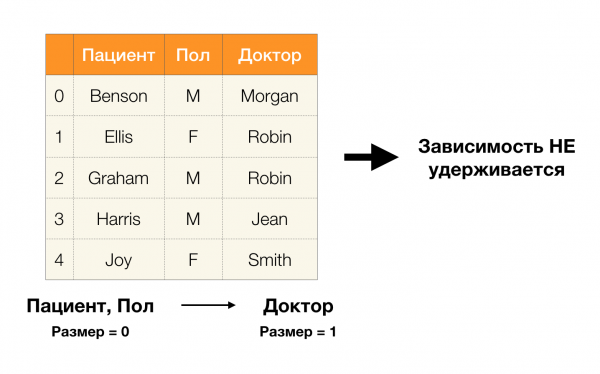
Lemme 1. La dépendance A, B → C est maintenue si et seulement si

Selon le lemme, pour déterminer si la dépendance est maintenue, quatre étapes doivent être réalisées :
- Calculer la partition pour la partie gauche de la dépendance
- Calculer la partition pour la partie droite de la dépendance
- Calculer le produit de la première et de la deuxième étape
- Comparer les tailles des partitions obtenues à la première et à la troisième étape
Voici un exemple de vérification de la maintenance de la dépendance selon ce lemme :
Dans cet article, nous avons examiné des concepts tels que la dépendance fonctionnelle, la dépendance fonctionnelle approximative, et nous avons vu où ils sont appliqués, ainsi que quels algorithmes de recherche de dépendances fonctionnelles existent. Nous avons également détaillé des concepts de base mais importants, largement utilisés dans les algorithmes modernes de recherche de dépendances fonctionnelles.
Références littéraires :
- Huhtala Y. et al. TANE : un algorithme efficace pour découvrir des dépendances fonctionnelles et approximatives // The computer journal. – 1999. – Vol. 42. – No 2. – P. 100-111.
- Kruse S., Naumann F. Découverte efficace de dépendances approximatives // Proceedings of the VLDB Endowment. – 2018. – Vol. 11. – No 7. – P. 759-772.
- Papenbrock T., Naumann F. Une approche hybride pour la découverte de dépendances fonctionnelles // Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – P. 821-833.
- Papenbrock T. et al. Découverte de dépendances fonctionnelles : une évaluation expérimentale de sept algorithmes // Proceedings of the VLDB Endowment. – 2015. – Vol. 8. – No 10. – P. 1082-1093.
- Kumar A. et al. Faut-il joindre ou non ?: Réfléchir à deux fois avant de sélectionner des caractéristiques // Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – P. 19-34.
- Abo Khamis M. et al. Apprentissage en base de données avec des tenseurs clairsemés // Actes du 37e Symposium ACM SIGMOD-SIGACT-SIGAI sur les principes des systèmes de base de données. – ACM, 2018. – P. 325-340.
- Hellerstein J. M. et al. La bibliothèque d'analytique MADlib : ou compétences MAD, le SQL // Actes de la Fondation VLDB. – 2012. – Vol. 5. – No. 12. – P. 1700-1711.
- Qin C., Rusu F. Approximations spéculatives pour l'optimisation de la descente de gradient distribuée à l'échelle terabyte // Actes du Quatrième Atelier sur l'Analytique des Données dans le Cloud. – ACM, 2015. – P. 1.
- Meng X. et al. Mllib : Apprentissage machine dans Apache Spark // Journal de la recherche sur l'apprentissage machine. – 2016. – Vol. 17. – No. 1. – P. 1235-1241.
Les auteurs de l'article : , chercheuse à , et , chercheuse à
Source : habr.com
