

Le lancement de la base de données EdgeDB 2.0 a été annoncé, mettant en œuvre un modèle de données relationnel et graphique ainsi qu'un langage de requêtes EdgeQL, optimisés pour travailler avec des données hiérarchiques complexes. Le code est écrit en Python et Rust (pour le parser et les parties critiques en matière de performance) et est distribué sous la licence Apache 2.0. Le projet évolue sous la forme d'une extension de PostgreSQL. Des bibliothèques clientes sont disponibles pour les langages Python, Go, Rust et TypeScript/Javascript. Un outil de ligne de commande est fourni pour gérer la base de données et exécuter des requêtes de manière interactive (REPL).
EdgeDB utilise une approche déclarative basée sur des types d'objets plutôt qu'un modèle de données basé sur des tableaux. Au lieu de clés étrangères (foreign key) pour définir les relations entre les types, un système de liaison par références est utilisé (un objet peut être employé comme propriété d'un autre objet).
type Person { required property name -> str; } type Movie { required property title -> str; multi link actors -> Person; }
Pour accélérer le traitement des requêtes, des index peuvent être utilisés. Des fonctionnalités telles que la typage strict des propriétés, les contraintes de valeurs des propriétés, les propriétés calculées et les procédures stockées sont également supportées. Parmi les caractéristiques du schéma de stockage orienté objet d'EdgeDB, qui rappelle quelque peu les ORM, on note la possibilité de mélanger les schémas, de lier des propriétés provenant de différents objets et le support intégré de JSON.
Des outils intégrés pour la migration du schéma de stockage sont fournis — après modification du schéma, spécifié dans un fichier esdl séparé, il suffit d'exécuter la commande « edgedb migration create » et la base de données analysera les différences de schéma et générera de manière interactive un script pour passer au nouveau schéma. L'historique des modifications de schéma est automatiquement suivi.
Pour la création de requêtes, le langage de requête GraphQL ainsi que le langage propre à EdgeDB, qui est une adaptation de SQL pour les données hiérarchiques, sont supportés. Au lieu de listes, les résultats de la requête sont formatés de manière structurée, et au lieu de sous-requêtes et d'opérations JOIN, il est possible d'indiquer une requête EdgeQL en tant qu'expression au sein d'une autre requête. Les transactions et les boucles sont pris en charge.
select Movie { title, actors: { name } } filter .title = «The Matrix» insert Movie { title := «The Matrix Resurrections», actors := ( select Person filter .name in { ‘Keanu Reeves’, ‘Carrie-Anne Moss’, ‘Laurence Fishburne’ } ) } for number in {0, 1, 2, 3} union ( select { number, number + 0.5 } );
Dans la nouvelle version :
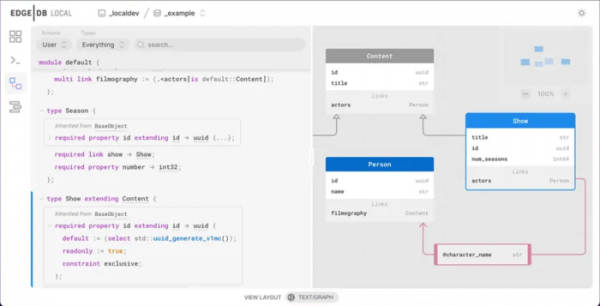
- Une interface web intégrée pour l'administration de la base de données a été ajoutée, permettant de visualiser et d'éditer les données, d'exécuter des requêtes EdgeQL et d'analyser le schéma de stockage appliqué. L'interface se lance avec la commande «edgedb ui», après quoi elle est accessible via localhost.

- La fonction «GROUP» a été implémentée, permettant de partitionner et d'agréger des données ainsi que d'effectuer des regroupements de données selon des expressions EdgeQL arbitraires, similaire au regroupement dans l'opération SELECT.
- Gestion des accès au niveau des objets. Les règles d'accès sont définies au niveau du schéma de stockage et permettent de limiter l'utilisation d'un ensemble spécifique d'objets dans les opérations de sélection, d'insertion, de suppression et de mise à jour. Par exemple, une règle peut autoriser la mise à jour d'un article uniquement par son auteur.
- Ajout de la possibilité d'utiliser des variables globales dans le schéma de stockage. Une nouvelle variable globale current_user a été proposée pour lier à l'utilisateur.
- Ajout de la prise en charge des types définissant des plages de valeurs (range).
- Une bibliothèque cliente officielle pour le langage Rust a été préparée.
- Le protocole binaire EdgeDB a été stabilisé, permettant la gestion simultanée de plusieurs sessions différentes au sein d'une seule connexion réseau, le passage via HTTP, l'utilisation de variables globales et d'états locaux.
- Ajout du support de l'activation par socket, permettant de ne pas garder le traitement du serveur en mémoire et de ne l'exécuter que lors de la tentative d'établissement d'une connexion (utile pour économiser des ressources sur les systèmes des développeurs).
Source : opennet.ru
