

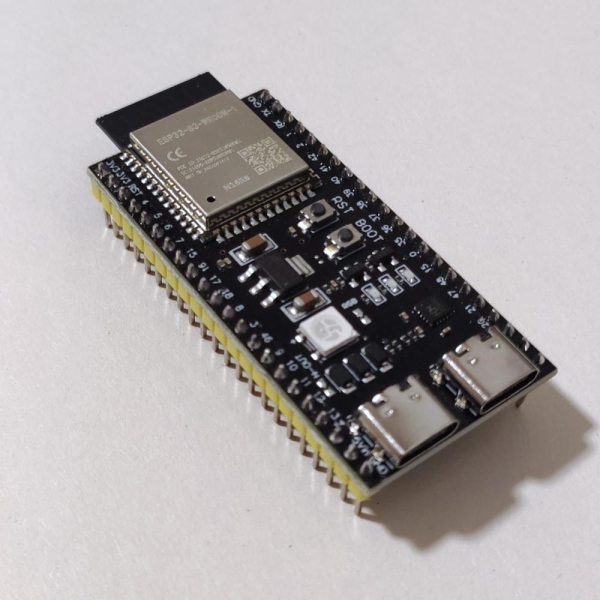
Le développeur Viatcheslav Serbov, utilisant le pseudonyme slvDev, a démontré une génération de texte entièrement locale sur le microcontrôleur ESP32-S3. Le modèle linguistique qu'il a créé contient 28,9 millions de paramètres et produit environ 9,9 jetons par seconde, sans faire appel à un serveur ou à d'autres ressources de calcul externes. Les histoires courtes générées sont affichées sur un écran OLED connecté.
Projet esp32-ai a été testé sur le module ESP32-S3 N16R8, qui dispose de 512 Ko de SRAM intégrée, de 8 Mo de PSRAM et de 16 Mo de mémoire flash. Le modèle quantifié à quatre bits occupe 14,9 Mo. Le code source de l'environnement d'exécution en C, les outils d'entraînement et de quantification du modèle, le firmware, les tests et les scénarios de chargement sur la carte sont publiés dans le référentiel.
Les 28,9 millions de paramètres déclarés ne doivent pas être directement comparés avec le nombre de paramètres des LLM de bureau classiques. Selon le rapport détaillé du développeur, le modèle se compose d'un noyau de calcul dense d'environ 559 000 paramètres, d'une couche de sortie de 3,1 millions de paramètres et d'une table de représentations vectorielles par couche d'environ 25 millions de paramètres. C'est cette dernière qui fournit la majeure partie de la taille formelle du modèle, mais elle n'est pas entièrement traitée lors de la génération de chaque jeton.
Pour le déploiement du modèle, trois niveaux de mémoire sont utilisés. Les données les plus fréquemment utilisées sont stockées dans la SRAM interne, la couche de sortie, le cache KV et les tampons temporaires dans la PSRAM, tandis que la table de 25 millions reste en mémoire flash et est accessible par mappage dans l'espace d'adresses. Pour chaque jeton, environ six lignes, totalisant environ 450 octets, sont lues.
Ce dispositif est basé sur la technologie Per-Layer Embeddings, appliquée par Google dans Gemma 3n. Selon la documentation de Google, les paramètres PLE peuvent être stockés en dehors de la mémoire de travail du modèle et ajoutés au processus de sortie à mesure que chaque couche est traitée. Dans esp32-ai, cette approche a été transférée à la hiérarchie de mémoire du microcontrôleur, où la SRAM rapide est particulièrement limitée.
La première version correcte de l'environnement d'exécution écrit en C ne produisait que 0,57 jeton par seconde. Après avoir placé la couche de sortie dans la PSRAM, en passant à des activations de huit bits, en répartissant les calculs entre deux cœurs Xtensa LX7 et d'autres optimisations, la latence a été réduite à 94,9 ms par étape du modèle. La vitesse mesurée finale a atteint 9,88 jetons par seconde, en tenant compte de l'ensemble du processus de génération. La principale limitation est maintenant la bande passante de la PSRAM lors de la lecture de la couche de sortie.
Le modèle a été entraîné sur un ensemble de données synthétiques TinyStories, constitué de récits simples en anglais avec un vocabulaire limité. Il est donc capable de poursuivre des phrases et d'inventer de petites histoires cohérentes, mais n'est pas conçu pour répondre à des questions, exécuter des instructions, programmer ou reproduire des connaissances factuelles. Le développeur considère le travail avant tout comme une démonstration d'un placement efficace du modèle dans la mémoire d'un microcontrôleur, et non comme un chatbot autonome prêt à l'emploi.
Dans la documentation actuelle, l'auteur souligne séparément que esp32-ai est un développement indépendant. Les projets llama2.c d'Andrei Karpathy et un précédent lancement d'un modèle de 260 000 paramètres sur l'ESP32-S3 ne sont mentionnés que comme des repères et des exemples de travaux antérieurs : le code, les points de contrôle et la méthodologie ne sont pas directement empruntés à ceux-ci. Le code source de esp32-ai est distribué sous licence MIT.
Source : linux.org.ru
